


Knowledge Catalog הוא שכבת הקשר שמבוססת על Gemini. הוא מספק הקשר עסקי אוניברסלי ויכולות פעילות של עיגון בנתונים בכל מאגר הנתונים שלכם. הוא עוזר לצוותי נתונים ולמפתחים לגלות נכסים, לאמת את איכות הנתונים ולבסס באופן מאובטח אפליקציות AI גנרטיבי כדי לצמצם הזיות. לשם כך הוא יוצר גרף הקשר דינמי מנתונים מובנים ולא מובנים.
הדרכה מפורטת על Knowledge Catalog זמינה בסרטון הבא:
קהל ודרישות מוקדמות
הסקירה הכללית הזו מיועדת למהנדסי נתונים והקשר, למדעני נתונים, למנהלי נתונים ולמפתחי AI. לפני שמשתמשים ב-Knowledge Catalog, צריך:
היכרות עם מערכות אחסון ומסדי נתונים, כמו BigQuery או Cloud Storage.
הבנה בסיסית של מושגים ב-AI גנרטיבי, כמו יצירה עם שליפה משופרת (RAG) או Model Context Protocol (MCP).
פתרון בעיות של מורכבות נתונים ספציפית לתעשייה
בארגונים מודרניים, הנתונים מורכבים, מפוזרים מאוד וקיימים בפורמטים מובנים ולא מובנים. בדרך כלל, בקשות עסקיות לא ממופות לסכימת מסד נתונים יחידה או למאגר מסמכים. התאמה מאובטחת בין מאגרי המידע האלה, תוך מתן תשובות מיידיות ומהימנות לשאלות שחוצות תחומים, היא אתגר תפעולי משמעותי.
Knowledge Catalog משמש כבסיס סמנטי שמגשר על הפער הזה, ומאפשר לסוכני AI ולכלי ניתוח נתונים לאחזר הקשר מעוגן בנתונים ורלוונטי.
תפקידי משתמשים מרכזיים
מהנדסי הקשר (מהנדסי נתונים). אוטומציה של צבירת מטא-נתונים במסדי נתונים וב-Cloud Storage, מעקב אחר טרנספורמציות באמצעות שושלת נתונים ויצירת תהליכי עבודה להעשרה ולהערכה.
נאמני מידע (צוותי משילות). כדי לשמור על איכות המטא-נתונים, אפשר להשתמש בביקורות אנושיות של תיאורים שנוצרו על ידי AI, ליצור מילוני מונחים כדי לתקנן את אוצר המילים העסקי ולהגדיר היבטים מותאמים אישית כדי לצרף הקשר ספציפי לתחום לרשומות בקטלוג.
מפתחי AI. הקרקוע של מודלים גדולים של שפה (LLM) ושל אפליקציות AI עם סכימות נתונים ארגוניות מהימנות באמצעות שרתי MCP או ממשקי API לאחזור הקשר.
תרחישי שימוש בתחומים שונים
בטבלה הבאה מפורטות שאלות מורכבות שעולות בפועל, איך הן חוצות גבולות טכניים ואיך Knowledge Catalog עוזר לארגונים להתמודד איתן:
| ענף | אתגרים שקשורים לנתונים ולתפעול | בעיה עסקית שצריך לפתור | איך Knowledge Catalog פותר את הבעיה |
|---|---|---|---|
| מסחר אלקטרוני |
|
"תמצא מוצרי אלקטרוניקה עם שיעורי החזרה גבוהים ותמונות של לקוחות שבהן נראים סימני נזק כשהמוצר מגיע." | הצמדה סמנטית בפורמטים שונים של נתונים: המערכת מגלה באופן אוטומטי מטא-נתונים ממסדי נתונים טרנזקציוניים ומקשרת אותם לתמונות לא מובְנות בקטגוריות אחסון ב-Cloud Storage, וכך מאפשרת לכלי AI לפתור את השאילתה במערכות אחסון שונות. |
| ייצור |
|
"תצור סיכומים לכל דוחות הבדיקה שקשורים למכונות באזור המערבי שנכשלו בבדיקות הבטיחות ברבעון האחרון". | סריקה אזורית ולא מובנית: סריקה וקטלוג של דוחות בדיקה לא מובנים בפורמט PDF לצד מטא-נתונים של נכסים, כדי לאפשר לסוכני AI גנרטיבי לאתר, לקמפל ולסכם דוחות לפי אזור. |
| שירותי בריאות |
|
"אילו מטופלים נמצאים בסיכון הכי גבוה לאשפוז חוזר תוך 30 יום, בהתבסס על נתונים עדכניים של בדיקות מעבדה ועל תדירות הפגישות?" | איכות הנתונים ושושלת הנתונים: חישוב פרופיל איכות הנתונים ברמת השורה ומיפוי שושלת הנתונים שלהם בכל פיד של סיכום מצב בריאותי אלקטרוני, כדי לוודא שמודלים קליניים לחיזוי מסתמכים רק על סימנים חיוניים מאומתים ובאיכות גבוהה של המטופלים. |
| שירותים פיננסיים |
|
"אילו מתוך 10 הלקוחות המובילים שמניבים הכי הרבה הכנסות התלוננו על 'בעיות בביצועים', ואיך זה משפיע על התחזיות לרבעון השלישי?" | גרף הקשר המאוחד: מאחד רשומות של לקוחות, משוב על תמיכה וטבלאות פיננסיות, ומאפשר לשאילתות בשפה טבעית לצרף נתונים סטטיסטיים על הכנסות של לקוחות לקובצי משוב לא מובנים כדי לחזות את ההשפעה הפיננסית. |
כדי להתמודד עם האתגרים התפעוליים האלה, Knowledge Catalog מספק יכולות מרכזיות שעוזרות למהנדסי נתונים, למדעני נתונים ולמפתחי AI לבנות מערכות נתונים מנוהלות:
הארקה של סוכני AI באמצעות Model Context Protocol (MCP). אפשר לחשוף מטא-נתונים, סכימות, שושלת וכללים עסקיים ישירות לסוכני AI באמצעות שרתי MCP מקומיים או מרוחקים. השרתים האלה מאפשרים למודלים לאמת ציפיות תפעוליות לפני שהם מציעים פעולות.
מגלים תובנות מהר יותר בעזרת AI וניתוח נתונים. חיפוש נכסי נתונים רלוונטיים באמצעות חיפוש סמנטי בשפה טבעית. סיכומים והמלצות גנרטיביים עוזרים למשתמשים לאתר נתונים בלי לחכות לבדיקות ידניות של מסמכים.
שליטה במוצרי נתונים בהיקף נרחב. אפשר לארוז אוספים של נכסים עם הסכמי רמת שירות (SLA), חוזים, פרטי בעלות והערות שימוש ליחידות מנוהלות יחידות לחיפוש ולמינוי.
איך Knowledge Catalog עובד
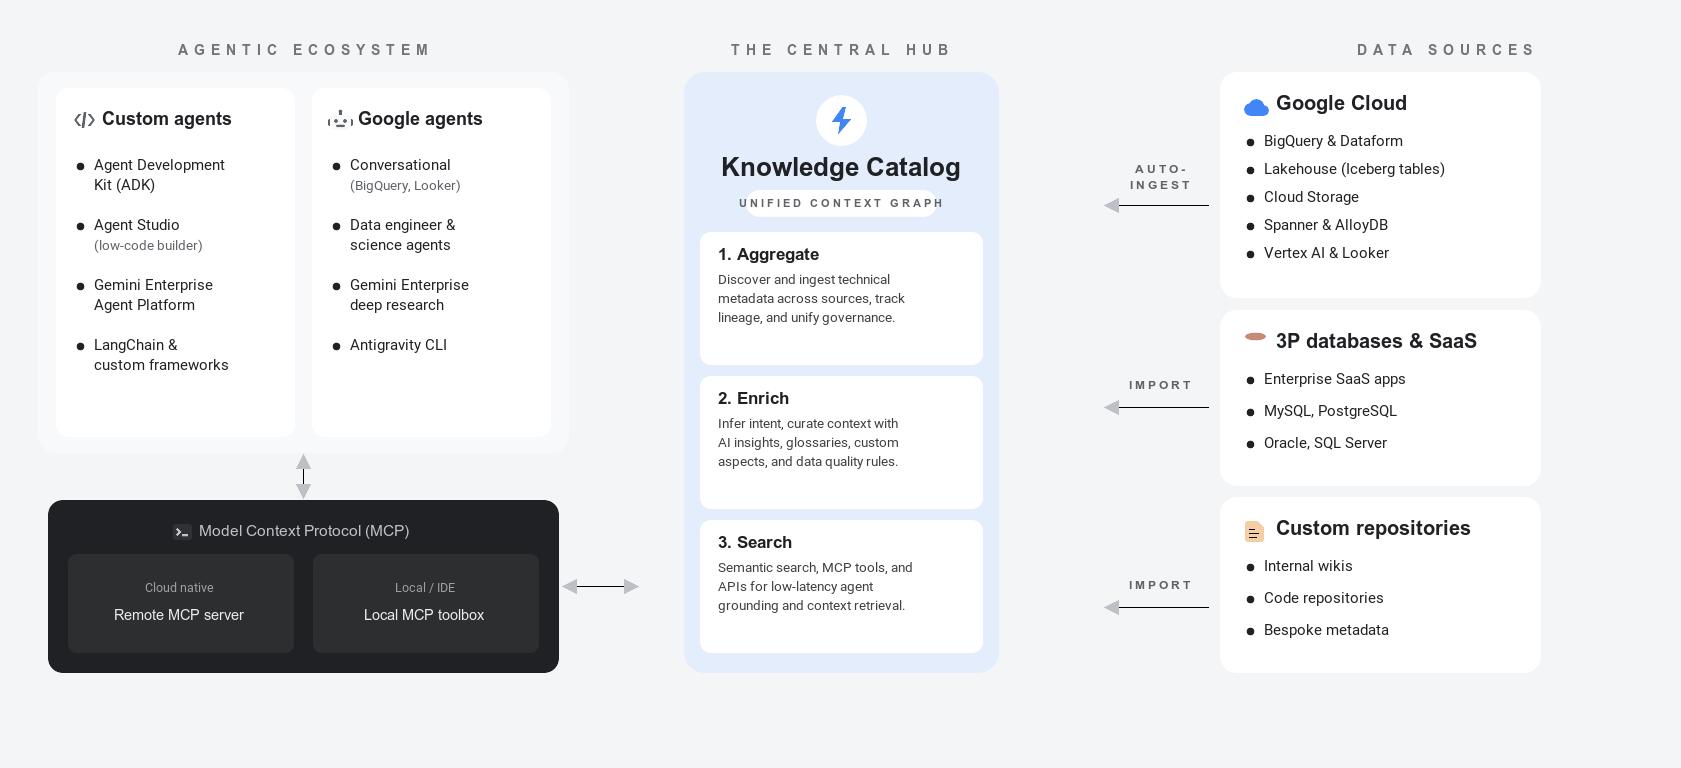
Knowledge Catalog מאחד את ניהול הנתונים וההקשר באמצעות מחזור חיים שמבוסס על שלושה עקרונות. הדיאגרמה הבאה ממחישה איך השירות ממפה נכסי נתונים פיזיים לסמנטיקה עסקית לצורך עיגון של סוכני AI:
מידע נוסף על מושגי המטא-נתונים האלה זמין במאמר מידע על מטא-נתונים.
בקטעים הבאים מתוארים שלושת עמודי התווך של מחזור החיים של המטא-נתונים, ומוסבר איך חברה קמעונאית מיישמת אותם על טבלאות מסד נתונים, קבצים ורשומות קטלוג חיצוניות:
צבירה (ב-Discover ובכלי להעלאת נתונים). Knowledge Catalog סורק ומבצע אינדוקס אוטומטי של מטא-נתונים טכניים בכל נכסי הנתונים שלכם בלי להעביר את הנתונים הבסיסיים:
- מסדי נתונים מובנים. תהליך קטלוג אוטומטי מתעד סכימות ומאפיינים בפלטפורמות כמו BigQuery, AlloyDB ל-PostgreSQL ו-Spanner.
- קישוריות מנוהלת. הגדרות של נתונים נכנסים ממערכות חיצוניות, כמו Oracle או PostgreSQL, או ממאגרי מידע של שותפים, כמו Collibra, בלי לכתוב צינורות נתונים בהתאמה אישית.
- שושלת נתונים. אפשר לעקוב אחרי שינויים ברמת העמודה בצינורות שונים כדי לראות מאיפה הנתונים מגיעים ואיך הם השתנו.
- דוגמה: חברה קמעונאית מבצעת באופן אוטומטי הטמעה של מטא-נתונים של מסד נתונים טרנזקציוני, כמו טבלאות
ordersו-order_items, ומבצעת אינדוקס של קובצי מוצרים לא מובְנים שמאוחסנים בקטגוריות של Cloud Storage. הם מקשרים בין מסדי נתונים חיצוניים כדי ליצור אינדקס מאוחד של מטא-נתונים בספרייה שאפשר לגלות.
מידע נוסף על צבירת מטא-נתונים והטמעת נתונים (לחצו להרחבה)
- מקורות נתונים נתמכים: רשימה של כל המקורות הפנימיים Google Cloud והחיצוניים הנתמכים להעברה אוטומטית.
- סקירה כללית על קישוריות מנוהלת: הסבר על הטמעה של סכימות טכניות ממערכות חיצוניות.
- מעקב אחרי מקורות הנתונים: הסבר על האופן שבו אפשר להציג חזותית את השינויים בצינורות הנתונים ברמת העמודה ואת זרימת הנתונים.
העשרה (יצירת הקשר ואימות האמינות). Knowledge Catalog מוסיף משמעות עסקית למבנים טכניים ומגדיר אותות אמון:
- תובנות שנוצרו על ידי AI. Gemini מנתח יומני שאילתות כדי ליצור תיאורי עמודות, סיכומי טבלאות והמלצות לצירופים.
- מילוני מונחים והיבטים. מיפוי של שמות מדדים פנימיים לאוצר מילים משותף באמצעות מונחים עסקיים ותבניות לוגיות.
- איכות הנתונים וזיהוי אנומליות. אכיפת הנחיות לניקוי נתונים והרצת סריקות של למידת מכונה כדי לזהות חריגות סטטיסטיות או בעיות ברעננות הנתונים, וכך ליצור אותות מהימנות מרכזיים.
- ביקורות בנושא ניהול. כדי לנהל את הסיכון, כדאי להשתמש בתהליכי בדיקה של תהליכי עבודה כדי לאמת עדכונים של מטא-נתונים לפני הפרסום.
- דוגמה: צוות הקמעונאות מעשיר נכסים על ידי הפעלת תובנות לגבי נתונים כדי להמליץ על תיאורי עמודות, והפעלת כללים של איכות נתונים. הם ממפים הגדרות עסקיות להזמנות פעילות על ידי יצירת מילוני מונחים והיבטים.
מידע נוסף על העשרת מטא-נתונים ואימות מהימנות (לחצו להרחבה)
- הגדרת תובנות לגבי נתונים: במאמר הזה מוסבר איך ליצור תיאורים וסיכומים אוטומטיים של מערכי נתונים.
- ניהול מילוני מונחים עסקיים: במאמר הזה מוסבר איך להתאים אישית מונחים סטנדרטיים ולקסיקונים עסקיים.
- העשרת מטא-נתונים באמצעות היבטים: במאמר הזה מוסבר איך לצרף מאפיינים של מטא-נתונים מובְנים לנכסים לוגיים.
- שימוש חוזר בכללים לאיכות הנתונים: במאמר הזה מוסבר איך ליצור כללי אימות למסד נתונים ולעשות בהם שימוש חוזר.
- סקירה כללית של פרופיל נתונים: הסבר על הגדרת סריקות לאיתור אנומליות בסכימה וסחיפה סטטיסטית.
חיפוש ואחזור (גישה וקרקע). אפליקציות AI ומשתמשים עסקיים שולחים שאילתות לגרף ההקשר המאוחד כדי לגשת לנתונים בצורה בטוחה:
- הסוכנים פועלים לפי נתונים. לקשר את האפליקציות והסוכנים שמבוססים על LLM לקטלוג.
- Context API. ביצוע בקשות מטען ייעודי (payload) להארקה עם זמן אחזור נמוך.
- חיפוש סמנטי. מציאת הנכסים המתאימים באמצעות שאילתות בשפה טבעית.
- חבילות נתונים. חבילות של טבלאות, פרטי רישוי והסכמי רמת שירות (SLA) בחבילות נתונים מאובטחות בשירות עצמי.
- דוגמה: אנליסטים מבצעים חיפושים סמנטיים בשפה טבעית כדי לאתר נכסים. אפליקציות מבוססות-AI צורכות את האינדקס הזה בצורה מאובטחת באמצעות שרתי MCP או API לאחזור הקשר, ונכסים באיכות גבוהה נארזים בתצוגה מאובטחת.
מידע נוסף על אחזור הקשר ועל ביסוס הסוכן (לחצו כדי להרחיב)
- סקירה כללית על Model Context Protocol (MCP): הסבר על הדרך לגשר בין סוכני AI גנרטיביים ושכבות אפליקציה לבין הקשר של Knowledge Catalog.
- שליפת הקשר באמצעות LookupContext: במאמר הזה מוסבר איך לחלץ נתוני הפעלה חשובים להנחיית הסוכן.
- חיפוש נכסים: תיאור של יכולות חיפוש נכסים באמצעות תחביר של שאילתות סמנטיות בשפה טבעית.
Knowledge Catalog ב- Google Cloud ובסביבה העסקית של AI
כדי לבנות בסיס נתונים, חשוב להבין איך Knowledge Catalog משתלב עם שירותים קשורים.
Google Cloud מסדי נתונים ומודלים
- BigQuery. Knowledge Catalog סורק ומאנדקס באופן אוטומטי מערכי נתונים, טבלאות ותצוגות של BigQuery. הוא מפעיל תובנות מבוססות-נתונים מ-Gemini כדי לנתח את היסטוריית השאילתות, לפרסם תיאורים ולהציע שאילתות לדוגמה מאומתות.
- Looker (Google Cloud core). מערכת Knowledge Catalog מבצעת המרה של לוחות בקרה, תצוגות ומבנים של LookML, כמו תצוגות, ניתוחים, מאפיינים ומדדים. ההטמעה הזו יוצרת מיפויים של שושלת כדי לעקוב אחרי האופן שבו ערכים תפעוליים ממופים לסמנטיקה עסקית.
- קטלוג ייעודי לזמן ריצה של Lighthouse. Knowledge Catalog משתלב עם Lighthouse, מאגר המטא-נתונים בזמן הריצה של עומסי עבודה של Iceberg בקוד פתוח. הוא מבצע אוטומטית אינדוקס של מטא-נתונים טכניים בנוסף לעומסי העבודה של Lighthouse כדי לספק הקשר פעיל מאוחד.
פלטפורמות סוכני AI ועוזרים
- ניתוח נתוני השיחות. ממשקי הניתוח משתמשים במונחים מהקטלוג ובכלי חיפוש כדי לאפשר למשתמשים לשאול שאלות על מדדים עסקיים בשפה טבעית עם ביסוס מאומת.
- Gemini לסוכני AI. סוכני עזר עם דיוק גבוה משתמשים במטא-נתונים של הקטלוג כדי להריץ חיפושים במסד הנתונים, וכך מצמצמים את ההזיות.
- Gemini Enterprise Agent Platform. Knowledge Catalog משמש כסטנדרט מרכזי לניהול נתונים בסביבות של פלטפורמות יעד. הוא מקושר לפלטפורמת הסוכנים של Gemini Enterprise כדי לספק כלים והקשר ל-Agent Registry של הפלטפורמה.
שילוב של מסד נתונים ושירות AIGoogle Cloud
Knowledge Catalog פועל לצד מוצרים אחרים של Google Cloud Google כדי ליצור את בסיס הנתונים שלכם. בטבלה הבאה מודגמת האינטגרציה של Knowledge Catalog עם שירותים קשורים והאופן שבו הוא משלים אותם:
| שירות | תפקיד ראשי | איך הוא משתלב עם Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | פיקוח והקשר של סוכנים | הוא משמש כתרשים מאוחד של הקשר הסמנטי, מבצע סריקות של בדיקות איכות הנתונים וחושף סכימות מבוססות למודלים וליישומים של AI. |
| BigQuery | מחסן נתונים ארגוני | מאחסן, שולח שאילתות ומעבד מערכי נתונים; סורק, מאנדקס ומעשיר את הטבלאות האלה באופן אוטומטי בהיבטים של סיווג עסקי. |
| Vertex AI | פיתוח מודלים של AI | בנייה, פריסה ואירוח של מודלים בסיסיים. סוכנים מותאמים אישית מאחזרים הקשר של מטא-נתונים כדי לבסס את ההיגיון שלהם. |
| Cloud Storage | אחסון קבצים לא מובנה | אחסון של קבצים גולמיים לא מובְנים; הפעלת סריקות לא מובְנות של גילוי באופן אוטומטי כדי לנתח קובצי PDF ותמונות ולבנות מפות קשרים. |
סמנטיקה ופורמטים של נתונים
כדי לתת הנחיות למערכות מבוססות-סוכנים ולהנחות אותן בצורה יעילה, צריך להבחין בין מבנה נתונים פיזי לבין משמעות סמנטית:
- סמנטיקה. המשמעות העסקית, הכוונות והקשרים שמשויכים לנתונים. סכימות טכניות מגדירות מפרטים של אחסון מבני, כמו סוג מסד נתונים, אורך תווים או אילוץ של מספר שלם, אבל סמנטיקה מתארת את מה שמערך הנתונים מייצג בפועל. לדוגמה, אפשר למפות עמודה בשם
txn_qtyלהגדרה העסקית של 'כמות שנרכשה'. - נתונים מובְנים. מידע שמאוחסן בסכימות מוגדרות ובפורמטים יחסיים. לדוגמה, טבלאות BigQuery, מסדי נתונים של Spanner וטבלאות תפעוליות של Postgres. Knowledge Catalog סורק אוטומטית את המטא-נתונים האלה ומתעד עמודות ואילוצים.
תזמור הקשר ב-Agentic Data Cloud
במסגרת Agentic Data Cloud של Google, Knowledge Catalog משמש כמישור של תזמור סמנטי. במקום לדרוש ממפתחים להגדיר באופן ידני סכימות של מסדי נתונים וכללים בהנחיות, מנוע ההקשר מספק באופן דינמי את ההקשר הסמנטי המדויק שסוכן צריך כדי לקבל החלטות חכמות.
באיור הבא מוצג איך Knowledge Catalog מתזמן ומספק הקשר נתונים:
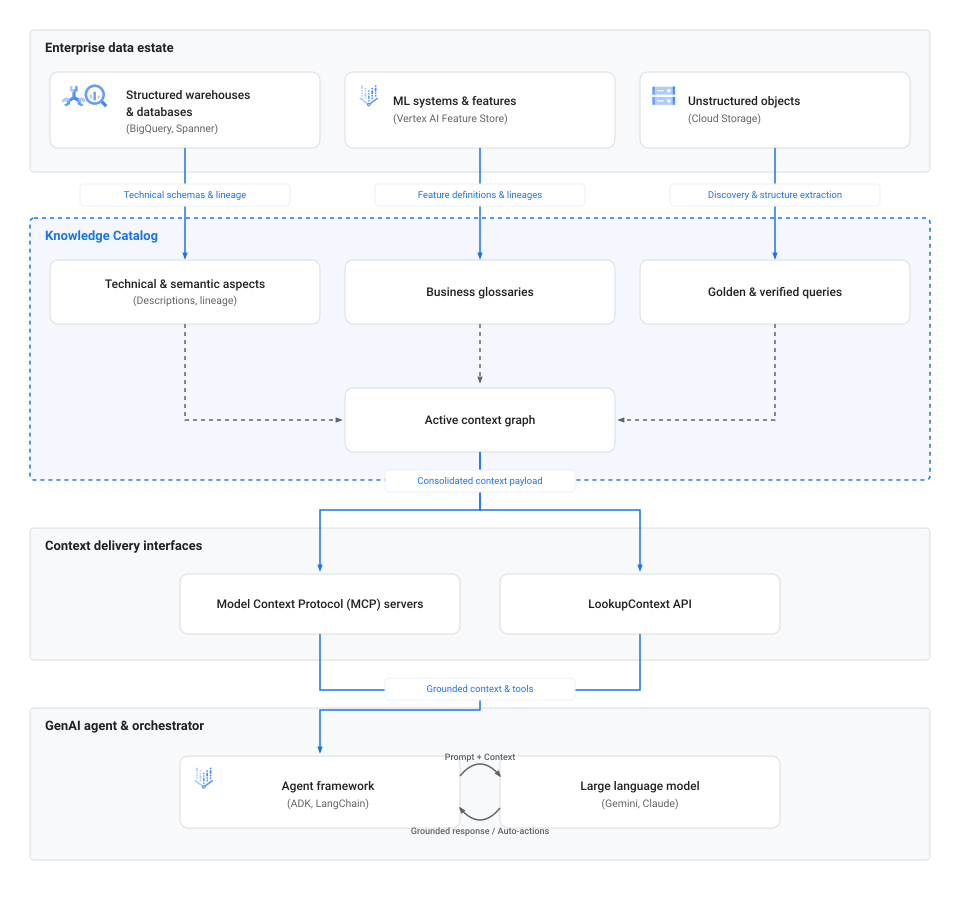
תהליך העבודה של תזמור ההקשר מורכב מהשלבים הבאים:
- הטמעה וגילוי. מסדי נתונים תפעוליים, מחסני נתונים כמו Spanner ו-BigQuery, מאגרי אובייקטים לא מובנים כמו Cloud Storage ומאגרי מטא-נתונים בזמן ריצה כמו Lighthouse מעבירים סכימות טכניות, מפות שושלת והגדרות מטא-נתונים ישירות אל Knowledge Catalog.
- מיפוי הקשר. ב-Knowledge Catalog, מאפייני המטא-נתונים האלה מקושרים לרכיבים סמנטיים, כולל היבטים טכניים, מילוני מונחים עסקיים ושאילתות מאומתות, כדי ליצור את גרף ההקשר הפעיל.
- ממשקי מסירה. אפליקציות מבוססות-AI וכלים לניהול תהליכים מאחזרים את גרף ההקשר המאוחד הזה באופן פרוגרמטי באמצעות מחברים סטנדרטיים, כמו MCP או נקודות קצה (endpoints) ישירות של
LookupContextAPI. - הארקה של סוכן. פלטפורמות תזמור, כמו Agent Development Kit (ADK) או LangChain, מזריקות את הקשר של המטא-נתונים הזה ישירות להנחיות של מודלים גדולים של שפה (LLM). ההחדרה הזו מעגנת את החשיבה הרציונלית של הסוכן בכללים ארגוניים מאומתים, וכך הוא יכול לשלוח שאילתות למסדי נתונים או לבצע פעולות אוטומטיות בלי הזיות.
פרופילים של סוכני AI
בהתאם לתהליכי העבודה שרוצים להפוך לאוטומטיים, אפשר ליצור סוגים שונים של סוכנים שמבוססים על Knowledge Catalog:
- סוכני גילוי נתונים. העוזרים האלה עוזרים למשתמשים לחפש בנכסי הנתונים ולנווט בהם. במקום להשתמש בהתאמה למילות מפתח, הם מנתחים כוונות ומגבלות בשפה טבעית כדי לאחזר את הנכסים הפיזיים הרלוונטיים ביותר.
- סוכני העשרה של מטא-נתונים. סוכני הרקע האלה מעבדים טקסט לא מובנה מתוך ויקי, קובצי README או יומני צ'אט, מנתחים את הטקסט למטא-נתונים רשמיים וכותבים את המטא-נתונים כ-aspects ב-Knowledge Catalog כדי לשמור על עדכניות המטא-נתונים.
- איכות הנתונים וסוכני צינורות העיבוד. הסוכנים האוטונומיים האלה מעריכים כללי איכות, מזהים סחיפה של סכימות ויוצרים או מתקנים צינורות להמרת נתונים על ידי שליחת שאילתות לגבי שושלת הנתונים וסטטיסטיקות הפרופיל.
כלי תזמור
כדי ליצור את הסוכנים האלה ולשלב אותם, אפשר להשתמש בכלים הבאים:
- Model Context Protocol (MCP). פרוטוקול פתוח וסטנדרטי לקישור סוכנים למקורות חיצוניים. אתם יכולים להגדיר סוכנים להתחבר לקטלוג באמצעות שרת MCP מרוחק או ארגז כלים מקומי של MCP. מידע נוסף זמין במאמר מידע על Model Context Protocol (MCP) ב-Knowledge Catalog.
- הערכה לפיתוח סוכנים (ADK). מסגרת מבית Google שמפשטת את התהליך של בנייה, הפעלה ובדיקה של סוכני AI גנרטיביים, ומציעה קשירות מובנות ל-Catalog Service API. מידע נוסף זמין ב דף הבית של ADK.
- LookupContext API. נקודת קצה של REST ו-gRPC API שמחלצת מטען ייעודי (payload) מאוחד של הקשר בפורמט YAML או JSON עבור נכסי נתונים, שמוכן להחדרה ישירה להנחיות של LLM. מידע נוסף מופיע במאמר אחזור הקשר באמצעות LookupContext API.
הקשר הגישה באמצעות MCP
Model Context Protocol (MCP) הוא גשר סטנדרטי שמאפשר לסוכני AI ולכלים להתחבר בצורה חלקה למקורות נתונים כמו Knowledge Catalog. היעזרו בטבלת ההשוואה הבאה כדי לבחור את האפשרות הכי מתאימה לשילוב:
| הטמעה | מתאים במיוחד בשביל | הפרטים העיקריים | נקודת קצה או הגדרה |
|---|---|---|---|
| שרת MCP מרוחק | פריסות בענן, סביבות ללא שרת (serverless) כמו Cloud Run ושירותים חיצוניים מנוהלים. | נקודת קצה (endpoint) שמתארחת ב-Google ולא דורשת ניהול של שרת מקומי. | נקודת קצה: https://dataplex.googleapis.com/mcpהוראות להגדרה מופיעות במאמר שימוש בשרת MCP מרוחק. |
| ארגז כלים מקומי של MCP | פיתוח סוכנים מקומי, יצירת אב טיפוס מהיר ושילוב עם סביבות פיתוח משולבות (IDE) למחשב כמו VS Code או Cursor. | כלי שורת פקודה שפועל כפרוקסי מקומי בין סביבת Workspace לבין Knowledge Catalog. | נדרשת התקנה בינארית והגדרות .mcp.json.הוראות להגדרה מופיעות במאמר שימוש בשרת MCP מקומי. |
שיטות מומלצות להקשר נתונים מבוסס-סוכן
כדי ליצור חוויות אג'נטיות מהימנות, חשוב לפעול לפי השיטות המומלצות הבאות כשמארגנים ומבצעים שאילתות של מטא-נתונים ב-Knowledge Catalog:
- הוספת היבטים סוכני AI לא יכולים להבחין בין טבלאות רשמיות של נתוני ייצור לבין טבלאות ארגז חול זמניות רק לפי השם. הגדירו והפעילו היבט של אות מהימן בהתאמה אישית כדי לאשר מוצרי נתונים סמכותיים, וכך לוודא שהסוכנים נותנים עדיפות לשאילתות למשאבים האלה או מגבילים אותן.
- אופטימיזציה של חיפושים באמצעות תקציבים לפי הקשר. כשקוראים ל-API
LookupContext, מציינים את הפרמטרcontext_budget. ה-API מבצע אופטימיזציה ומתאים קודם את המטא-נתונים הכי חשובים, כמו שושלת ותיאורים ראשיים, למגבלות האסימון שצוינו. - מתן מקורות מידע שקשורים לנושא כדי להציג נתיבי הצטרפות. בשאילתות שקשורות להקשר, אפשר לציין עד 10 טבלאות או נכסים קשורים. אם מספקים קבוצה של נכסים, מנוע ההקשר מאכלס אוטומטית את נתיבי ההצטרפות והקשרים, וכך הסוכן מבין איך הטבלאות מתקשרות.
- מבנה מילוני מונחים סמנטיים. להגדיר מונחים וקיצורים במילוני מונחים עסקיים. התקנון הזה עוזר לכלים לניהול שיחות לפתור בעיות שקשורות למילים נרדפות ולמדדים ספציפיים לעסק בצורה מדויקת.
- פרסום שאילתות לדוגמה. מצרפים ישירות לרשומות ב-Knowledge Catalog שאילתות מאומתות בשפה טבעית ואת שאילתות ה-SQL המקבילות להן. ההנמקה מבוססת על התבניות המאומתות האלה, וכך נמנעות שגיאות בהמרת SQL בסוכני text-to-SQL.
מעבר מ-Dataplex Universal Catalog ל-Knowledge Catalog
Dataplex Universal Catalog התפתח ל-Knowledge Catalog. מידע נוסף על המעבר הזה זמין במאמר מעבר מ-Dataplex Universal Catalog ל-Knowledge Catalog.
מגבלות
כשמתכננים את הפריסה, חשוב להביא בחשבון את המגבלות הבאות:
שילובים נתמכים. אמנם Knowledge Catalog תומך במערכות עיקריות של צד שלישי, אבל יכול להיות שחלק מהחילוצים הסמנטיים האוטומטיים יוגבלו לשירותים מובנים Google Cloud .
מגבלות מכסה. המכסות הסטנדרטיות של Google Cloud API חלות על פעולות של אחזור הקשר וחילוץ מטא-נתונים.
המאמרים הבאים
מידע על הקשר של הנתונים
הסבר על האופן שבו הקשר פעיל הופך מטא-נתונים פסיביים לנתונים שמאפשרים לסוכני AI להישאר מבוססים על עובדות ולמנוע הזיות.
יצירת הקשר בסיסי של הנתונים
ליצור מילון המונחים הארגוני, להגדיר סוגים מותאמים אישית של היבטים ולהעשיר נכסים ב-BigQuery.
סוכנים שפועלים על בסיס נתונים עם MCP
חיבור סוכני AI וכלים למפתחים אל Knowledge Catalog באמצעות Model Context Protocol.
אוטומציה של סריקות לאיכות הנתונים
הגדרת כללי אימות ומעקב אחרי ניקיון הנתונים בטבלאות באמצעות סריקות איכות אוטומטיות.
תרחישי שימוש אינטראקטיביים
הסבר על פתרונות בעולם האמיתי להעשרת הקשר, לתיעוד מקורות הנתונים ולתהליכי עבודה מבוססי-סוכן.