


Knowledge Catalog adalah lapisan konteks yang didukung Gemini yang menyediakan konteks bisnis universal dan kemampuan perujukan aktif di seluruh properti data Anda. Dengan membuat grafik konteks dinamis dari data terstruktur dan tidak terstruktur, alat ini membantu tim data dan developer menemukan aset, memverifikasi kualitas data, dan secara aman mendasari aplikasi AI generatif untuk mengurangi halusinasi.
Untuk panduan mendetail tentang Knowledge Catalog, lihat video berikut:
Audiens dan prasyarat
Ringkasan ini dirancang untuk engineer data dan konteks, data scientist, pengelola data, dan developer AI. Sebelum menggunakan Knowledge Catalog, Anda harus memiliki:
Memahami sistem database dan penyimpanan, seperti BigQuery atau Cloud Storage.
Pemahaman dasar tentang konsep AI generatif, seperti Retrieval-Augmented Generation (RAG) atau Model Context Protocol (MCP).
Menyelesaikan kompleksitas data khusus industri
Di perusahaan modern, data bersifat kompleks, sangat terdistribusi, dan ada dalam format terstruktur dan tidak terstruktur. Permintaan bisnis jarang dipetakan ke satu skema database atau penyimpanan dokumen. Menyelaraskan silo ini secara aman sekaligus memberikan jawaban yang langsung dan andal untuk pertanyaan lintas domain adalah tantangan operasional yang besar.
Knowledge Catalog berfungsi sebagai fondasi semantik yang menjembatani kesenjangan ini, sehingga memungkinkan agen AI dan alat analisis mengambil konteks yang relevan dan memiliki rujukan.
Peran pengguna utama
Context Engineer (Data Engineer). Otomatiskan penggabungan metadata di seluruh database dan Cloud Storage, lacak transformasi dengan silsilah, dan bangun alur kerja pengayaan dan evaluasi.
Pengelola Data (Tim Tata Kelola). Mengawasi kualitas metadata dengan memberikan peninjauan manual dalam loop terhadap deskripsi yang dihasilkan AI, menstandardisasi kosakata bisnis dengan glosarium, dan menentukan aspek kustom untuk melampirkan konteks khusus domain ke entri katalog.
Developer AI. Mendasari LLM dan aplikasi AI dengan skema data perusahaan tepercaya menggunakan server MCP atau API pengambilan konteks.
Kasus penggunaan industri
Tabel berikut menggambarkan pertanyaan kompleks yang muncul dalam praktiknya, cara pertanyaan tersebut melintasi batas teknis, dan cara Knowledge Catalog membantu organisasi menanganinya:
| Industri | Tantangan data dan operasional | Masalah bisnis yang perlu diselesaikan | Cara Knowledge Catalog mengatasinya |
|---|---|---|---|
| E-commerce |
|
"Temukan produk elektronik dengan tingkat pengembalian yang tinggi dan foto pelanggan yang menunjukkan tanda-tanda kerusakan saat tiba." | Pengaitan semantik di seluruh format data: Otomatis menemukan metadata dari database transaksional dan menautkannya ke gambar tidak terstruktur di bucket penyimpanan Cloud Storage, sehingga alat AI dapat menyelesaikan kueri di seluruh sistem penyimpanan yang berbeda-beda. |
| Manufaktur |
|
"Buat ringkasan untuk semua laporan pemeriksaan yang terkait dengan mesin di wilayah Barat yang gagal dalam pemeriksaan keselamatan pada kuartal terakhir." | Crawling regional dan tidak terstruktur: Meng-crawl dan mengatalogkan laporan inspeksi PDF tidak terstruktur bersama metadata aset, sehingga agen AI generatif dapat menemukan, menyusun, dan meringkas laporan menurut wilayah. |
| Layanan kesehatan |
|
"Pasien mana yang memiliki risiko tertinggi untuk dirawat ulang dalam 30 hari jika melihat tanda vital laboratorium dan frekuensi janji temu baru-baru ini?" | Kualitas dan silsilah data: Menghitung pemrofilan kualitas data tingkat baris dan peta silsilah di seluruh feed catatan kesehatan elektronik, yang membantu memastikan bahwa model prediktif klinis hanya mengandalkan data vital pasien yang terverifikasi dan berkualitas tinggi. |
| Jasa keuangan |
|
"Pelanggan mana yang termasuk dalam 10 pelanggan teratas berdasarkan pendapatan yang mengeluhkan 'masalah performa' dan bagaimana pengaruhnya terhadap proyeksi Q3?" | Grafik konteks terpadu: Menyatukan catatan pelanggan, masukan dukungan, dan tabel keuangan, sehingga kueri bahasa alami dapat menggabungkan statistik pendapatan klien dengan file masukan tidak terstruktur untuk memperkirakan dampak keuangan. |
Untuk mengatasi tantangan operasional ini, Knowledge Catalog menyediakan kemampuan utama yang membantu engineer data, data scientist, dan developer AI membangun sistem data yang diatur:
Menyediakan informasi yang relevan untuk agen AI dengan Model Context Protocol (MCP). Ekspos metadata, skema, silsilah, dan aturan bisnis langsung ke agen AI menggunakan server MCP lokal atau jarak jauh. Server ini memungkinkan model memverifikasi ekspektasi operasional sebelum menyarankan tindakan.
Mempercepat penemuan untuk AI dan analisis. Temukan aset data yang relevan menggunakan penelusuran semantik bahasa alami. Ringkasan dan rekomendasi generatif membantu pengguna menemukan data tanpa harus menunggu peninjauan dokumentasi manual.
Mengekstrak konteks dari data tidak terstruktur. Mengurai file tidak terstruktur secara otomatis, seperti PDF di Cloud Storage, untuk mengekstrak entitas dan hubungan, lalu mengonversinya menjadi aset yang dapat dikueri di BigQuery untuk mendukung agen percakapan.
Mengatur produk data dalam skala besar. Kemas kumpulan aset dengan perjanjian tingkat layanan (SLA), kontrak, detail kepemilikan, dan catatan penggunaan ke dalam unit tunggal yang diatur untuk penelusuran dan langganan.
Cara kerja Knowledge Catalog
Knowledge Catalog menyatukan pengelolaan data dan konteks melalui siklus proses tiga pilar. Diagram berikut mengilustrasikan cara layanan memetakan aset data fisik ke semantik bisnis untuk perujukan agen AI:
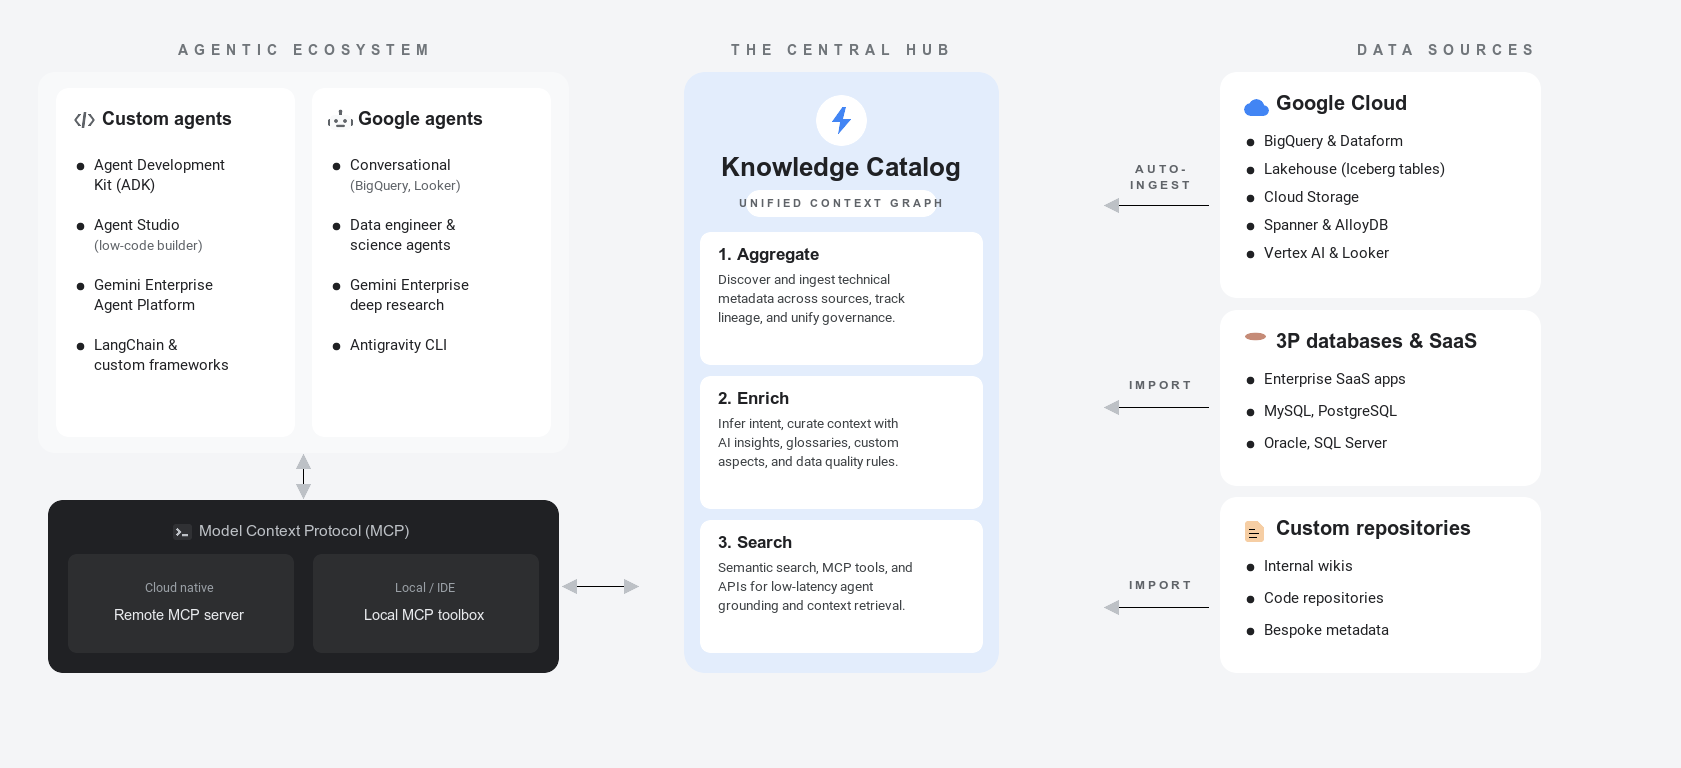
Untuk mengetahui informasi selengkapnya tentang konsep metadata ini, lihat artikel Tentang metadata.
Bagian berikut menjelaskan tiga pilar siklus proses metadata dan mengilustrasikan cara perusahaan retail menerapkannya pada tabel database, file, dan entri katalog eksternal:
Agregasi (Menemukan dan menyerap). Knowledge Catalog otomatis meng-crawl dan mengindeks metadata teknis di seluruh aset data Anda tanpa memindahkan data pokok:
- Database bawaan. Pembuatan katalog otomatis merekam skema dan atribut di seluruh platform seperti BigQuery, AlloyDB untuk PostgreSQL, dan Spanner.
- Konektivitas terkelola. Menyerap definisi dari sistem eksternal, seperti Oracle atau PostgreSQL, atau partner registry, seperti Collibra, tanpa menulis pipeline kustom.
- Silsilah data. Lacak transformasi tingkat kolom di seluruh pipeline untuk melacak asal data Anda dan bagaimana data tersebut telah berubah.
- Contoh: Perusahaan retail otomatis menyerap metadata database
transaksional, seperti tabel
ordersdanorder_items, serta mengindeks file produk tidak terstruktur yang disimpan di bucket Cloud Storage. Mereka menautkan database eksternal untuk membuat indeks metadata terpadu dalam direktori yang dapat ditemukan.
Untuk mempelajari lebih lanjut agregasi metadata dan penyerapan data (klik untuk meluaskan)
- Sumber data yang didukung: Mencantumkan semua sumber internal dan eksternal yang didukung Google Cloud untuk penyerapan otomatis.
- Ringkasan konektivitas terkelola: Menjelaskan cara menyerap skema teknis dari sistem eksternal.
- Melacak silsilah data: Menjelaskan cara memvisualisasikan transformasi pipeline tingkat kolom dan alur data.
Pengayaan (Menyusun konteks dan memverifikasi kepercayaan). Knowledge Catalog melampirkan makna bisnis ke struktur teknis dan menetapkan sinyal kepercayaan:
- Insight buatan AI. Gemini menganalisis log kueri untuk membuat deskripsi kolom, ringkasan tabel, dan penggabungan yang direkomendasikan.
- Pengindeksan tidak terstruktur. Merayapi direktori file untuk mengekstrak entitas dan koneksi dari aset tidak terstruktur seperti PDF atau gambar.
- Glosarium dan aspek. Petakan nama metrik internal ke kosakata bersama menggunakan istilah bisnis dan template logis.
- Kualitas data dan deteksi anomali. Terapkan pedoman kebersihan dan jalankan pemindaian machine learning untuk mendeteksi pencilan statistik atau masalah keaktualan data, sehingga menghasilkan sinyal kepercayaan utama.
- Peninjauan tata kelola. Kelola risiko dengan menggunakan proses peninjauan alur kerja untuk memverifikasi update metadata sebelum publikasi.
- Contoh: Tim retail memperkaya aset dengan memicu insight data untuk merekomendasikan deskripsi kolom dan menjalankan aturan kualitas data. Mereka memetakan definisi bisnis ke pesanan aktif dengan membuat glosarium dan aspek.
Untuk mempelajari lebih lanjut pengayaan metadata dan verifikasi kepercayaan (klik untuk meluaskan)
- Mengonfigurasi insight data: Menjelaskan cara membuat deskripsi dan ringkasan set data otomatis.
- Mengelola glosarium bisnis: Menjelaskan cara menyesuaikan istilah standar dan kosakata bisnis.
- Memperkaya metadata dengan aspek: Menunjukkan cara melampirkan properti metadata terstruktur ke aset logis.
- Menggunakan kembali aturan kualitas data: Menunjukkan cara membuat dan menggunakan kembali aturan validasi database.
- Ringkasan pembuatan profil data: Menjelaskan cara mengonfigurasi pemindaian untuk anomali skema dan pergeseran statistik.
Penelusuran dan pengambilan (Akses dan perujukan). Aplikasi AI dan pengguna bisnis mengkueri grafik konteks terpadu untuk mengakses data dengan aman:
- Agen perujukan. Hubungkan aplikasi dan agen berbasis LLM Anda ke katalog.
- Context API. Melakukan permintaan payload perujukan latensi rendah.
- Penelusuran semantik. Temukan aset yang tepat menggunakan kueri bahasa alami.
- Pengemasan data. Gabungkan kumpulan tabel, detail pemberian lisensi, dan SLA ke dalam paket data mandiri yang aman.
- Contoh: Analis melakukan penelusuran semantik bahasa alami untuk menemukan aset. Aplikasi AI menggunakan indeks ini secara aman menggunakan server MCP atau API pengambilan konteks, dan aset berkualitas tinggi dikemas ke dalam tampilan yang aman.
Untuk mempelajari lebih lanjut pengambilan konteks dan perujukan agen (klik untuk meluaskan)
- Ringkasan Model Context Protocol (MCP): Menjelaskan cara menghubungkan agen AI generatif dan lapisan aplikasi ke konteks Knowledge Catalog.
- Mengambil konteks menggunakan LookupContext: Menunjukkan cara mengekstrak payload operasional utama untuk perintah agen.
- Menelusuri aset: Menjelaskan kemampuan penelusuran aset menggunakan sintaksis kueri semantik bahasa alami.
Knowledge Catalog di Google Cloud dan ekosistem AI
Memahami cara Knowledge Catalog berintegrasi dengan layanan terkait sangat penting saat membangun fondasi data.
Google Cloud database dan model
- BigQuery. Knowledge Catalog secara otomatis meng-crawl dan mengindeks set data, tabel, dan tampilan BigQuery. Fitur ini memicu insight data yang didukung Gemini untuk menganalisis histori kueri, memublikasikan deskripsi, dan menyarankan contoh kueri terverifikasi.
- Looker (Google Cloud core). Knowledge Catalog menyerap Dasbor, Look, dan struktur LookML Looker, seperti tampilan, Eksplorasi, dimensi, dan ukuran. Penyerapan ini membangun pemetaan silsilah untuk melacak cara nilai operasional dipetakan ke semantik bisnis.
- Katalog runtime Lighthouse. Knowledge Catalog terintegrasi dengan Lighthouse, metastore runtime untuk beban kerja Iceberg open source. Layanan ini secara otomatis mengindeks metadata teknis di atas beban kerja Lighthouse untuk memberikan Konteks Aktif yang terpadu.
Platform dan asisten agen AI
- Analisis percakapan. Antarmuka analisis menggunakan istilah katalog dan alat penelusuran untuk memungkinkan pengguna membuat kueri metrik bisnis dalam bahasa alami dengan perujukan yang terverifikasi.
- Gemini untuk agen AI. Agen asisten presisi tinggi menggunakan metadata katalog untuk menjalankan pencarian database, sehingga mengurangi halusinasi.
- Gemini Enterprise Agent Platform. Knowledge Catalog berfungsi sebagai standar tata kelola data pusat dalam lingkungan platform target. Alat ini saling tertaut dengan Gemini Enterprise Agent Platform untuk menyediakan alat dan konteks ke Agent Registry platform.
Google Cloud integrasi layanan AI dan database
Knowledge Catalog bekerja bersama produkGoogle Cloud lainnya untuk membentuk fondasi data Anda. Tabel berikut menyoroti cara Knowledge Catalog berintegrasi dengan dan melengkapi layanan terkait:
| Layanan | Peran utama | Cara integrasinya dengan Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | Tata kelola dan konteks agentic | Berfungsi sebagai grafik konteks semantik terpadu, menjalankan pemindaian pemeriksaan kualitas data, dan mengekspos skema yang memiliki dasar ke model dan aplikasi AI. |
| BigQuery | Data warehousing perusahaan | Menyimpan, membuat kueri, dan memproses set data; otomatis meng-crawl, mengindeks, dan memperkaya tabel ini dengan aspek klasifikasi bisnis. |
| Vertex AI | Pengembangan model AI | Membangun, men-deploy, dan menghosting model dasar. Agen kustom mengambil konteks metadata untuk mendasari penalaran logis. |
| Cloud Storage | Penyimpanan file tidak terstruktur | Menyimpan file mentah yang tidak terstruktur; otomatis menjalankan pemindaian penemuan tidak terstruktur untuk mengurai PDF dan gambar guna membuat peta hubungan. |
Semantik dan format data
Untuk menginstruksikan dan melakukan grounding pada sistem agen secara efektif, Anda harus membedakan antara struktur data fisik dan makna semantik:
- Semantik. Makna, maksud, dan hubungan bisnis yang terkait dengan data Anda. Meskipun skema teknis menentukan spesifikasi penyimpanan struktural, seperti jenis database, panjang karakter, atau batasan bilangan bulat, semantik menjelaskan apa yang sebenarnya diwakili oleh set data. Misalnya, Anda dapat memetakan kolom bernama
txn_qtyke definisi bisnis "jumlah yang dibeli". - Data terstruktur. Informasi yang disimpan dalam skema dan format relasional yang ditentukan. Contohnya mencakup tabel BigQuery, database Spanner, dan tabel Postgres operasional. Knowledge Catalog otomatis meng-crawl metadata ini dan mencatat kolom dan batasan.
- Data tidak terstruktur. Informasi yang tidak diformat yang berisi file teks atau media mentah yang tidak memiliki skema struktural. Contohnya mencakup lembar data PDF, email dukungan pelanggan, dan gambar yang disimpan di Cloud Storage. Knowledge Catalog menjalankan pemindaian penemuan dengan menggunakan insight data tidak terstruktur untuk mengekstrak hubungan entity yang mendasarinya dan mencatatnya dalam profil grafik, yang merupakan aspek khusus yang berisi node dan edge hubungan entity yang diekstrak AI.
Orkestrasi konteks Agentic Data Cloud
Dalam framework Agentic Data Cloud Google, Knowledge Catalog berfungsi sebagai bidang orkestrasi semantik. Daripada mengharuskan developer meng-hardcode skema dan aturan database secara manual ke dalam perintah, mesin konteks secara dinamis menyajikan konteks semantik yang tepat yang dibutuhkan agen untuk membuat keputusan cerdas.
Gambar berikut menunjukkan cara Knowledge Catalog mengatur dan memberikan konteks data:
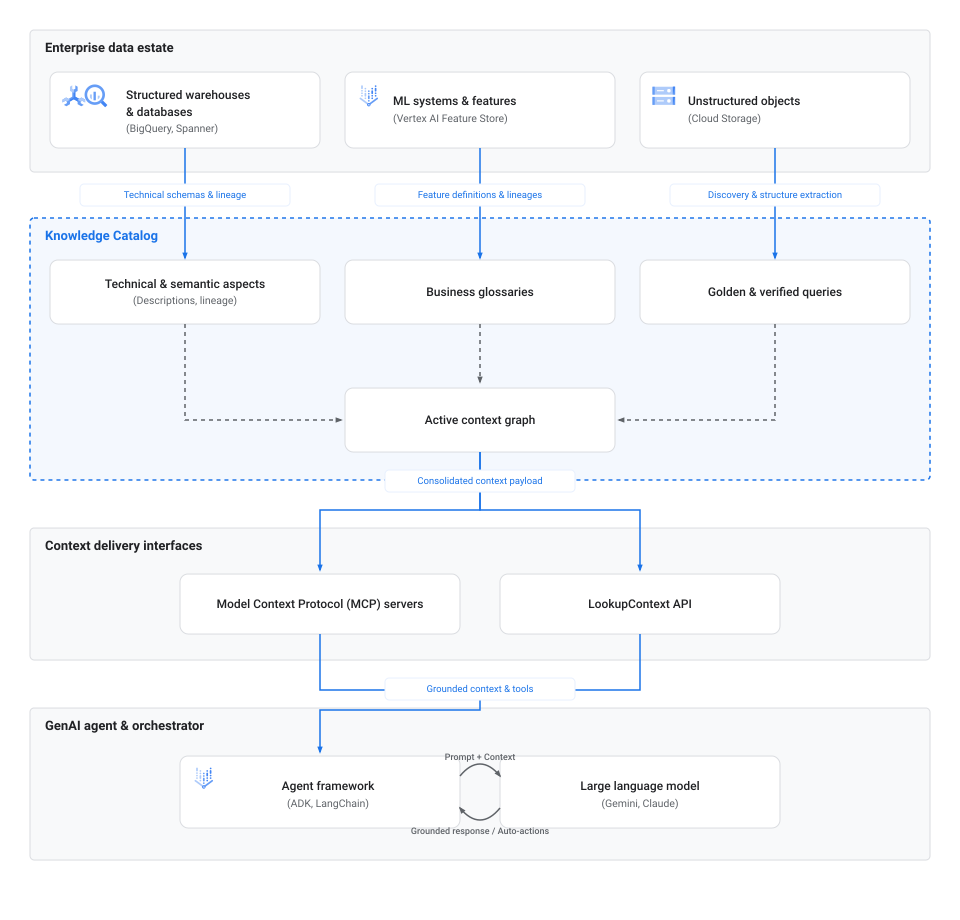
Alur kerja orkestrasi konteks terdiri dari fase berikut:
- Penyerapan dan penemuan. Database operasional, data warehouse seperti Spanner dan BigQuery, penyimpanan objek tidak terstruktur seperti Cloud Storage, dan metastore runtime seperti Lighthouse menyediakan skema teknis, peta asal-usul, dan definisi metadata langsung ke Knowledge Catalog.
- Pemetaan konteks. Di dalam Knowledge Catalog, properti metadata ini ditautkan ke elemen semantik, termasuk aspek teknis, glosarium bisnis, dan kueri terverifikasi, untuk menyusun grafik konteks aktif.
- Antarmuka penayangan. Aplikasi dan pengelola AI mengambil grafik konteks gabungan ini secara terprogram menggunakan konektor standar, seperti MCP atau endpoint API
LookupContextlangsung. - Perujukan agen. Framework orkestrasi, seperti Agent Development Kit (ADK) atau LangChain, menyuntikkan konteks metadata ini langsung ke perintah LLM. Injeksi ini mendasarkan penalaran agen pada aturan organisasi yang terverifikasi, yang memungkinkannya mengkueri database atau menjalankan tindakan otomatis tanpa halusinasi.
Profil agen AI
Bergantung pada alur kerja yang ingin Anda otomatiskan, Anda dapat membuat berbagai kelas agen yang didukung oleh Knowledge Catalog:
- Agen penemuan data. Asisten ini membantu pengguna menelusuri dan menjelajahi aset data. Alih-alih menggunakan pencocokan kata kunci, mereka menganalisis niat dan batasan bentuk panjang dalam bahasa alami untuk mengambil aset fisik yang paling relevan.
- Agen pengayaan metadata. Agen latar belakang ini menyerap teks tidak terstruktur dari wiki, file README, atau log chat, mengurai teks menjadi metadata formal, dan menulis metadata sebagai aspek dalam Knowledge Catalog agar metadata tetap terbaru.
- Kualitas data dan agen pipeline. Agen otonom ini mengevaluasi aturan kualitas, mendeteksi penyimpangan skema, dan membuat atau memperbaiki pipeline transformasi data dengan membuat kueri silsilah data dan statistik profil.
Alat orkestrasi
Untuk membuat dan mengintegrasikan agen ini, Anda dapat menggunakan alat berikut:
- Model Context Protocol (MCP). Protokol terbuka yang terstandardisasi untuk menautkan agen ke resource eksternal. Anda dapat mengonfigurasi agen untuk terhubung ke katalog menggunakan server MCP jarak jauh atau toolbox MCP lokal. Untuk mengetahui informasi selengkapnya, lihat Tentang Model Context Protocol (MCP) di Knowledge Catalog.
- Agent Development Kit (ADK). Framework dari Google yang menyederhanakan pembuatan, menjalankan, dan pengujian agen AI generatif, yang menawarkan binding bawaan ke Catalog Service API. Untuk mengetahui informasi selengkapnya, lihat halaman beranda ADK.
- LookupContext API. Endpoint API REST dan gRPC yang mengekstrak payload konteks YAML atau JSON terpadu untuk aset data, yang siap disisipkan langsung ke dalam perintah LLM. Untuk mengetahui informasi selengkapnya, lihat Mengambil konteks menggunakan LookupContext API.
Mengakses konteks dengan MCP
Model Context Protocol (MCP) adalah jembatan standar yang memungkinkan agen dan alat AI terhubung dengan lancar ke sumber data seperti Knowledge Catalog. Gunakan tabel perbandingan berikut untuk menentukan opsi terbaik untuk integrasi Anda:
| Penerapan | Paling cocok untuk | Detail penting | Endpoint atau penyiapan |
|---|---|---|---|
| Server MCP jarak jauh | Deployment yang mengutamakan cloud, lingkungan serverless seperti Cloud Run, dan layanan eksternal terkelola. | Endpoint yang dihosting oleh Google yang tidak memerlukan pengelolaan server lokal. | Endpoint: https://dataplex.googleapis.com/mcpUntuk menyiapkan, lihat Menggunakan server MCP jarak jauh. |
| MCP toolbox lokal | Pengembangan agen lokal, pembuatan prototipe cepat, dan integrasi IDE desktop seperti VS Code atau Cursor. | Alat command line yang bertindak sebagai proxy lokal antara lingkungan ruang kerja dan Knowledge Catalog. | Memerlukan penginstalan biner dan setelan .mcp.json.Untuk menyiapkan, lihat Menggunakan server MCP lokal. |
Praktik terbaik untuk konteks data agentic
Untuk membangun pengalaman agentik yang andal, perhatikan praktik terbaik berikut saat mengatur dan membuat kueri metadata di Knowledge Catalog:
- Tambahkan aspek. Agen AI tidak dapat membedakan antara tabel produksi resmi dan tiruan sandbox sementara hanya berdasarkan nama. Tentukan dan terapkan aspek sinyal kepercayaan kustom untuk mensertifikasi produk data otoritatif, yang membantu memastikan bahwa agen memprioritaskan atau membatasi kueri ke resource ini.
- Optimalkan pencarian dengan menggunakan anggaran konteks. Saat memanggil API
LookupContext, tentukan parametercontext_budget. API mengoptimalkan dan menyesuaikan metadata yang paling penting terlebih dahulu, seperti asal-usul dan deskripsi utama, dalam batasan token yang Anda tentukan. - Berikan referensi terkait untuk mengekspos jalur gabungan. Dalam pertanyaan konteks Anda, cantumkan hingga 10 tabel atau aset terkait. Menyediakan sekelompok aset memungkinkan mesin konteks mengisi otomatis jalur dan hubungan gabungan, yang membantu agen memahami cara tabel berinteraksi.
- Menyusun glosarium semantik. Menyeragamkan istilah dan singkatan dalam glosarium bisnis. Standardisasi ini membantu alat percakapan menyelesaikan sinonim dan metrik khusus bisnis secara akurat.
- Publikasikan kueri unggulan. Lampirkan kueri bahasa alami yang terverifikasi dan padanan SQL yang benar secara langsung ke entri Knowledge Catalog. Dengan mendasarkan penalaran pada template terverifikasi ini, Anda mencegah error konversi SQL di agen text-to-SQL.
Transisi dari Dataplex Universal Catalog ke Knowledge Catalog
Dataplex Universal Catalog telah berkembang menjadi Knowledge Catalog. Untuk mengetahui informasi selengkapnya tentang transisi ini, lihat Beralih dari Dataplex Universal Catalog ke Knowledge Catalog.
Batasan
Saat merencanakan deployment, pertimbangkan batasan berikut:
Integrasi yang didukung. Meskipun Knowledge Catalog mendukung sistem pihak ketiga utama, ekstraksi semantik otomatis tertentu mungkin terbatas pada layanan bawaan Google Cloud .
Batas kuota. Kuota API Google Cloud standar berlaku untuk operasi pengambilan konteks dan ekstraksi metadata.
Langkah berikutnya
Tentang konteks data
Pahami cara konteks aktif mengubah metadata pasif untuk melandasi agen AI dan mencegah halusinasi.
Menetapkan konteks data dasar
Buat glosarium bisnis, tentukan jenis aspek kustom, dan lengkapi aset di BigQuery.
Mengintegrasikan agen dengan MCP
Hubungkan agen AI dan alat developer ke Knowledge Catalog menggunakan Model Context Protocol.
Cari referensi
Temukan dan jelajahi resource katalog di seluruh Google Cloud dan sistem pihak ketiga menggunakan bahasa alami.
Mengotomatiskan pemindaian kualitas data
Tentukan aturan validasi dan pantau kebersihan data di seluruh tabel dengan pemindaian kualitas otomatis.
Jelajahi kasus penggunaan interaktif
Pelajari solusi dunia nyata untuk pengayaan konteks, asal-usul data, dan alur kerja agentic.