


Knowledge Catalog (in precedenza Catalogo universale Dataplex) semplifica la comprensione e l'analisi dei dati eseguendo automaticamente la profilazione delle tabelle BigQuery, del catalogo RESTGoogle Cloud Lakehouse Iceberg, di SAP Business Data Cloud (BDC) Delta Lake e Hive.
La profilazione è come ottenere un report dettagliato sullo stato dei tuoi dati. Fornisce statistiche chiave, come valori comuni, la distribuzione dei dati e il numero di voci mancanti (conteggi nulli). Queste informazioni velocizzano l'analisi.
La profilazione dei dati consiglia regole di controllo della qualità dei dati per garantire l'affidabilità dei dati.
Modello concettuale
Knowledge Catalog ti consente di comprendere meglio il profilo dei tuoi dati creando una scansione di profilazione dei dati. Una scansione di profilazione dei dati è un tipo di scansione dei dati di Knowledge Catalog che analizza una tabella BigQuery, Google Cloud Lakehouse Iceberg REST Catalog, SAP BDC Delta Lake o Hive per generare insight statistici.
Il seguente diagramma mostra come Knowledge Catalog esegue la scansione dei dati per generare report sulle caratteristiche statistiche.
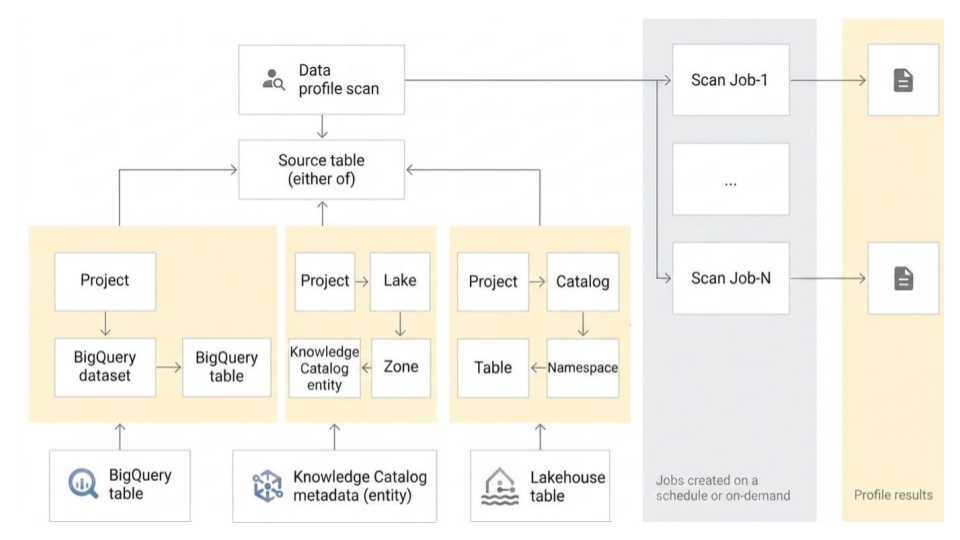
Una scansione di profilazione dei dati è associata a una tabella BigQuery, Google Cloud Lakehouse Iceberg REST Catalog, SAP BDC Delta Lake o Hive e analizza la tabella per generare i risultati della profilazione dei dati. Una scansione del profilo di dati supporta diverse opzioni di configurazione.
Opzioni di configurazione
Questa sezione descrive le opzioni di configurazione disponibili per l'esecuzione delle scansioni di profilazione dei dati.
Modalità di profilazione
Puoi scegliere tra le seguenti modalità di profilazione:
Standard: questa è la modalità predefinita. Fornisce un profilo completo e personalizzabile analizzando i dati in base al campionamento e ai filtri specificati. La modalità Standard è adatta per l'analisi dettagliata e il monitoraggio a lungo termine delle caratteristiche dei dati.
Leggera (anteprima): questa modalità fornisce scansioni di profilazione a bassa latenza che restituiscono risultati in pochi secondi. È ottimizzato per velocità ed efficienza in termini di costi per supportare casi d'uso come i seguenti:
- Grounding delle risposte degli agenti AI con caratteristiche dei dati immediate
- Generare in modo conveniente profili su larga scala per l'individuazione globale dei dati
- Fornire report sull'integrità rapidi durante l'esplorazione interattiva dei dati
La modalità leggera presenta le seguenti limitazioni:
- A differenza della modalità di profilazione standard, non puoi modificare l'ambito, i filtri o le dimensioni di campionamento nelle scansioni leggere.
- Non supporta le viste e le tabelle esterne BigQuery.
Opzioni di programmazione
Puoi pianificare una scansione di profilazione dei dati con una frequenza definita o eseguirla on demand. Se un processo di scansione richiede più tempo del previsto, puoi annullarlo.
Identità di esecuzione
Per impostazione predefinita, Knowledge Catalog utilizza un service agent centralizzato (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com) per eseguire le scansioni di profilazione dei dati.
Puoi anche ignorare questa identità di esecuzione predefinita specificando un account di servizio personalizzato o utilizzando le tue credenziali utente finale. Questo approccio offre diversi vantaggi:
- Principio del privilegio minimo:concedi solo le autorizzazioni Identity and Access Management (IAM) esatte richieste per attività specifiche di profilazione dei dati a un account di servizio dedicato, riducendo al minimo l'accesso con provisioning eccessivo.
- Controllo dell'controllo dell'accesso granulare: limita le autorizzazioni a risorse specifiche, consentendo l'integrazione con le policy di accesso a livello di riga e colonna in BigQuery.
- Verificabilità migliorata: assegna service account personalizzati o credenziali utente a scansioni specifiche, rendendo il monitoraggio e la registrazione delle attività molto più chiari nei log di controllo.
- Unificazione della fatturazione:quando utilizzi un'identità di esecuzione personalizzata, gli addebiti per l'elaborazione e l'archiviazione vengono centralizzati direttamente in BigQuery (ignorando gli SKU Knowledge Catalog Premium). In questo modo, puoi usufruire degli sconti aziendali e degli impegni di slot di BigQuery.
Per istruzioni su come configurare un'identità di esecuzione personalizzata, consulta Configura l'identità di esecuzione.
Requisiti di networking
Per eseguire una scansione, devi abilitare l'accesso privato Google nella subnet VPC che utilizzi per la scansione. Se non specifichi una subnet, assicurati che la subnet predefinita abbia l'accesso privato Google abilitato.
Ambito
Per le scansioni di profilazione Standard, puoi specificare l'ambito dei dati da scansionare:
Tabella completa: l'intera tabella viene analizzata nella scansione di profilazione dei dati. Il campionamento, i filtri di riga e i filtri di colonna vengono applicati all'intera tabella prima di calcolare le statistiche di profilazione.
Incrementale: i dati incrementali specificati vengono scansionati nella scansione del profilo di dati. Specifica una colonna
DateoTimestampnella tabella da utilizzare come incremento. In genere, questa è la colonna in base alla quale è partizionata la tabella. Il campionamento, i filtri per le righe e i filtri per le colonne vengono applicati ai dati incrementali prima del calcolo delle statistiche di profilazione.
Filtra dati
Per le scansioni di profilazione Standard, puoi filtrare i dati da scansionare per la profilazione utilizzando i filtri di riga e di colonna. L'utilizzo dei filtri ti aiuta a ridurre i tempi e i costi di esecuzione, nonché a escludere i dati sensibili e non necessari. Le scansioni di profilazione leggera non supportano i filtri per colonne e righe.
Filtri di riga: i filtri di riga ti consentono di concentrarti sui dati relativi a un periodo di tempo specifico o a un segmento specifico, ad esempio una regione. Ad esempio, puoi filtrare i dati con un timestamp precedente a una determinata data.
Filtri delle colonne: i filtri delle colonne ti consentono di includere ed escludere colonne specifiche dalla tabella per eseguire la scansione di profilazione dei dati.
Dati di esempio
Per le scansioni di profilazione Standard, puoi specificare una percentuale di record dei tuoi dati da campionare per eseguire una scansione di profilazione dei dati. La creazione di scansioni di profilazione dei dati su un campione più piccolo di dati può ridurre il tempo di esecuzione e il costo dell'interrogazione dell'intero set di dati.
Più scansioni di profilazione dei dati
Puoi creare più scansioni di profilazione dei dati contemporaneamente utilizzando la console Google Cloud . Puoi selezionare fino a 100 tabelle da un set di dati e creare una scansione di profilazione dei dati per ogni set di dati. Per saperne di più, consulta Crea più scansioni di profilazione dei dati.
Esporta i risultati della scansione in una tabella BigQuery
Puoi esportare i risultati della scansione di profilazione dei dati in una tabella BigQuery per ulteriori analisi. Per personalizzare i report, puoi collegare i dati della tabella BigQuery a una dashboard Looker. Puoi creare un report aggregato utilizzando la stessa tabella dei risultati in più analisi.
Risultati della profilazione dei dati
I risultati della profilazione dei dati includono i seguenti valori:
| Tipo di colonna | Risultati della profilazione dei dati |
|---|---|
| Colonna numerica |
|
| Colonna stringa |
|
| Altre colonne non nidificate (data, ora, timestamp, binario ecc.) |
|
| Tutte le altre colonne di tipo di dati nidificati o complessi (come Record, Array, JSON) o qualsiasi colonna con modalità ripetuta. |
|
I risultati includono il numero di record scansionati in ogni job.
Rapporti e monitoraggio
Puoi monitorare e analizzare i risultati della profilazione dei dati utilizzando i seguenti report e metodi:
Report pubblicati con la tabella di origine nelle pagine di BigQuery e Knowledge Catalog
Se configuri una scansione di profilazione dei dati per pubblicare i risultati in BigQuery e Knowledge Catalog, puoi visualizzare i risultati più recenti della scansione di profilazione dei dati nella scheda Profilo dei dati della tabella di origine sia in BigQuery che in Knowledge Catalog. Questi risultati sono accessibili da qualsiasi progetto.
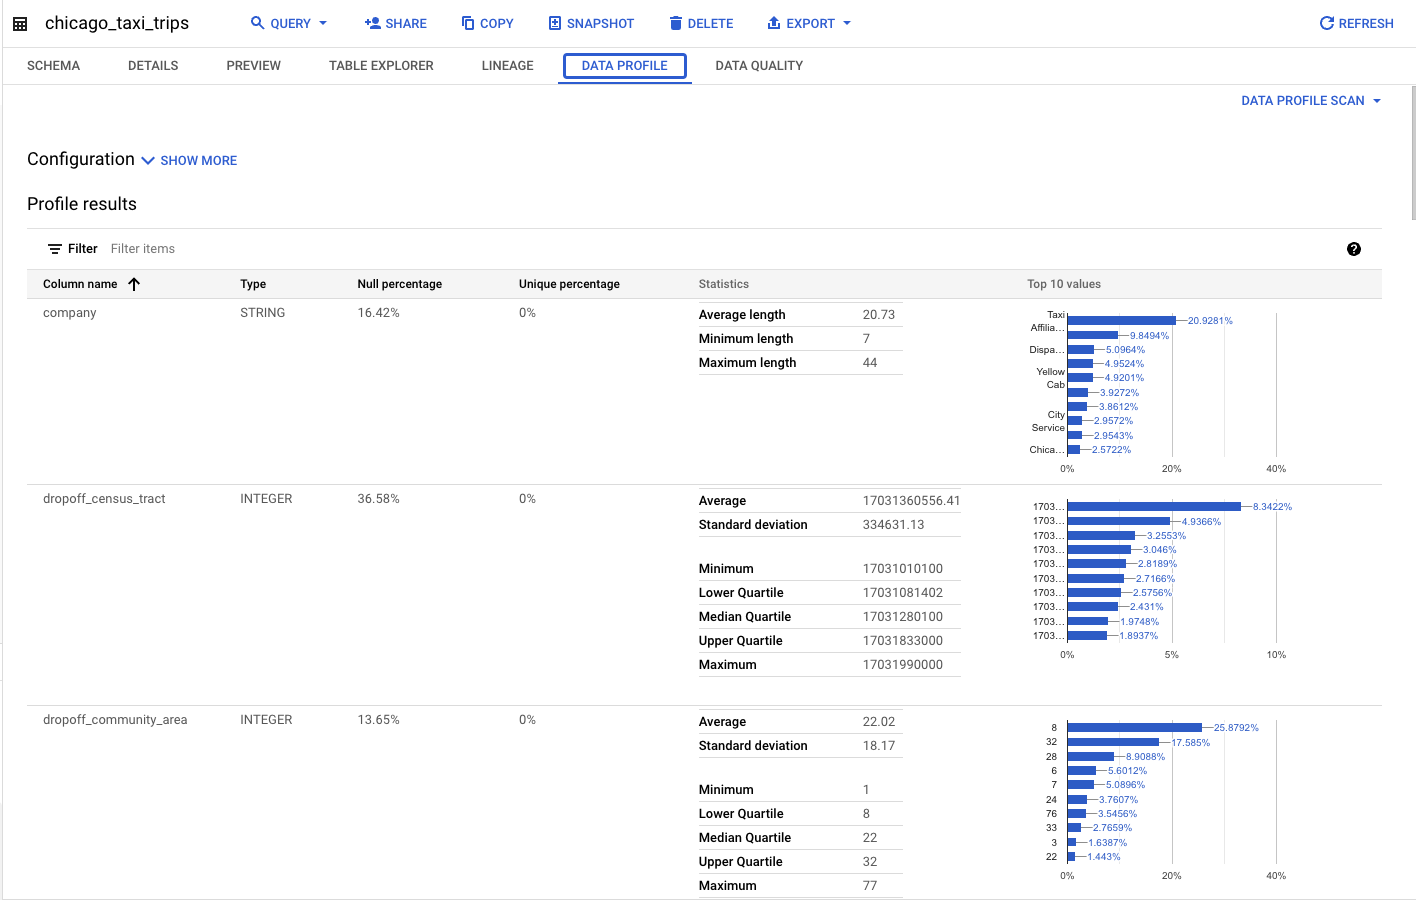
Report storico per job
Nella pagina Profilazione e qualità dei dati > Scansione di profilazione dei dati in Knowledge Catalog e BigQuery, puoi visualizzare i report dettagliati per i job più recenti e storici. Ciò include le informazioni del profilo a livello di colonna e la configurazione utilizzata.
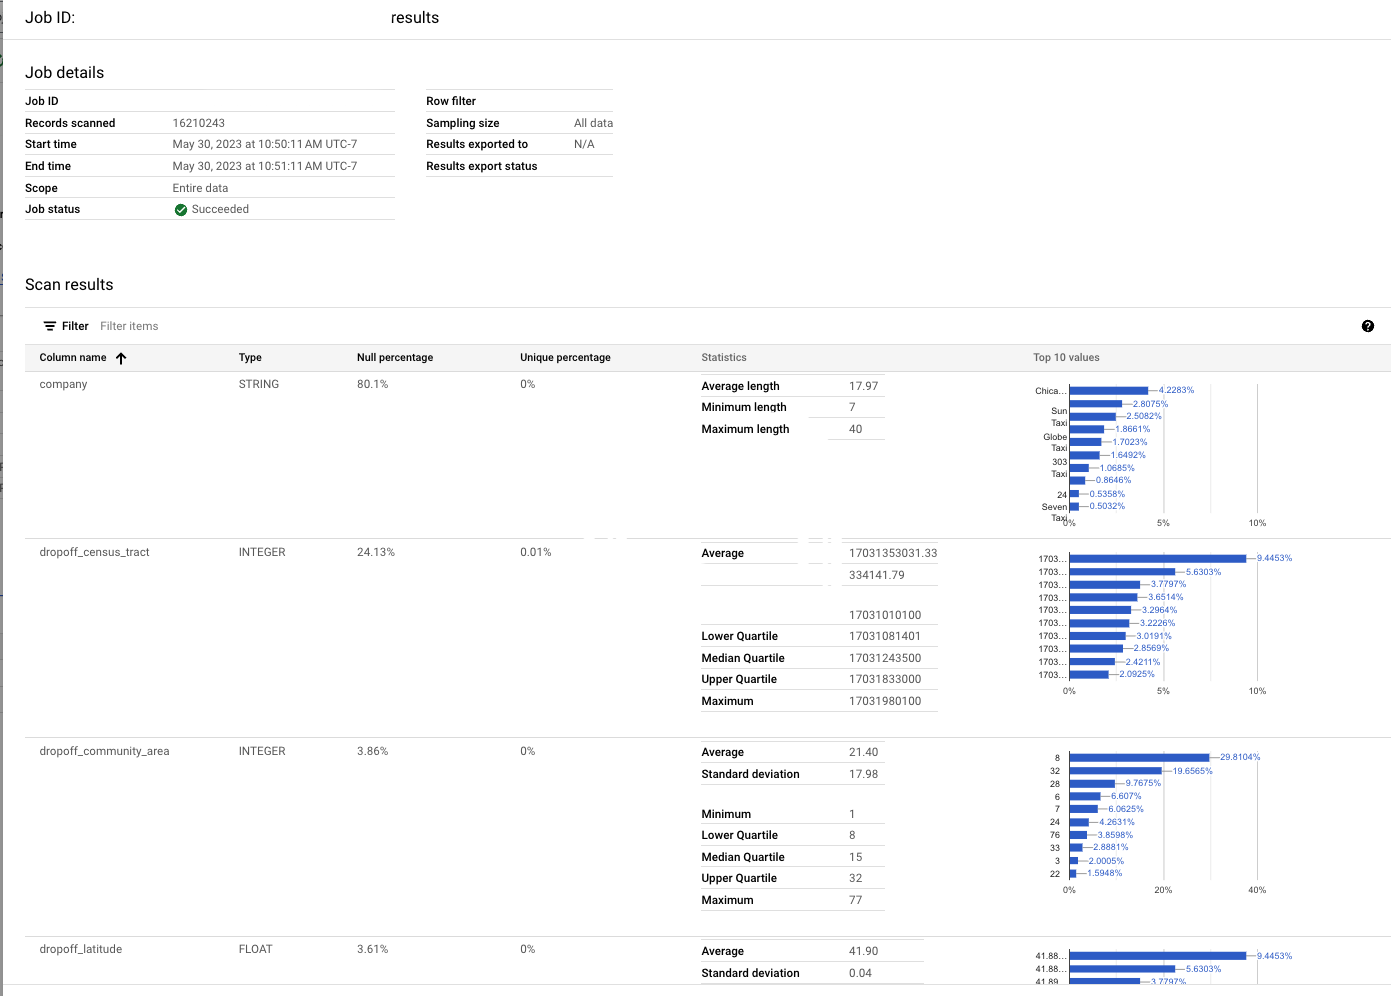
Scheda Analisi
Nella pagina Profilazione e qualità dei dati > Scansione di profilazione dei dati in Knowledge Catalog e BigQuery, puoi utilizzare la scheda Analisi per visualizzare le tendenze di una determinata statistica di una colonna in più job di profilazione. Ad esempio, se hai una scansione incrementale, puoi visualizzare l'andamento della media di un valore nel tempo.
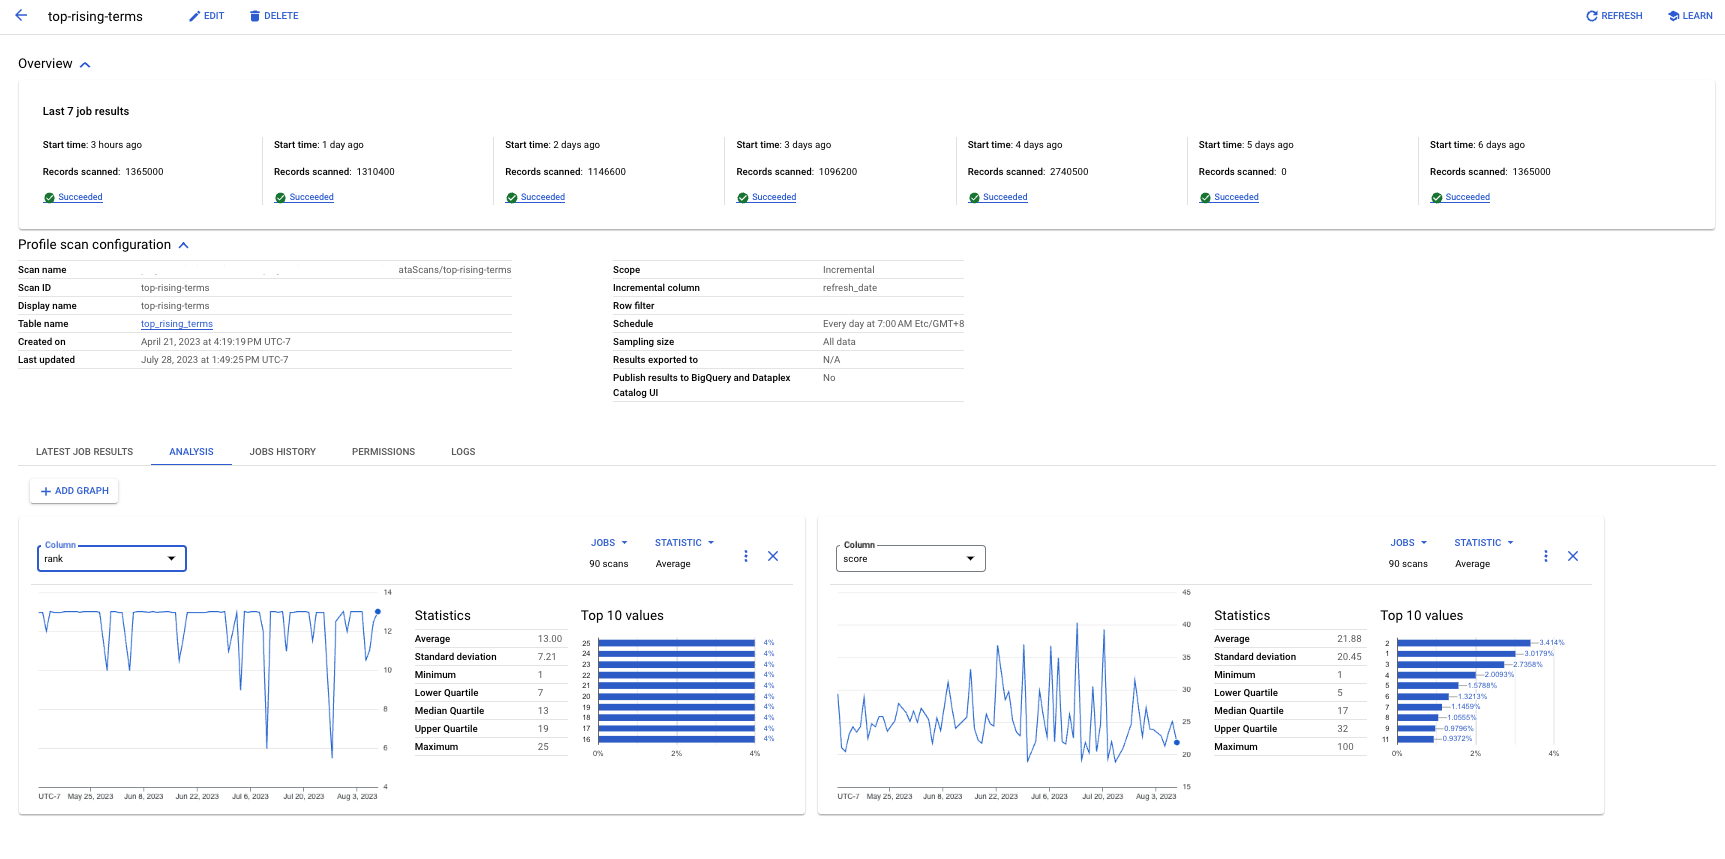
Crea la tua dashboard o i tuoi dati analitici
Se hai configurato una scansione di profilazione dei dati per esportare i risultati in una tabella BigQuery, puoi creare dashboard personalizzate utilizzando strumenti come Data Studio.
Monitorare i costi di calcolo delle DCU in fatturazione Cloud
Il calcolo della scansione di profilazione dei dati viene eseguito su un'infrastruttura serverless e non emette metriche delle serie temporali in Cloud Monitoring. Per monitorare e attribuire i costi di Data Profiling DCU per progetto, ID scansione o tabella, esegui query sull'esportazione della fatturazione Cloud in BigQuery utilizzando le etichette di sistema
goog-dataplex-datascan-*. Per saperne di più, consulta Monitorare e attribuire i costi delle DCU Dataplex con l'esportazione della fatturazione Cloud.
Limitazioni
- Puoi eseguire scansioni di profilazione dei dati solo su BigQuery, Google Cloud Lakehouse Iceberg REST Catalog, SAP BDC Delta Lake e tabelle Hive.
- La profilazione dei dati è supportata per le tabelle BigQuery con tutti i tipi di colonne, ad eccezione di
BIGNUMERIC. Una scansione creata per una tabella con una colonnaBIGNUMERICgenera un errore di convalida e non viene creata correttamente. - Non sono supportate più scansioni di profilazione dei dati per le tabelle Lakehouse.
Prezzi
- Per ulteriori informazioni sui prezzi, consulta Prezzi di Knowledge Catalog.
- Per monitorare e attribuire l'utilizzo e i costi delle DCU delle scansioni di profilazione dei dati utilizzando l'esportazione della fatturazione Cloud in BigQuery, consulta Monitorare e attribuire i costi delle DCU Dataplex con l'esportazione della fatturazione Cloud.
Passaggi successivi
- Scopri come utilizzare la profilazione dei dati.
- Per saperne di più sulle risorse Terraform disponibili per la creazione di scansioni di profilazione dei dati, consulta quanto segue:
- Risorsa di scansione dei dati di Knowledge Catalog nel registry Terraform.
- La documentazione della risorsa di scansione dei dati di Knowledge Catalog su GitHub, che supporta la configurazione delle regole basata su YAML.
- Scopri di più sulla qualità dei dati automatica.
- Scopri come utilizzare la qualità dei dati automatica.
- Scopri come esplorare i dati generando insight sui dati.