


Knowledge Catalog (이전 명칭: Dataplex Universal Catalog)는 BigQuery,Google Cloud Lakehouse Iceberg REST 카탈로그, SAP Business Data Cloud (BDC) Delta Lake, Hive 테이블을 자동으로 프로파일링하여 데이터를 더 쉽게 이해하고 분석할 수 있도록 지원합니다.
프로파일링은 데이터에 대한 자세한 상태 보고서를 받는 것과 같습니다. 일반적인 값, 데이터가 분산된 방식(분포), 누락된 항목 수(null 수)와 같은 주요 통계를 제공합니다. 이 정보를 사용하면 분석 속도가 빨라집니다.
데이터 프로파일링은 데이터 신뢰성이 유지되도록 데이터 품질 검사 규칙을 추천합니다.
개념 모델
Knowledge Catalog를 사용하면 데이터 프로필 스캔을 만들어 데이터 프로필을 더 잘 이해할 수 있습니다. 데이터 프로필 스캔은 BigQuery, Google Cloud Lakehouse Iceberg REST 카탈로그, SAP BDC Delta Lake 또는 Hive 테이블을 분석하여 통계적 유용한 정보를 생성하는 Knowledge Catalog 데이터 스캔의 한 가지 유형입니다.
다음 다이어그램은 Knowledge Catalog가 데이터를 스캔하여 통계적 특성을 보고하는 방법을 보여줍니다.
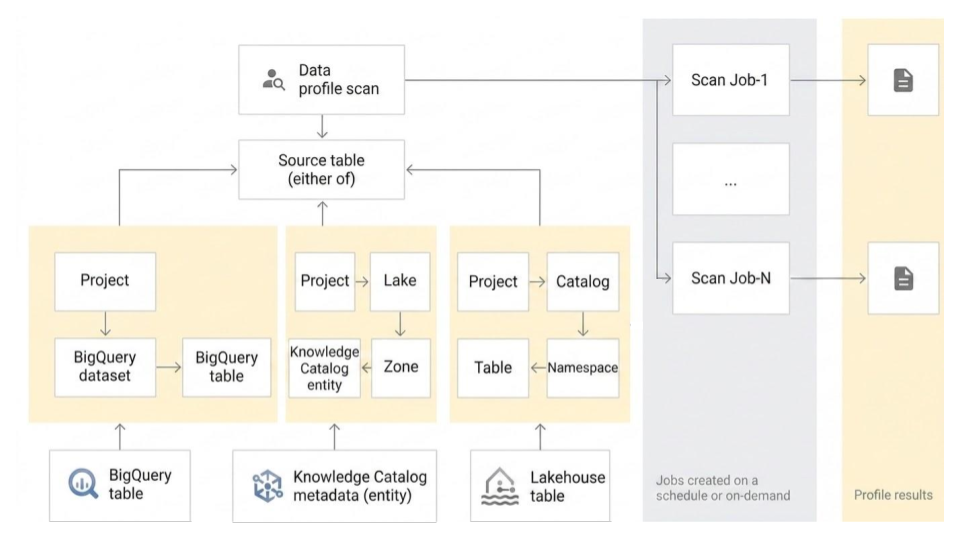
데이터 프로필 스캔은 BigQuery, Google Cloud Lakehouse Iceberg REST 카탈로그, SAP BDC Delta Lake 또는 Hive 테이블 하나와 연결되고 테이블을 스캔하여 데이터 프로파일링 결과를 생성합니다. 데이터 프로필 스캔은 여러 구성 옵션을 지원합니다.
구성 옵션
이 섹션에서는 데이터 프로필 스캔을 실행하는 데 사용할 수 있는 구성 옵션을 설명합니다.
프로파일링 모드
다음 프로파일링 모드 중에서 선택할 수 있습니다.
표준: 기본 모드입니다. 사용자가 지정한 샘플링 및 필터를 기반으로 데이터를 스캔하여 포괄적이고 맞춤설정 가능한 프로필을 제공합니다. 일반 모드는 데이터 특성을 자세히 분석하고 장기적으로 모니터링하는 데 적합합니다.
경량 (미리보기): 이 모드는 결과를 초 단위로 반환하는 지연 시간이 짧은 프로필 스캔을 제공합니다. 다음과 같은 사용 사례를 지원하기 위해 속도와 비용 효율성에 최적화되어 있습니다.
- 즉각적인 데이터 특성으로 AI 에이전트 응답 그라운딩
- 글로벌 데이터 검색을 위해 대규모로 프로필을 비용 효율적으로 사전 생성
- 대화형 데이터 탐색 중에 신속한 건강 보고서 제공
경량 모드에는 다음과 같은 제한사항이 있습니다.
- 표준 프로파일링 모드와 달리 경량 스캔에서는 범위, 필터 또는 샘플링 크기를 수정할 수 없습니다.
- BigQuery 뷰 및 외부 테이블은 지원하지 않습니다.
비정형(미리보기): 이 모드는 Vertex AI Gemini 모델로 구동되는 비정형 데이터(
UnstructuredDataProfileSpec)의 독립형 데이터 프로필 검사를 사용하여 기존 BigQuery 객체 테이블을 통해 Cloud Storage의 PDF와 같은 비정형 파일의 실제 정성적 콘텐츠를 분석합니다. null 개수 및 값 분포와 같은 통계 측정항목을 계산하는 정형 프로파일링 모드 (표준 및 경량)와 달리 비정형 데이터의 데이터 프로필 스캔은 시맨틱 추론을 실행하여 비즈니스 항목(NodeType)과 관계 (EdgeType)를 추출하고,Graph Profile측면 (dataplex-types.global.graph-profile)을 카탈로그 항목에 연결하고, 프로그래매틱 데이터 구체화를 실제 BigQuery 테이블 또는 뷰로 지원합니다.참고: 구조화되지 않은 데이터의 데이터 프로필 스캔은 Dataplex REST API를 통해서만 공개 미리보기로 제공됩니다. Google Cloud 콘솔 및 Google Cloud CLI 워크플로는 지원되지 않습니다.
자세한 내용은 비정형 데이터 통계 정보, 비정형 데이터에 탐색 스캔 사용(Cloud Storage 탐색 스캔의 경우), 비정형 데이터에 데이터 프로필 사용 (독립형 객체 테이블 프로파일링의 경우)을 참고하세요.
예약 옵션
정의된 빈도로 데이터 프로필 스캔을 예약하거나 요청 시 스캔을 실행할 수 있습니다. 스캔 작업이 예상보다 오래 실행되는 경우 작업을 취소할 수 있습니다.
실행 ID
기본적으로 Knowledge Catalog는 중앙 집중식 서비스 에이전트 (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com)를 사용하여 데이터 프로필 스캔을 실행합니다.
맞춤 서비스 계정 (Bring Your Own Service Account)을 지정하거나 자체 최종 사용자 사용자 인증 정보 (EUC)를 사용하여 이 기본 실행 ID를 재정의할 수도 있습니다. 이렇게 하면 다음과 같은 여러 이점이 있습니다.
- 최소 권한 원칙: 특정 데이터 프로파일링 작업에 필요한 정확한 Identity and Access Management (IAM) 권한만 전용 서비스 계정에 부여하여 과도하게 프로비저닝된 액세스를 최소화합니다.
- 세분화된 액세스 제어: 특정 리소스에 대한 권한을 범위 지정하여 BigQuery의 행 수준 및 열 수준 액세스 정책과 통합할 수 있습니다.
- 감사 가능성 향상: 특정 검사에 맞춤 서비스 계정 또는 사용자 인증 정보를 할당하여 감사 로그에서 활동 추적 및 로깅을 훨씬 명확하게 할 수 있습니다.
- 결제 통합: 맞춤 실행 ID를 사용하면 처리 및 스토리지 요금이 Knowledge Catalog Premium SKU를 우회하여 BigQuery 아래에 직접 중앙 집중화됩니다. 이를 통해 BigQuery 엔터프라이즈 할인 및 슬롯 약정을 활용할 수 있습니다.
맞춤 실행 ID를 구성하는 방법은 실행 ID 구성을 참고하세요.
네트워킹 요구사항
스캔을 실행하려면 스캔에 사용하는 VPC 서브넷에서 비공개 Google 액세스를 사용 설정해야 합니다. 서브넷을 지정하지 않은 경우 기본 서브넷에 비공개 Google 액세스가 사용 설정되어 있는지 확인합니다.
범위
표준 프로파일링 스캔의 경우 스캔할 데이터의 범위를 지정할 수 있습니다.
전체 테이블: 데이터 프로필 스캔에서 전체 테이블이 스캔됩니다. 샘플링, 행 필터, 열 필터는 프로파일링 통계를 계산하기 전에 전체 테이블에 적용됩니다.
증분: 지정한 증분 데이터가 데이터 프로필 스캔에서 스캔됩니다. 증분으로 사용할 테이블에서
Date또는Timestamp열을 지정합니다. 일반적으로 이 테이블은 테이블의 파티션을 나눈 열입니다. 샘플링, 행 필터, 열 필터는 프로파일링 통계를 계산하기 전에 증분 데이터에 적용됩니다.
데이터 필터링
표준 프로파일링 스캔의 경우 행 필터와 열 필터를 사용하여 프로파일링을 위해 스캔할 데이터를 필터링할 수 있습니다. 필터를 사용하면 실행 시간과 비용을 줄이고 민감하거나 불필요한 데이터를 제외할 수 있습니다. 경량 프로파일링 검사에서는 열 필터와 행 필터를 지원하지 않습니다.
행 필터: 행 필터를 사용하면 특정 기간 또는 특정 세그먼트(예: 리전)의 데이터에 집중할 수 있습니다. 예를 들어 특정 날짜 이전의 타임스탬프를 사용하여 데이터를 필터링할 수 있습니다.
열 필터: 열 필터를 사용하면 데이터 프로필 스캔을 실행할 테이블에서 특정 열을 포함하거나 제외할 수 있습니다.
샘플 데이터
표준 프로파일링 스캔의 경우 데이터 프로필 스캔을 실행하기 위해 데이터에서 샘플링할 레코드의 비율을 지정할 수 있습니다. 더 작은 데이터 샘플에 데이터 프로필 스캔을 만들면 전체 데이터 세트 쿼리 실행 시간과 비용을 줄일 수 있습니다.
여러 데이터 프로필 스캔
Google Cloud 콘솔을 사용하여 한 번에 데이터 프로필 스캔 여러 개를 만들 수 있습니다. 데이터 세트 하나에서 테이블을 최대 100개까지 선택하고 데이터 세트마다 데이터 프로필 스캔을 만들 수 있습니다. 자세한 내용은 여러 데이터 프로필 스캔 만들기를 참조하세요.
BigQuery 테이블로 스캔 결과 내보내기
추가 분석에 사용할 수 있도록 데이터 프로필 스캔 결과를 BigQuery 테이블로 내보낼 수 있습니다. 보고를 맞춤설정하려면 BigQuery 테이블 데이터를 Looker 대시보드에 연결하면 됩니다. 여러 스캔에서 같은 결과 테이블을 사용하여 집계 보고서를 빌드할 수 있습니다.
데이터 프로파일링 결과
데이터 프로파일링 결과에는 다음 값이 포함됩니다.
| 열 유형 | 데이터 프로파일링 결과 |
|---|---|
| 숫자 열 |
|
| 문자열 열 |
|
| 중첩되지 않은 기타 열(날짜, 시간, 타임스탬프, 바이너리 등) |
|
| 다른 모든 중첩 또는 복합 데이터 유형 열(예: 레코드, 배열, JSON) 또는 반복 모드가 사용 설정된 모든 열 |
|
모든 작업에서 스캔된 레코드 수가 결과에 포함됩니다.
보고 및 모니터링
다음 보고서 및 메서드를 사용하여 데이터 프로파일링 결과를 모니터링하고 분석할 수 있습니다.
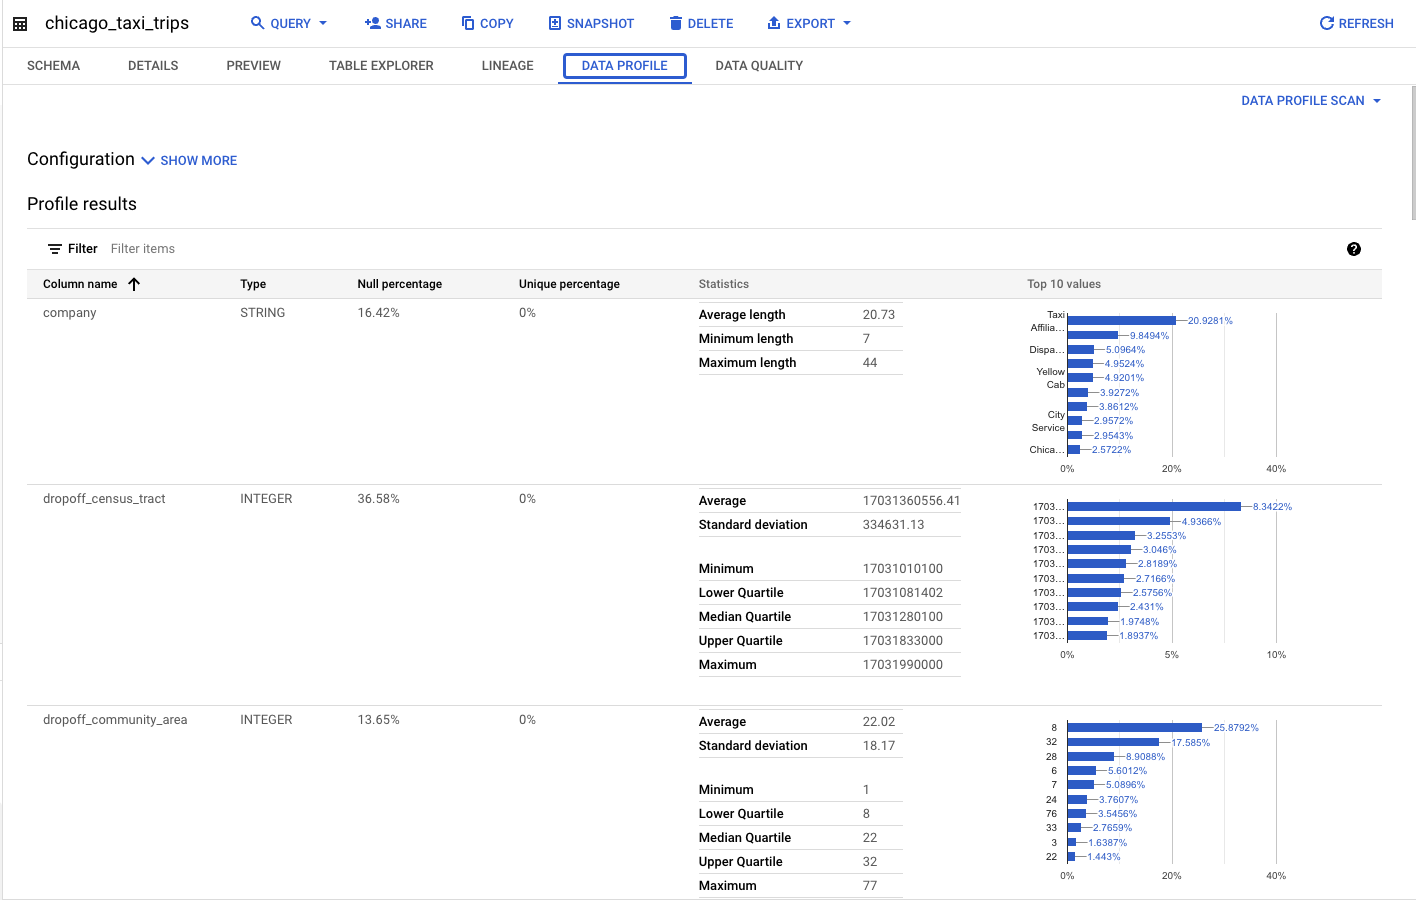
BigQuery 및 Knowledge Catalog 페이지에서 소스 테이블과 함께 게시된 보고서
BigQuery 및 Knowledge Catalog에 결과를 게시하도록 데이터 프로필 스캔을 구성한 경우 BigQuery와 Knowledge Catalog 모두에서 소스 테이블의 데이터 프로필 탭에 최신 데이터 프로필 스캔 결과를 볼 수 있습니다. 이러한 결과는 모든 프로젝트에서 액세스할 수 있습니다.
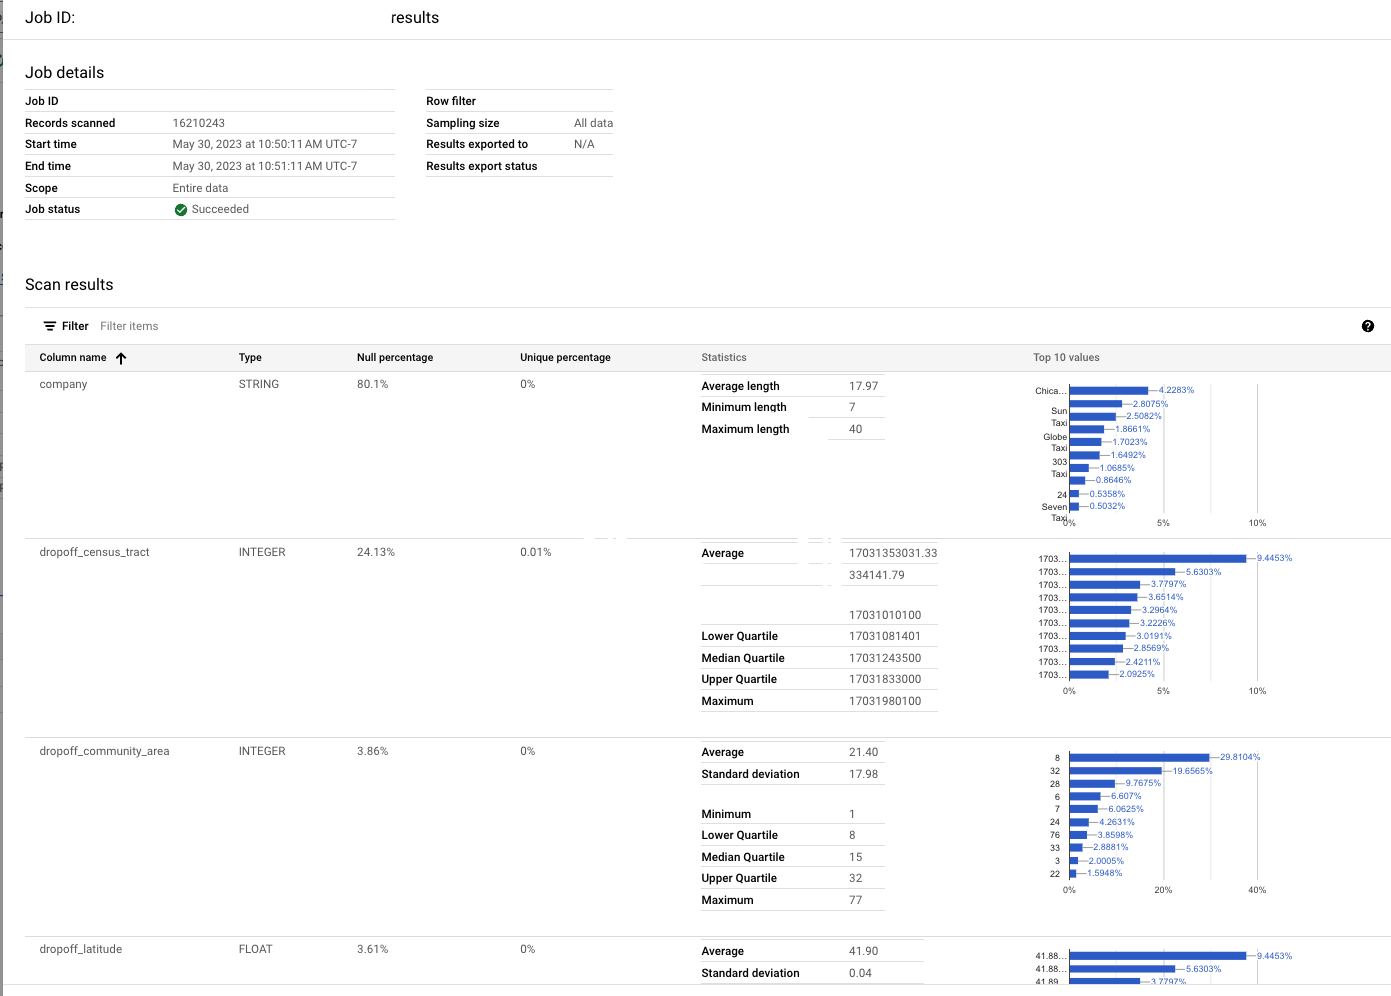
작업별 기록 보고서
Knowledge Catalog 및 BigQuery의 데이터 프로파일링 및 품질 > 데이터 프로필 스캔 페이지에서 최신 작업과 이전 작업에 대한 세부정보 보고서를 볼 수 있습니다. 이러한 보고서에는 열 수준 프로필 정보와 사용된 구성이 포함됩니다.
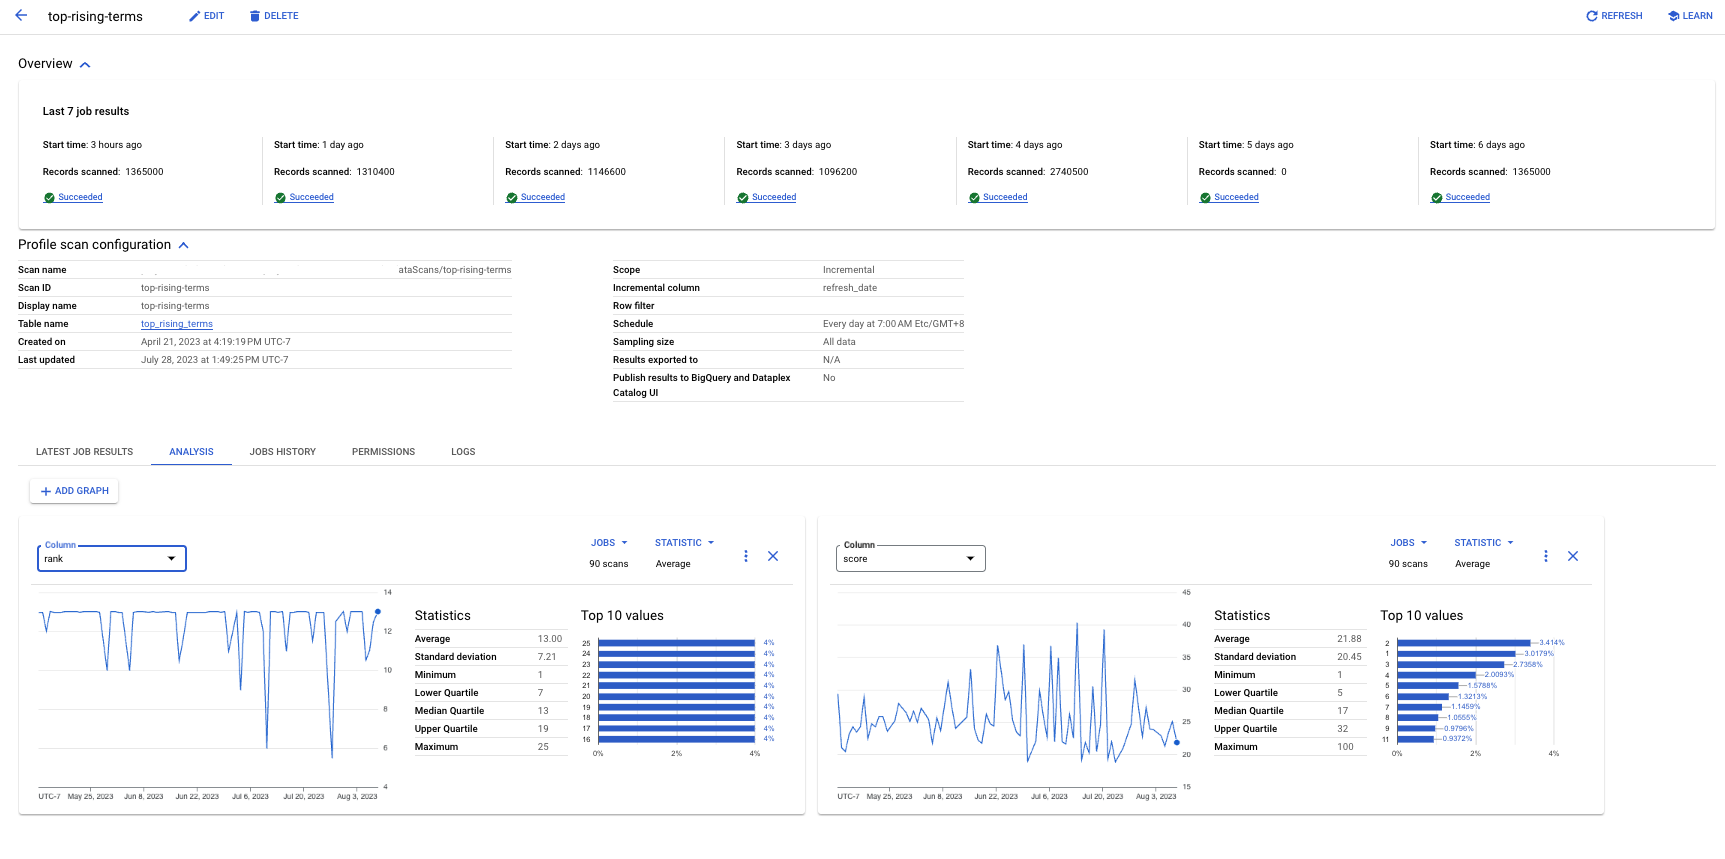
분석 탭
Knowledge Catalog 및 BigQuery의 데이터 프로파일링 및 품질> 데이터 프로필 스캔 페이지에서 분석 탭을 사용하여 여러 프로필 작업에 대한 특정 열 통계 추세를 볼 수 있습니다. 예를 들어 증분 스캔이 있으면 시간 경과에 따른 값의 평균 추세를 확인할 수 있습니다.
자체 대시보드 또는 분석 빌드
데이터 프로필 스캔에서 결과를 BigQuery 테이블로 내보내도록 구성한 경우 데이터 스튜디오와 같은 도구를 사용하여 자체 대시보드를 빌드할 수 있습니다.
Cloud Billing에서 DCU 컴퓨팅 비용 모니터링
데이터 프로파일링 스캔 컴퓨팅은 서버리스 인프라에서 실행되며 시계열 측정항목을 Cloud Monitoring에 내보내지 않습니다. 프로젝트, 스캔 ID 또는 테이블별로 데이터 프로필링 DCU 비용을 추적하고 기여도를 부여하려면
goog-dataplex-datascan-*시스템 라벨을 사용하여 BigQuery에서 Cloud Billing 내보내기를 쿼리하세요. 자세한 내용은 Cloud Billing 내보내기로 Dataplex DCU 비용 모니터링 및 기여도 분석을 참고하세요.
제한사항
- BigQuery, Google Cloud Lakehouse Iceberg REST 카탈로그, SAP BDC Delta Lake, Hive 테이블에서만 데이터 프로필 스캔을 실행할 수 있습니다.
- 데이터 프로파일링은
BIGNUMERIC을 제외한 모든 열 유형의 BigQuery 테이블에 지원됩니다.BIGNUMERIC열이 있는 테이블에 대한 스캔을 만들면 검증 오류가 발생하고 생성에 실패합니다. - Lakehouse 테이블에는 여러 데이터 프로필 스캔이 지원되지 않습니다.
가격 책정
- 가격에 대한 자세한 내용은 Knowledge Catalog 가격 책정을 참고하세요.
- BigQuery로 Cloud Billing 내보내기를 사용하여 데이터 프로파일링 스캔 DCU 사용량 및 비용을 추적하고 기여도를 부여하려면 Cloud Billing 내보내기로 Dataplex DCU 비용 모니터링 및 기여도 부여를 참고하세요.
다음 단계
- 데이터 프로파일링을 사용하는 방법 알아보기
- 데이터 프로필 스캔을 만드는 데 사용할 수 있는 Terraform 리소스에 대한 자세한 내용은 다음을 참조하세요.
- Terraform 레지스트리의 Knowledge Catalog 데이터 스캔 리소스
- GitHub의 Knowledge Catalog 데이터 스캔 리소스 문서(YAML 기반 규칙 구성 지원)
- 자동 데이터 품질 알아보기
- 자동 데이터 품질 사용 방법 알아보기
- 데이터 인사이트를 생성하여 데이터를 탐색하는 방법을 알아보세요.