


Knowledge Catalog(旧称 Dataplex Universal Catalog)を使用すると、分散データ資産全体で技術構造、ビジネス コンテキスト、データ品質指標、運用関係を自動的に検出してインデックスに登録できます。Knowledge Catalog は、このメタデータを柔軟で拡張可能なメタモデルとアクティブなコンテキスト グラフに整理し、データアセットの管理と生成 AI エージェントのグラウンディングに役立ちます。
Knowledge Catalog メタモデル
Knowledge Catalog メタモデルは、統合された構造化メタデータ管理を提供し、Google の Agentic Data Cloud 内の Active Context Graph の構造基盤を確立します。このコンテキスト グラフは、ユーザーとデータチームがアセットを検出して管理するのに役立ち、生成 AI エージェントがグラウンディングされた信頼できるビジネス コンテキストを取得できるようにします。
Knowledge Catalog は、コンテナ、アセット、スキーマ、関係のモジュラー階層を通じてメタデータを整理します。
- コンテナとアセット: エントリ グループは、個々のデータアセットとそのスキーマ列を表すエントリを整理します。
- 構造化された拡充: アスペクト タイプは、エントリ、列、関係に構造化メタデータをアタッチするアスペクトのスキーマを定義します。
- 標準とガバナンス: エントリタイプは、エントリに必要なアスペクトを適用するテンプレートを定義します。
- 関係: エントリリンク タイプは、関連するエントリとビジネス用語を接続する関係(エントリリンク)を定義します。
次の表に、システム管理リソース( Google Cloudによって自動的に提供される)とユーザー定義のカスタム リソースの違いをまとめます。
| メタモデル要素 | システム マネージド(組み込み) | ユーザー定義(カスタム) |
|---|---|---|
| エントリ グループ | Google Cloud サービス(@bigquery、@spanner、@pubsub など)ごとに事前定義されています。 |
カスタム データアセットと権限をグループ化して管理するためにユーザーが作成します。 |
| エントリ | Google Cloud ソース(BigQuery テーブル、ビュー、データセット、モデルなど)から自動的に入力されます。 | ユーザーが作成し、カスタム データソース、ファイル、サードパーティ データベースを表します。 |
| アスペクト タイプ | 事前定義されたシステム テンプレート(Schema、Overview、Contacts、DataQuality、Lineage など)。 |
ユーザーが作成し、ドメイン固有のメタデータ スキーマ(PII 分類や SLA ティアなど)を定義します。 |
| アスペクト | ソースシステム、クエリログ、または自動スキャンから自動的に入力されます。 | ユーザー、パイプライン、エージェントによって作成され、エントリ、列、エントリリンクにアタッチされます。 |
| エントリタイプ | Google Cloud リソースタイプを表す事前定義されたテンプレート。 | カスタム データアセットの必須アスペクトとオプションのアスペクトを指定するためにユーザーが定義します。 |
| エントリリンク | 組み込みの関係タイプ(synonym、definition、schema-join、related など)。 |
システム間の接続をモデル化するために、特定のエントリまたは列の間に作成されたインスタンス。 |
以降のセクションでは、Knowledge Catalog のメタモデルを構成する主なコンポーネントについて説明します。
エントリ グループ
エントリ グループ(EntryGroup)は、エントリとエントリ リンクのリージョン コンテナであり、これらのリソースを管理するための管理境界とセキュリティ境界として機能します。
エントリ グループを使用して、次の項目を構成します。
- Identity and Access Management のアクセス制御: 個々のエントリ権限を変更することなく、エントリ グループの特定のチームに表示権限または編集権限を付与します。
- ロケーションとプロジェクトの属性: 地理的リージョンとプロジェクトの所有権でアセットをグループ化します。
Google Cloud ソースの場合、Knowledge Catalog はプロジェクトごとにシステム エントリ グループ(@bigquery や @spanner など)を自動的に作成します。カスタム データソースの場合は、カスタム エントリ グループを作成します。
たとえば、ファイナンス チームは production_finance_data という名前のカスタム エントリ グループを作成して、財務関連のすべてのカスタム エントリのアクセス権限を 1 か所で管理できます。
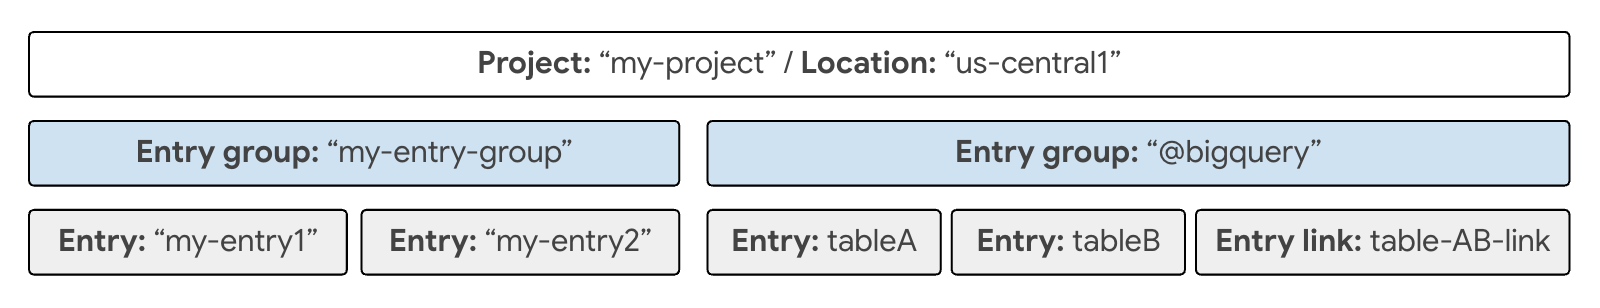
詳細については、エントリ グループをご覧ください。
エントリとスキーマパス
エントリ(Entry)は、単一のデータアセットを表します。エントリは、構造化データベース テーブル、分析モデル、非構造化オブジェクト テーブル、カスタム外部データセットを表すことができます。
エントリの主なコンポーネントは次のとおりです。
- エントリ識別子: 親エントリ グループ内の一意のリソース名。
- エントリタイプ: エントリの構造と必須アスペクトを定義するテンプレート。
- アスペクト: エントリにアタッチされた構造化メタデータ属性。
- スキーマパス(列): データアセット内の特定のサブセクションまたはフィールド(BigQuery テーブルの列や JSON スキーマのフィールドなど)。
列を使用すると、アセット内の個々のフィールドにメタデータを追加できます。列は手動で定義しません。schema タイプのアスペクトをエントリに付加すると、列が入力されます。ネストされたフィールドは、ドット表記のパス(customer.address.postal_code など)を使用して参照できます。
たとえば、orders_project.sales.customer_orders という名前の BigQuery テーブルはエントリとして表されます。そのテーブル内の email_address フィールドに機密情報が含まれていることを記述するには、分類アスペクトを email_address 列パスに直接適用します。
詳細については、エントリをご覧ください。
アスペクト タイプ
アスペクト タイプ(AspectType)は、アスペクトのフィールド、データ型、検証ルールを定義する再利用可能なスキーマ テンプレートです。各アスペクトは、アスペクト タイプのインスタンスです。
アスペクト タイプは、システム定義( Google Cloudによって提供)またはカスタム(組織によって作成)にできます。
カスタム アスペクト タイプの metadata_template を定義する場合は、次のサポートされているデータ型を使用できます。
| フィールドのデータ型 | 説明 | 使用例 |
|---|---|---|
string |
テキスト値(UTF-8)。 | オーナーのメールアドレス、データ分類ラベル、部門名。 |
integer/number |
数値(整数または浮動小数点数)。 | データ保持日数、SLA 目標達成率、優先度ランク。 |
boolean |
true または false のフラグ。 | contains_pii: true、is_certified: false。 |
enum |
使用できる文字列値の事前定義されたリスト。 | 環境: ["DEV", "STAGING", "PROD"]。 |
datetime/timestamp |
ISO 8601 形式の日付と時刻。 | 最終認定日、コンプライアンス レビューの期限。 |
record |
子フィールドを含むネストされた構造化オブジェクト。 | ContactInfo { name: string, email: string, phone: string }。 |
array |
任意のプリミティブ型またはレコード型の繰り返し値のリスト。 | セカンダリ データオーナーのリスト: ["user1@example.com", "user2@example.com"]。 |
map |
拡張可能な属性の Key-Value 文字列ペア。 | カスタム デプロイタグ: {"cost_center": "1042", "tier": "gold"}。 |
たとえば、連絡先情報の再利用可能なテンプレートを定義するには、owner_name(string)、email(string)、support_channel(string)のフィールドを含む ContactInfo という名前のアスペクト タイプを作成します。

詳細については、アスペクト タイプをご覧ください。
アスペクト
アスペクト(Aspect)は、アスペクト タイプに準拠する関連するメタデータ フィールドのセットです。アスペクトは、エントリ、エントリパス(列)、またはエントリリンクにアタッチされ、そのリソースを説明します。
以前のタグ付けシステムとは異なり、Knowledge Catalog のアスペクトは親エントリまたはエントリリンク内に直接カプセル化されるため、アトミックな読み取りオペレーションと書き込みオペレーションを実行できます。
アスペクトは、複数の関数で使用されます。
- 技術構造:
Schemaアスペクトは、テーブルの列、データ型、説明を記述します。 - ビジネス コンテキスト: カスタム アスペクトは、オーナー権限、コンプライアンス、ライフサイクル ステータスを記述します。
- 運用上の信頼性: データ品質の側面には、自動ルールスキャンの結果と検証スコアが記録されます。
- 非構造化エンティティ グラフ:
GraphProfileアスペクトは、未加工のファイルから AI によって抽出されたエンティティと関係のエッジをキャプチャします。
たとえば、値 {"owner_name": "Alex", "email": "alex@example.com"} を持つ ContactInfo アスペクト タイプのインスタンスを作成し、customer_orders エントリに接続できます。
詳細については、アスペクトをご覧ください。
エントリタイプ
エントリタイプ(EntryType)は、カスタム エントリを作成するためのガバナンス テンプレートです。このタイプのエントリに付加する必要がある必須のアスペクト タイプを設定することで、メタデータの品質基準を適用します。
特定のエントリタイプのエントリを作成すると、Knowledge Catalog は、エントリタイプで required としてマークされているすべてのアスペクト タイプが存在し、有効であることを検証します。
たとえば、OwnerInfo アスペクト タイプと DataRetentionPolicy アスペクト タイプを必須として指定する CertifiedDataProduct という名前のエントリタイプを作成できます。このエントリタイプで作成された新しいエントリは、保存する前にこれらのアスペクトを含める必要があります。
詳細については、エントリタイプをご覧ください。
エントリリンクとエントリリンク タイプ
エントリリンク(EntryLink)は、2 つのデータ エントリ間、またはエントリ内の特定の列間のセマンティック関係を確立します。すべてのエントリリンクは、エントリリンク タイプ(EntryLinkType)のインスタンスです。
エントリ リンクには、方向性のあるものと方向性のないものがあります。
- 対称(非方向性): 両側がピアである関係(
synonym、related、schema-joinなど)。 - 非対称(方向性あり): 明示的なソースとターゲットを持つ関係(例:
definition。ビジネス用語集の用語をテーブル列にリンクする)。
アスペクトをエントリリンクに直接関連付けることもできます(schema-join リンクを除く)。これにより、結合の信頼度スコア、変換ルール、マッピング ノートの記録など、関係自体を記述できます。
Knowledge Catalog は、次の組み込みエントリリンク タイプをサポートしています。
synonym: 同等のビジネス コンセプトまたは代替用語を接続します。related: システム間で疎結合されたアセットを接続します。definition: ビジネス用語集の定義を物理列または エントリに接続します。schema-join: 一致する外部キーまたはスキーマパスに沿って結合できるテーブルを接続します。

詳細については、EntryLinks REST リファレンスをご覧ください。
ビジネス用語集と用語
ビジネス用語集を使用すると、用語集、カテゴリ、ビジネス用語を定義して、正式なビジネス分類を確立できます。
definition または synonym タイプのエントリリンクを使用すると、ビジネス用語を物理エントリと列パスに直接マッピングできます。ユーザーまたは AI エージェントが自然言語を使用してカタログを検索すると、検索エンジンはこれらのビジネス用語を解決して、正しい物理データアセットを見つけます。
詳細については、ビジネス用語集を管理するをご覧ください。
サポートされている Google Cloud ソース
Knowledge Catalog は、次のGoogle Cloud ソースからメタデータを自動的に取り込みます。AlloyDB for PostgreSQL や Cloud SQL などの一部のサービスでは、メタデータを取り込む前に、まず Knowledge Catalog の統合を有効にする必要があります。
分析とレイクハウス
- BigQuery のデータセット、テーブル、ビュー、モデル、ルーティン、接続、リンクされたデータセット、グラフ(プレビュー)
- BigQuery Sharing(旧 Analytics Hub)のエクスチェンジとリスティング
- Dataform リポジトリとコードアセット
- Dataproc Metastore のサービス、データベース、テーブル
Iceberg REST カタログ テーブル( Google Cloud Lakehouse ランタイム カタログ IRC、Databricks Unity IRC、AWS Glue Data Catalog IRC、Snowflake Horizon IRC を含む)
Apache Hive テーブル
SAP Business Data Cloud(BDC)Delta Lake テーブル
Lakehouse ランタイム カタログで管理される Apache Iceberg テーブル
AI と機械学習
- Vertex AI のモデル、データセット、特徴グループ、特徴ビュー、オンライン ストア インスタンス
ビジネス インテリジェンス
- Looker(Google Cloud コア)インスタンス、ダッシュボード、ダッシュボードの要素、Look、LookML プロジェクト、モデル、Explore、ビュー(プレビュー)
データベース
- Bigtable のインスタンス、クラスタ、テーブル(列ファミリーの詳細を含む)
- Spanner のインスタンス、データベース、テーブル、ビュー
ストリーミングとメッセージング
- Pub/Sub トピック
非構造化データ
オペレーショナル データベース
- AlloyDB for PostgreSQL のクラスタ、インスタンス、データベース、スキーマ、テーブル、ビュー(プレビュー)。Knowledge Catalog は、AlloyDB プライマリ インスタンスからのみメタデータを取得し、リードレプリカからは取得しません。詳細については、Knowledge Catalog を使用して AlloyDB for PostgreSQL リソースを管理するをご覧ください。
- Cloud SQL インスタンス、データベース、スキーマ、テーブル、ビュー。Knowledge Catalog は、Cloud SQL プライマリ インスタンスからのみメタデータを取得し、リードレプリカからは取得しません。詳細については、Knowledge Catalog を使用して Cloud SQL リソースを管理するをご覧ください。
サードパーティ ソースから Knowledge Catalog にメタデータをインポートするには、Knowledge Catalog コネクタまたはマネージド接続パイプラインを使用します。詳細については、Knowledge Catalog コネクタについてとマネージド接続の概要をご覧ください。
プロジェクトとロケーションの制約
Knowledge Catalog のカタログ リソースは、特定の Google Cloud プロジェクトと地理的位置に保存されます。次のスコーピング制約が適用されます。
| リソース | ロケーション ルール | プロジェクト ルール |
|---|---|---|
| Entries | エントリのロケーションは、その EntryType のロケーションと一致しているか、EntryType が global である必要があります。 |
グローバルまたは同じプロジェクトのエントリ タイプを参照できます。 |
| エントリのアスペクト | アスペクトの AspectType は、エントリと同じロケーションに保存されているか、AspectType が global である必要があります。 |
グローバルまたは同じプロジェクトのアスペクト タイプを参照できます。 |
| エントリ リンク | エントリリンクのロケーションは EntryLinkType と一致しているか、EntryLinkType が global である必要があります。 |
同じ組織内の異なるプロジェクトに存在するエントリをリンクできます。 |
| エントリタイプ | エントリタイプと同じロケーションに保存されているアスペクト タイプ、または global であるアスペクト タイプで構成されます。 |
エントリタイプがカスタム アスペクト タイプを参照する場合、アスペクト タイプは同じプロジェクトとロケーションに存在する必要があります。 |
メタデータ変更フィード
Knowledge Catalog は、メタデータ変更フィードを使用して、メタデータ変更イベントを準リアルタイムでストリーミングできます。
メタデータ変更フィードは、エントリの作成、更新、削除に関する通知を、構成した Pub/Sub トピックにパブリッシュします。サブスクライバー クライアントは、これらのイベントを使用して、スキーマの変更時にデータ品質評価をトリガーしたり、ダウンストリーム ガバナンス ダッシュボードを更新したりするなど、運用ワークフローを自動化できます。
詳細については、メタデータ変更フィードについてをご覧ください。
料金
Knowledge Catalog では、メタデータ ストレージ SKU に基づいて保存されたメタデータ量に対して料金が請求されます。詳細については、Knowledge Catalog の料金をご覧ください。
以下の機能の使用に対して料金は発生しません。
- カタログ メタモデル リソース(エントリタイプ、アスペクト タイプ、エントリ グループ、エントリ、エントリリンク)の作成と管理。
- Google Cloud コンソールで実行された検索 API 呼び出しと検索クエリ。