


O Knowledge Catalog (antigo Dataplex Universal Catalog) permite descobrir e indexar automaticamente estruturas técnicas, contexto de negócios, métricas de qualidade de dados e relações operacionais em todo o seu patrimônio de dados distribuído. O Knowledge Catalog organiza esses metadados em um metamodelo flexível e extensível e em um gráfico de contexto ativo que ajuda a governar recursos de dados e fundamentar agentes de IA generativa.
Metamodelo do Knowledge Catalog
O metamodelo do Knowledge Catalog oferece gerenciamento unificado e estruturado de metadados e estabelece a base estrutural do Gráfico de Contexto Ativo na nuvem de dados agêntica do Google. Esse gráfico de contexto ajuda você e suas equipes de dados a descobrir e governar recursos, além de permitir que os agentes de IA generativa recuperem um contexto de negócios fundamentado e confiável.
O Knowledge Catalog organiza os metadados por uma hierarquia modular de contêineres, recursos, esquemas e relações:
- Contêineres e recursos: os grupos de entradas organizam as entradas, que representam recursos de dados individuais e as colunas de esquema deles.
- Enriquecimento estruturado: os tipos de aspecto definem esquemas para aspectos, que anexam metadados estruturados a entradas, colunas ou relacionamentos.
- Padrões e governança: os tipos de entrada definem modelos que aplicam aspectos obrigatórios nas entradas.
- Relacionamentos: os tipos de link de entrada definem relacionamentos (links de entrada) que conectam entradas e termos de negócios relacionados.
A tabela a seguir resume a distinção entre recursos gerenciados pelo sistema (fornecidos automaticamente pelo Google Cloud) e recursos personalizados definidos pelo usuário:
| Elemento do metamodelo | Gerenciada pelo sistema (integrada) | Definido pelo usuário (personalizado) |
|---|---|---|
| Grupos de entrada | Predefinido por projeto para serviços do Google Cloud (por exemplo,
@bigquery, @spanner, @pubsub). |
Criados por usuários para agrupar e gerenciar recursos de dados personalizados e permissões. |
| Entradas | Preenchidos automaticamente com base em fontes do Google Cloud , como tabelas do BigQuery, visualizações, conjuntos de dados e modelos. | Criados por usuários para representar fontes de dados, arquivos ou bancos de dados de terceiros personalizados. |
| Tipos de aspecto | Modelos de sistema predefinidos (por exemplo, Schema,
Overview, Contacts, DataQuality,
Lineage). |
Criados por usuários para definir esquemas de metadados específicos de domínio (como classificação de PII ou níveis de SLA). |
| Aspectos | Preenchido automaticamente com base em sistemas de origem, registros de consulta ou verificações automatizadas. | Criadas por usuários, pipelines ou agentes e anexadas a entradas, colunas ou links de entrada. |
| Tipos de entrada | Modelos predefinidos que representam tipos de recursos do Google Cloud . | Definidos pelos usuários para especificar aspectos obrigatórios e opcionais para recursos de dados personalizados. |
| Links de entrada | Tipos de relacionamento integrados (como synonym,
definition, schema-join,
related). |
Instâncias criadas entre entradas ou colunas específicas para modelar conexões entre sistemas. |
As seções a seguir descrevem os principais componentes que compõem o metamodelo do Knowledge Catalog.
Grupos de entradas
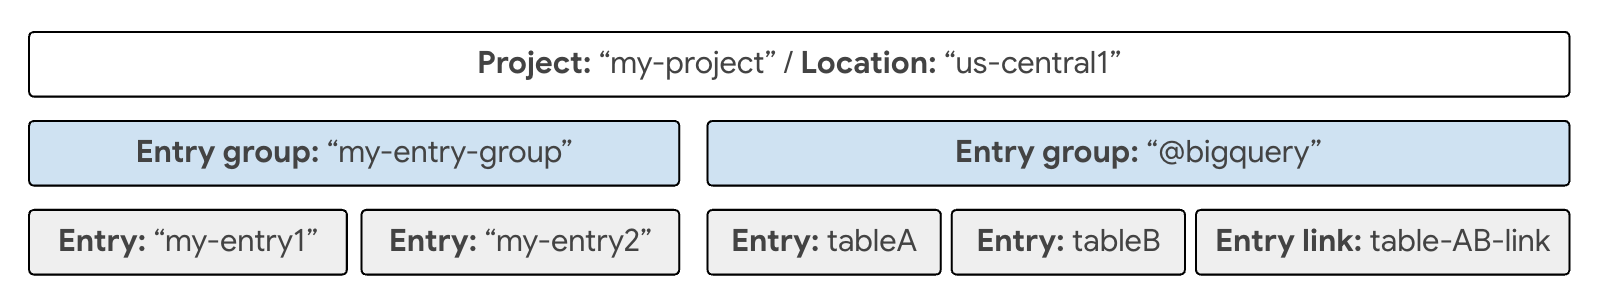
Um grupo de entradas (EntryGroup) é um contêiner regional para entradas e links de entrada que atua como o limite administrativo e de segurança para gerenciar esses recursos.
Use grupos de entrada para configurar o seguinte:
- Controle de acesso do Identity and Access Management: conceda permissões de visualização ou edição a equipes específicas em um grupo de entradas sem modificar as permissões de entrada individuais.
- Atribuição de local e proprietário do projeto: agrupe ativos por região geográfica e propriedade do projeto.
Para fontes do Google Cloud , o Knowledge Catalog cria
grupos de entrada do sistema por projeto automaticamente (como @bigquery ou
@spanner). Para fontes de dados personalizadas, você cria grupos de entrada personalizados.
Por exemplo, uma equipe financeira pode criar um grupo de entradas personalizadas chamado
production_finance_data para gerenciar as permissões de acesso de todas as entradas personalizadas
relacionadas a finanças em um único local.
Para mais informações, consulte Grupos de entrada.
Entradas e caminhos de esquema
Uma entrada (Entry) representa um único recurso de dados. Uma entrada pode representar uma
tabela de banco de dados estruturada, um modelo analítico, uma tabela de objetos não estruturada ou
um conjunto de dados externo personalizado.
Os principais componentes de uma entrada incluem:
- Identificador de entrada: um nome de recurso exclusivo no grupo de entrada pai.
- Tipo de entrada: o modelo que define a estrutura da entrada e os aspectos obrigatórios.
- Aspectos: atributos de metadados estruturados anexados à entrada.
- Caminhos de esquema (colunas): subseções ou campos específicos no recurso de dados, como uma coluna em uma tabela do BigQuery ou um campo em um esquema JSON.
As colunas permitem anexar metadados a campos individuais em um recurso. Não é preciso definir colunas manualmente. Elas são preenchidas quando você anexa um aspecto do tipo schema a uma entrada. É possível referenciar campos aninhados usando caminhos de notação de ponto
(por exemplo, customer.address.postal_code).
Por exemplo, uma tabela do BigQuery chamada
orders_project.sales.customer_orders é representada como uma entrada. Para descrever
o campo email_address nessa tabela como contendo informações
sensíveis, anexe um aspecto de classificação diretamente ao
caminho da coluna email_address.
Para mais informações, consulte Entradas.
Tipos de aspecto
Um tipo de aspecto (AspectType) é um modelo de esquema reutilizável que define os campos, os tipos de dados e as regras de validação de um aspecto. Todo aspecto é uma instância de um tipo de aspecto.
Os tipos de aspecto podem ser definidos pelo sistema (fornecidos pelo Google Cloud) ou personalizados (criados pela sua organização).
Ao definir o metadata_template para um tipo de aspecto personalizado, é possível usar
os seguintes tipos de dados compatíveis:
| Tipo de dados do campo | Descrição | Exemplo de caso de uso: |
|---|---|---|
string |
Valor do texto (UTF-8). | E-mail do proprietário, rótulo de classificação de dados, nome do departamento. |
integer / number |
Valores numéricos (números inteiros ou de ponto flutuante). | Dias de retenção de dados, porcentagem de meta do SLA, classificação de prioridade. |
boolean |
Sinalização de verdadeiro ou falso. | contains_pii: true, is_certified: false. |
enum |
Uma lista predefinida de valores de string permitidos. | Ambiente: ["DEV", "STAGING", "PROD"]. |
datetime / timestamp |
Data e hora formatadas de acordo com a ISO 8601. | Data da última certificação, prazo para revisão de compliance. |
record |
Um objeto estruturado aninhado que contém campos filhos. | ContactInfo { name: string, email: string, phone: string }. |
array |
Uma lista de valores repetidos de qualquer tipo primitivo ou de registro. | Lista de proprietários de dados secundários: ["user1@example.com", "user2@example.com"]. |
map |
Pares de strings de chave-valor para atributos extensíveis. | Tags de implantação personalizadas: {"cost_center": "1042", "tier": "gold"}. |
Por exemplo, para definir um modelo reutilizável para dados de contato, crie um tipo de aspecto chamado ContactInfo com campos para owner_name (string), email (string) e support_channel (string).

Para mais informações, consulte Tipos de aspecto.
Aspectos
Um aspecto (Aspect) é um conjunto de campos de metadados relacionados que está em conformidade com um tipo de aspecto. Os aspectos são anexados a uma entrada, um caminho de entrada (coluna) ou um link de entrada para descrever esse recurso.
Ao contrário dos sistemas de inclusão de tags legados, os aspectos no Knowledge Catalog são encapsulados diretamente nas entradas pai ou nos links de entrada, o que permite realizar operações atômicas de leitura e gravação.
Os aspectos são usados em várias funções:
- Estrutura técnica: o aspecto
Schemadescreve as colunas, os tipos de dados e as descrições da tabela. - Contexto de negócios: os aspectos personalizados descrevem a propriedade, a conformidade e o status do ciclo de vida.
- Confiança operacional: os aspectos de qualidade de dados registram os resultados da verificação de regras automatizadas e as pontuações de validação.
- Grafos de entidades não estruturados: o aspecto
GraphProfilecaptura entidades extraídas por IA e arestas de relacionamento de arquivos brutos.
Por exemplo, é possível criar uma instância do tipo de aspecto ContactInfo com os valores {"owner_name": "Alex", "email": "alex@example.com"} e anexá-la à entrada customer_orders.
Para mais informações, consulte Aspectos.
Tipos de entrada
Um tipo de entrada (EntryType) é um modelo de governança para criar entradas personalizadas. Ele aplica padrões de qualidade de metadados estabelecendo os tipos de aspecto
obrigatórios que precisam ser anexados a uma entrada desse tipo.
Quando você cria uma entrada de um tipo específico,
o Knowledge Catalog valida se todos os tipos de aspecto
marcados como required no tipo de entrada estão presentes e são válidos.
Por exemplo, é possível criar um tipo de entrada chamado CertifiedDataProduct
que especifica os tipos de aspecto OwnerInfo e DataRetentionPolicy como
obrigatórios. Qualquer nova entrada criada com esse tipo de entrada precisa incluir esses aspectos antes de ser salva.
Para mais informações, consulte Tipos de entrada.
Links de entrada e tipos de link de entrada
Um link de entrada (EntryLink) estabelece uma relação semântica entre duas entradas de dados
ou entre colunas específicas dentro das entradas. Cada link de entrada é uma
instância de um tipo de link de entrada (EntryLinkType).
Os links de entrada podem ser direcionais ou não direcionais:
- Simétrica (não direcional): relações em que os dois lados são pares
(por exemplo,
synonym,relatedouschema-join). - Assimétrica (direcional): relações com uma origem e um destino explícitos (por exemplo,
definition, que vincula um termo do glossário empresarial a uma coluna de tabela).
Também é possível anexar aspectos diretamente aos links de entrada (exceto para links schema-join). Isso permite descrever o relacionamento em si, como registrar pontuações de confiança de mesclagem, regras de transformação ou notas de mapeamento.
O Knowledge Catalog é compatível com os seguintes tipos de link de entrada integrados:
synonym: conecta conceitos de negócios equivalentes ou termos alternativos.related: conecta recursos acoplado com flexibilidade entre sistemas.definition: conecta as definições do glossário empresarial a colunas ou entradas físicas.schema-join: conecta tabelas que podem ser mescladas por caminhos de esquema ou chave externa correspondentes.

Para mais informações, consulte a
referência REST de EntryLinks.
Glossários e termos empresariais
Com um glossário empresarial, é possível estabelecer uma taxonomia empresarial formal definindo glossários, categorias e termos comerciais.
Usando links de entrada do tipo definition ou synonym, é possível mapear termos de negócios
diretamente para entradas físicas e caminhos de coluna. Quando usuários ou agentes de IA pesquisam
o catálogo usando linguagem natural, o mecanismo de pesquisa resolve esses termos
de negócios para localizar os recursos de dados físicos corretos.
Para mais informações, consulte Gerenciar glossários empresariais.
Fontes do Google Cloud compatíveis
O Knowledge Catalog ingere automaticamente metadados das seguintes fontes doGoogle Cloud . Para alguns serviços, como o AlloyDB para PostgreSQL e o Cloud SQL, é necessário ativar a integração do Knowledge Catalog antes que os metadados possam ser ingeridos:
Análise e lakehouse
- Conjuntos de dados, tabelas, visualizações, modelos, rotinas, conexões, conjuntos de dados vinculados e gráficos (pré-lançamento) do BigQuery
- Trocas e listagens do BigQuery Sharing (antigo Analytics Hub)
- Repositórios e recursos de código do Dataform
- Serviços, bancos de dados e tabelas do Dataproc Metastore
Tabelas do catálogo REST do Iceberg (incluindo Google Cloud o catálogo do ambiente de execução do Lakehouse IRC, o Databricks Unity IRC, o AWS Glue Data Catalog IRC e o Snowflake Horizon IRC)
Tabelas do Apache Hive
Tabelas do Delta Lake do SAP Business Data Cloud (BDC)
Tabelas do Apache Iceberg gerenciadas pelo catálogo do ambiente de execução do Lakehouse
IA e machine learning
- Modelos de IA, conjuntos de dados, grupos de recursos, visualizações de recursos e instâncias de loja on-line da Vertex AI
Business intelligence
- Instâncias do Looker (Google Cloud Core), dashboards, elementos de dashboard, Looks, dashboards do LookML, elementos de dashboard do LookML, projetos do LookML, modelos, Análises, visualizações e agentes
Bancos de dados
- Instâncias, clusters e tabelas do Bigtable (incluindo detalhes do grupo de colunas)
- Instâncias, bancos de dados, tabelas e visualizações do Spanner
Streaming e mensagens
- Tópicos do Pub/Sub
Dados não estruturados
Bancos de dados operacionais
- Clusters, instâncias, bancos de dados, esquemas, tabelas e visualizações do AlloyDB para PostgreSQL (pré-lançamento). O Knowledge Catalog recupera metadados somente das instâncias principais do AlloyDB e não de réplicas de leitura. Para mais informações, consulte Gerenciar seus recursos do AlloyDB para PostgreSQL usando o Knowledge Catalog.
- Instâncias, bancos de dados, esquemas, tabelas e visualizações do Cloud SQL. O Knowledge Catalog recupera metadados somente das instâncias principais do Cloud SQL e não de réplicas de leitura. Para mais informações, consulte Gerenciar seus recursos do Cloud SQL usando o Knowledge Catalog.
Para importar metadados de uma fonte de terceiros para o Knowledge Catalog, use os conectores do Knowledge Catalog ou um pipeline de conectividade gerenciada. Para mais informações, consulte Sobre os conectores do Knowledge Catalog e Visão geral da conectividade gerenciada.
Restrições de projeto e local
Os recursos do catálogo no Knowledge Catalog são armazenados em projetos e localizações geográficas específicos do Google Cloud . As seguintes restrições de escopo se aplicam:
| Recurso | Regra de local | Regra do projeto |
|---|---|---|
| Entradas | O local da entrada precisa corresponder ao local do EntryType,
ou o EntryType precisa ser global. |
Pode referenciar tipos de entrada globais ou do mesmo projeto. |
| Aspectos nas entradas | O AspectType do aspecto precisa ser armazenado no mesmo local
que a entrada, ou o AspectType precisa ser global. |
Pode referenciar tipos de aspecto globais ou do mesmo projeto. |
| Links de entrada | O local do link de entrada precisa corresponder ao EntryLinkType ou
o EntryLinkType precisa ser global. |
Pode vincular entradas que residem em projetos diferentes na mesma organização. |
| Tipos de entrada | Composto por tipos de aspecto armazenados no mesmo local que o tipo de entrada
ou tipos de aspecto que são global. |
Se um tipo de entrada fizer referência a tipos de aspecto personalizados, eles precisarão estar no mesmo projeto e local. |
Feeds de mudanças de metadados
O Knowledge Catalog pode transmitir eventos de mudança de metadados quase em tempo real usando feeds de mudança de metadados.
Um feed de alterações de metadados publica notificações sobre a criação, atualização ou exclusão de entradas em um tópico do Pub/Sub que você configura. Os clientes assinantes podem consumir esses eventos para automatizar fluxos de trabalho operacionais, como acionar avaliações de qualidade de dados quando um esquema muda ou atualizar painéis de governança downstream.
Para mais informações, consulte Sobre feeds de alterações de metadados.
Preços
O Knowledge Catalog usa a SKU de armazenamento de metadados para cobrar pelo volume de metadados armazenados. Para mais informações, consulte Preços do Knowledge Catalog.
Não há cobranças para o seguinte:
- Criar e gerenciar recursos de metamodelo de catálogo (tipos de entrada, tipos de aspecto, grupos de entrada, entradas e links de entrada).
- Chamadas de API de pesquisa e consultas de pesquisa realizadas no console do Google Cloud .
A seguir
Adicionar metadados a uma tabela
Descobrir recursos e anexar metadados de aspecto personalizados a uma tabela do BigQuery.
Ingerir fontes de dados personalizadas
Defina tipos de entrada e ingira metadados personalizados de bancos de dados e pipelines externos.
Gerenciar glossários empresariais
Crie uma taxonomia de negócios e mapeie termos diretamente para tabelas e colunas físicas.
Pesquisar e descobrir recursos
Descubra recursos no Google Cloud e em fontes personalizadas usando predicados de pesquisa.
Recuperar contexto para agentes de IA
Recupere metadados prontos para LLM e contexto ativo para embasar agentes de IA generativa.