


En este documento, se describe cómo acceder a las métricas que genera tu app de Gemini Enterprise. Estas métricas proporcionan estadísticas sobre el rendimiento y el estado de tu aplicación.
Puedes ver la telemetría de las métricas con el Explorador de métricas o directamente en los agentes individuales con la pestaña Observabilidad del agente.
Conceptos clave
En esta sección, se presentan los conceptos clave relacionados con la observabilidad en Gemini Enterprise.
| Concepto | Descripción |
|---|---|
| Métricas | Las métricas son mediciones numéricas que los sistemas recopilan a lo largo del tiempo. Estas mediciones representan el rendimiento, el uso de recursos o el comportamiento de un sistema. Los ingenieros usan métricas para supervisar el estado del sistema, identificar tendencias y activar alertas. |
| Métricas centradas en el agente | Métricas que miden la actividad de un agente individual, como sus sesiones, turnos de conversación e invocaciones de herramientas. Se enumeran bajo el tipo de recurso Agente de Gemini Enterprise y se recopilan solo cuando la configuración de observabilidad Habilitar la instrumentación de seguimientos y registros de OpenTelemetry está activada para ese agente. |
| Métricas centradas en la app | Métricas que miden todo el tráfico a una app en lugar de a un solo agente, como el recuento de solicitudes y la latencia de extremo a extremo. Se enumeran en el tipo de recurso Motor de Gemini Enterprise, en el que Motor es el nombre de la API para una app de Gemini Enterprise, y se recopilan independientemente de la configuración de observabilidad. |
Antes de comenzar
Asegúrate de tener lo siguiente:
El rol de Administrador de Gemini Enterprise o el rol de Usuario de Gemini Enterprise de la Google Cloud consola.
Una app web de Gemini Enterprise existente. Para obtener información sobre cómo crear una app nueva, consulta Crea una app.
Para acceder al Explorador de métricas, debes tener el rol de Visualizador de Monitoring (
roles/monitoring.viewer).Habilita el parámetro de configuración de observabilidad Habilitar la instrumentación de seguimientos y registros de OpenTelemetry. Según el tipo de agente, habilita esta opción en las configuraciones a nivel de la app (para el agente de Asistente principal) o dentro de la pestaña Configuración del agente (para los agentes creados por empleados de Workflow Builder y los agentes de Deep Research). Para obtener más información, consulta Administra la configuración de observabilidad. Este parámetro de configuración es obligatorio para las métricas centradas en el agente. Las métricas centradas en la app, que se enumeran en el tipo de recurso Motor de Gemini Enterprise, se recopilan sin él.
Retención de datos
Las métricas que genera tu app de Gemini Enterprise se almacenan en
Cloud Monitoring en tu Google Cloud proyecto, y su retención se rige
por Cloud Monitoring. Las métricas de Gemini Enterprise se publican con el
discoveryengine.googleapis.com/ prefijo, que se incluye en el nivel "todas las demás
Google Cloud métricas" y se conserva durante 6 semanas de forma predeterminada. Los datos anteriores al período de retención se borran automáticamente. Para obtener los valores de retención autorizados
y más recientes, consulta
Retención de datos en la
documentación de cuotas y límites de Cloud Monitoring.
Accede a las métricas en el Explorador de métricas
Sigue estos pasos para acceder a las métricas:
En la Google Cloud consola de, ve a la página Explorador de métricas.
Selecciona el Google Cloud proyecto en el que se creó tu app de Gemini Enterprise.
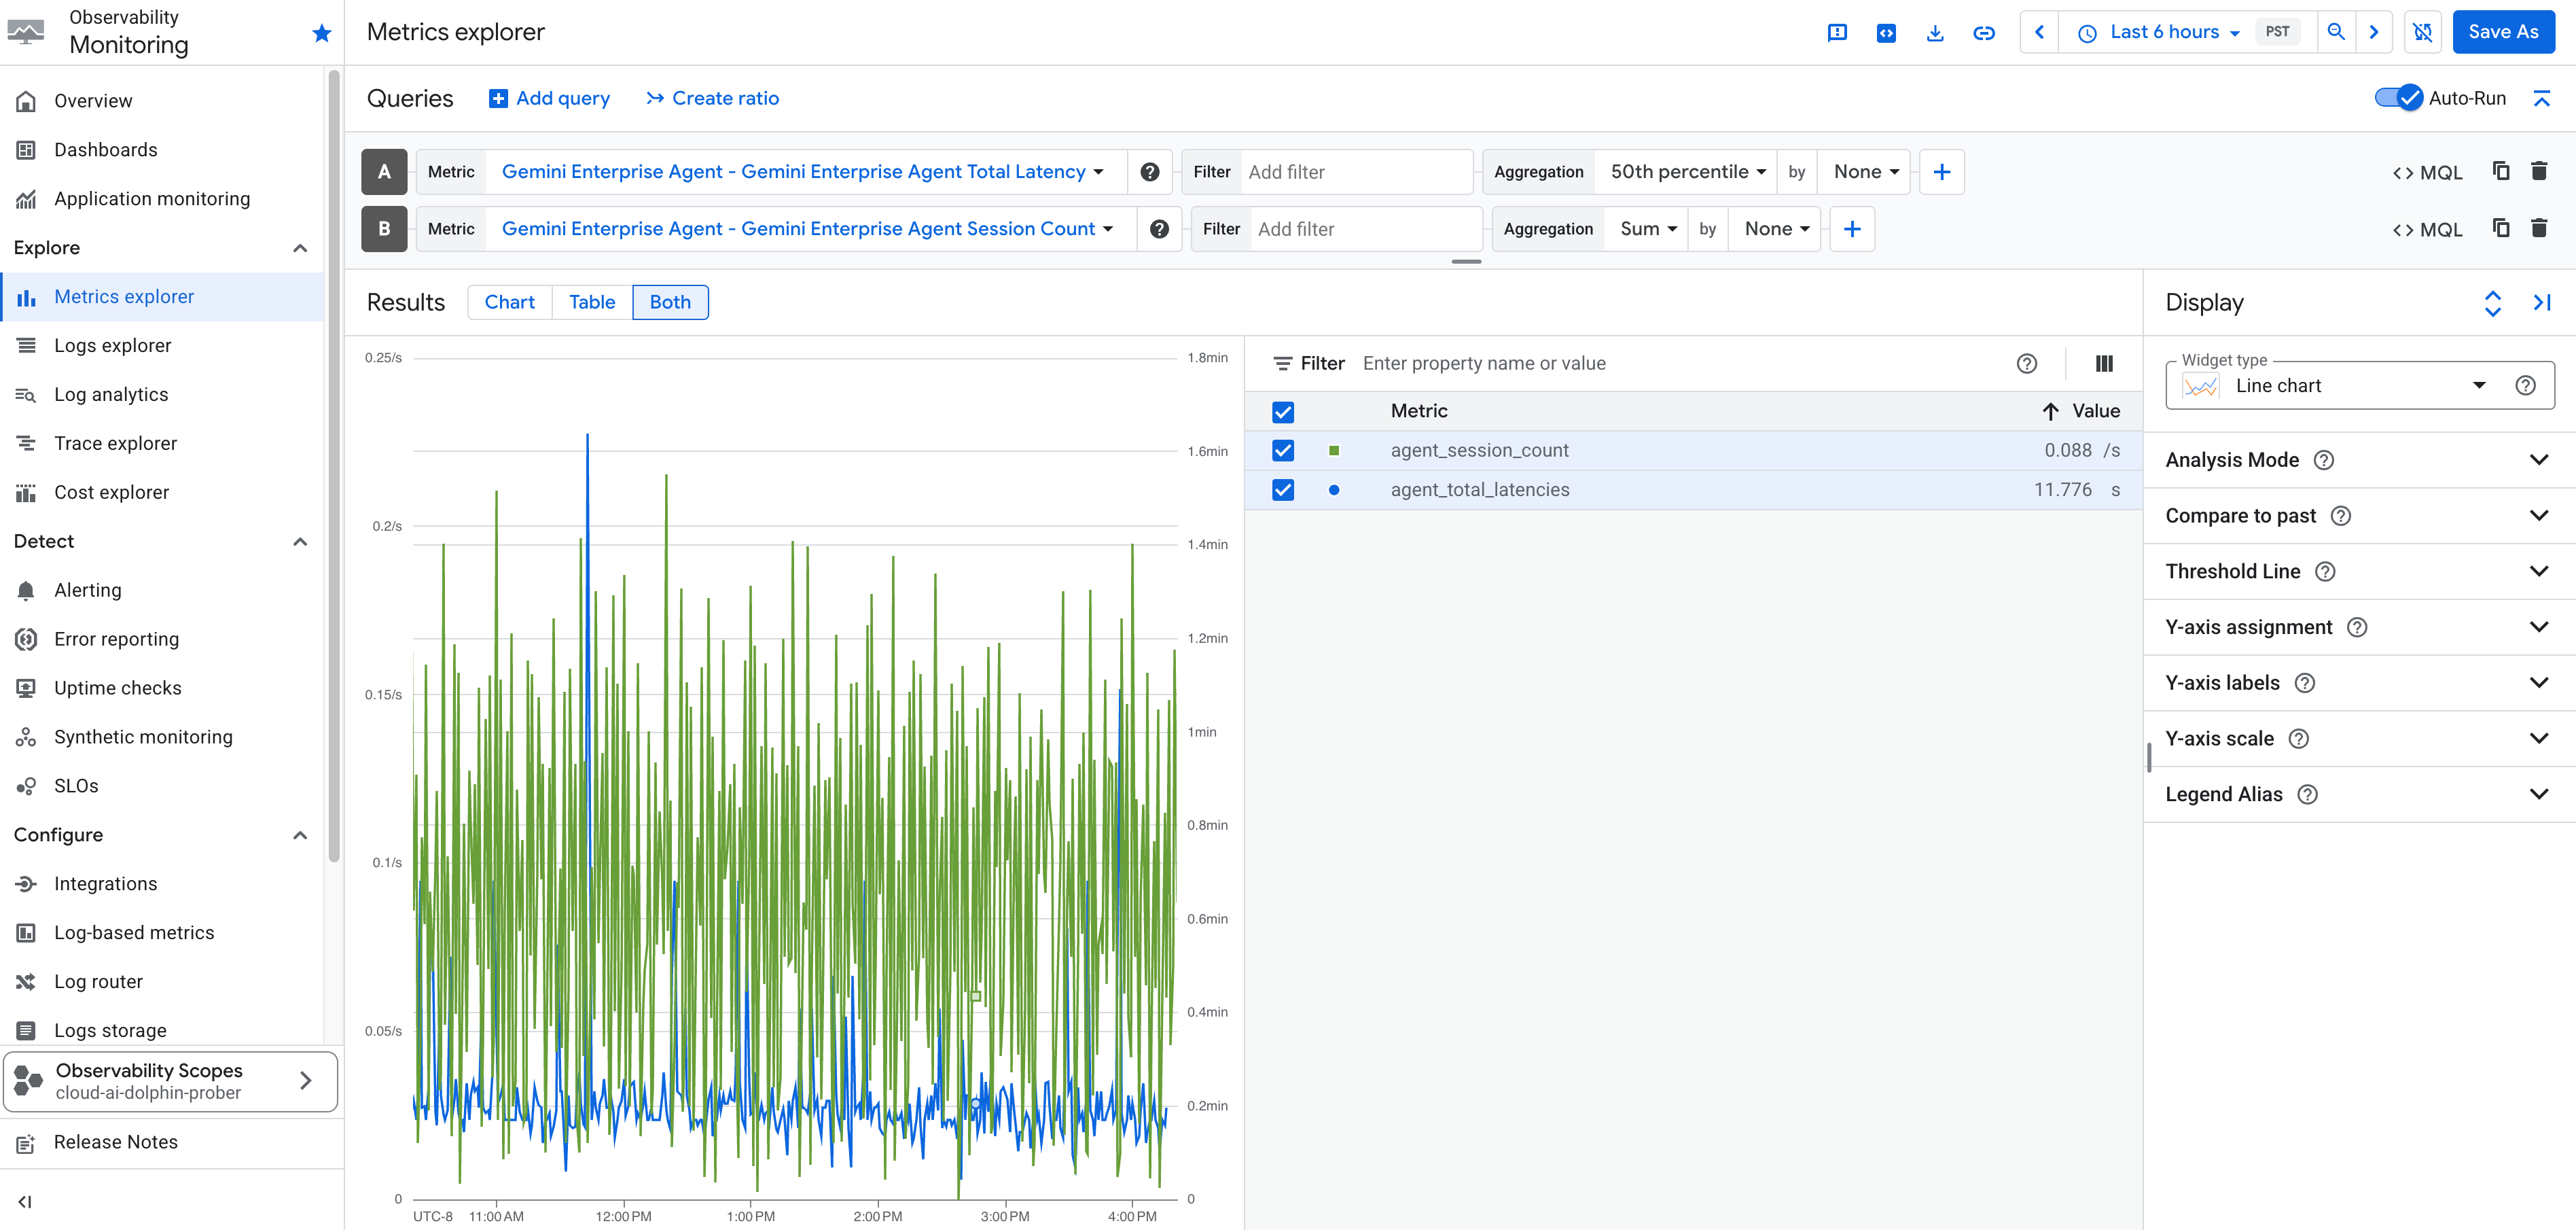
Haz clic en Seleccionar una métrica para abrir una barra de búsqueda.
En la barra de búsqueda, busca las siguientes métricas:
Nombre de la métrica Descripción Agente de Gemini Enterprise - Recuento de sesiones del agente de Gemini Enterprise Es la cantidad de sesiones que controla el agente de Gemini Enterprise. Agente de Gemini Enterprise - Recuento de herramientas del agente de Gemini Enterprise Es la cantidad de veces que el agente de Gemini Enterprise invocó herramientas. Agente de Gemini Enterprise - Recuento de turnos del agente de Gemini Enterprise Es la cantidad de turnos de conversación dentro de las sesiones del agente de Gemini Enterprise. Agente de Gemini Enterprise - Total del agente de Gemini Enterprise Latencia Es la latencia total de las respuestas del agente de Gemini Enterprise. Agente de Gemini Enterprise - Total de herramientas del agente de Gemini Enterprise Latencia Es la latencia total que se produce por las ejecuciones de herramientas dentro del agente de Gemini Enterprise. Conector de datos de Gemini Enterprise - Conector de datos de Gemini Enterprise Recuento de solicitudes Es el recuento total de solicitudes realizadas a los conectores de datos de Gemini Enterprise (también denominados almacenes de datos en la Google Cloud consola). Conector de datos de Gemini Enterprise - Conector de datos de Gemini Enterprise Latencias de solicitudes (Beta) Es la latencia de las solicitudes realizadas a los conectores de datos de Gemini Enterprise (también denominados almacenes de datos en la Google Cloud consola) en milisegundos. Motor de Gemini Enterprise - Recuento de solicitudes del motor de Gemini Enterprise Es la cantidad total de solicitudes que recibió tu app de Gemini Enterprise, en todo el tráfico a la app en lugar de a un solo agente. Se desglosa por método de API, código de respuesta canónico de gRPC código de respuesta, clase de código de respuesta, tipo de consulta y modelo. Motor de Gemini Enterprise - Latencia total de solicitudes del motor de Gemini Enterprise Es la distribución de la latencia de solicitudes de extremo a extremo para tu app de Gemini Enterprise. Se registra para cada solicitud, incluidas las que muestran un error. Motor de Gemini Enterprise - Latencia de tiempo hasta la primera respuesta del motor de Gemini Enterprise Es la distribución de la latencia entre la recepción de una solicitud y la transmisión del primer token de respuesta. Se registra solo para las solicitudes que producen al menos un token de respuesta. Motor de Gemini Enterprise - Latencia de tiempo hasta el primer token del motor de Gemini Enterprise Es la distribución de la latencia entre la recepción de una solicitud y la transmisión del primer token, ya sea que ese token forme parte del proceso de pensamiento del modelo o de una respuesta final. Se registra solo para solicitudes que producen al menos un token transmitido. Selecciona la métrica que deseas explorar y haz clic en Aplicar.
De manera opcional, establece filtros de etiquetas adicionales, elementos de agregación y ajusta el período.
Accede a las métricas de los agentes
También puedes ver los paneles de métricas operativas, específicas de herramientas y de sesiones directamente para agentes individuales en la pestaña Observabilidad del agente en la Google Cloud consola.
Para acceder a las métricas de un agente, haz lo siguiente:
- En la Google Cloud consola de , navega a tu app y, luego, haz clic en Agentes.
- Selecciona el agente que deseas inspeccionar y, luego, haz clic en la pestaña Observabilidad.
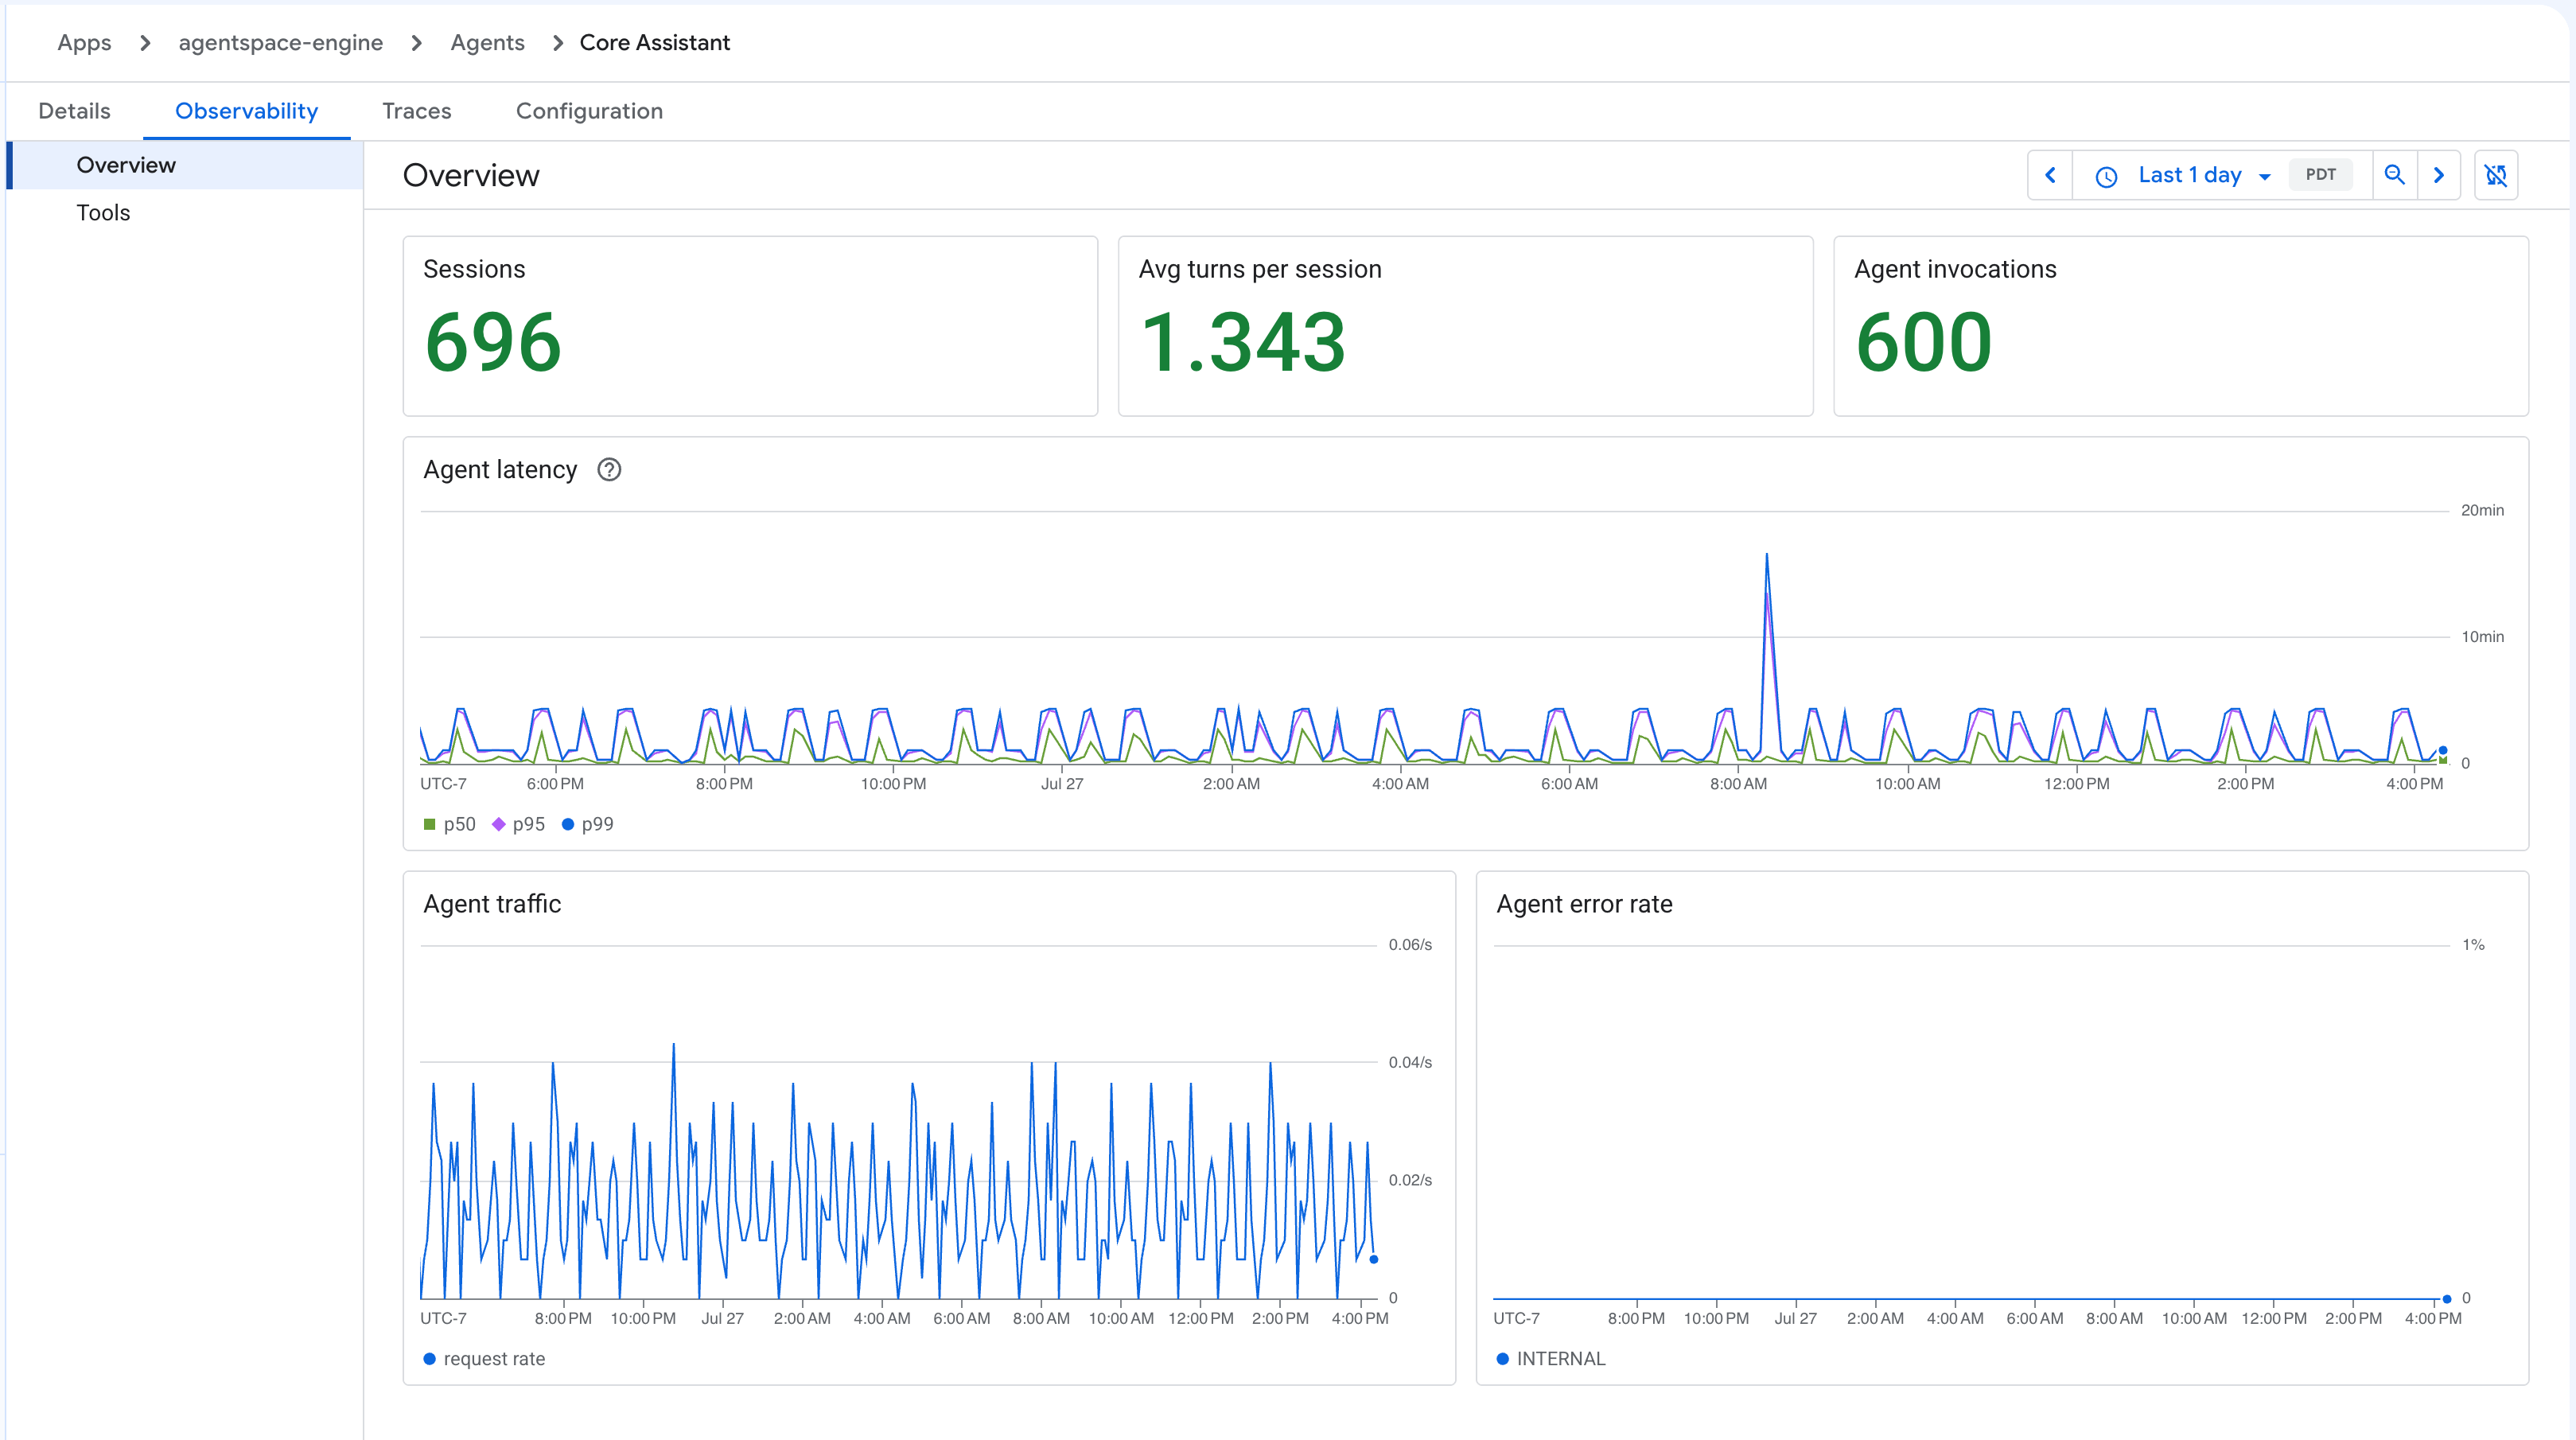
La pestaña Observabilidad proporciona telemetría operativa clave dividida en cuatro vistas: Descripción general, Herramientas, Latencia y Tasa de errores.
Métricas generales
Esta vista proporciona un panel que resume los datos estándar de estado de la sesión y del agente, que incluye lo siguiente:
- Sesiones: Es el recuento total de sesiones de usuario.
- Tiempo promedio por sesión: Es el tiempo promedio transcurrido durante una sesión.
- Invocaciones de agentes: Es la cantidad total de veces que se llamó al agente.
- Latencia del agente: Es la latencia en el tiempo y las métricas específicas.
- Tráfico del agente: Es el volumen de solicitudes entrantes.
- Tasa de errores del agente: Es el porcentaje de invocaciones de agentes fallidas.
Métricas de herramientas
Esta vista se centra específicamente en el uso y la latencia de las herramientas conectadas a tu agente, que incluye lo siguiente:
- Total de llamadas: Es la cantidad de solicitudes de ejecución de herramientas.
- Duración de P95 por herramienta: Es la latencia del percentil 95 de las ejecuciones, categorizada por herramienta.
- Recuento de llamadas por herramienta: Es el recuento total de llamadas dividido entre diferentes herramientas.
- Tasa de errores por herramienta: Es la tasa de fallas de las ejecuciones por herramienta.
- Tasa de"No se llamó a ninguna herramienta": Es la tasa a la que las interacciones no activaron ninguna ejecución de herramientas.
Métricas de latencia
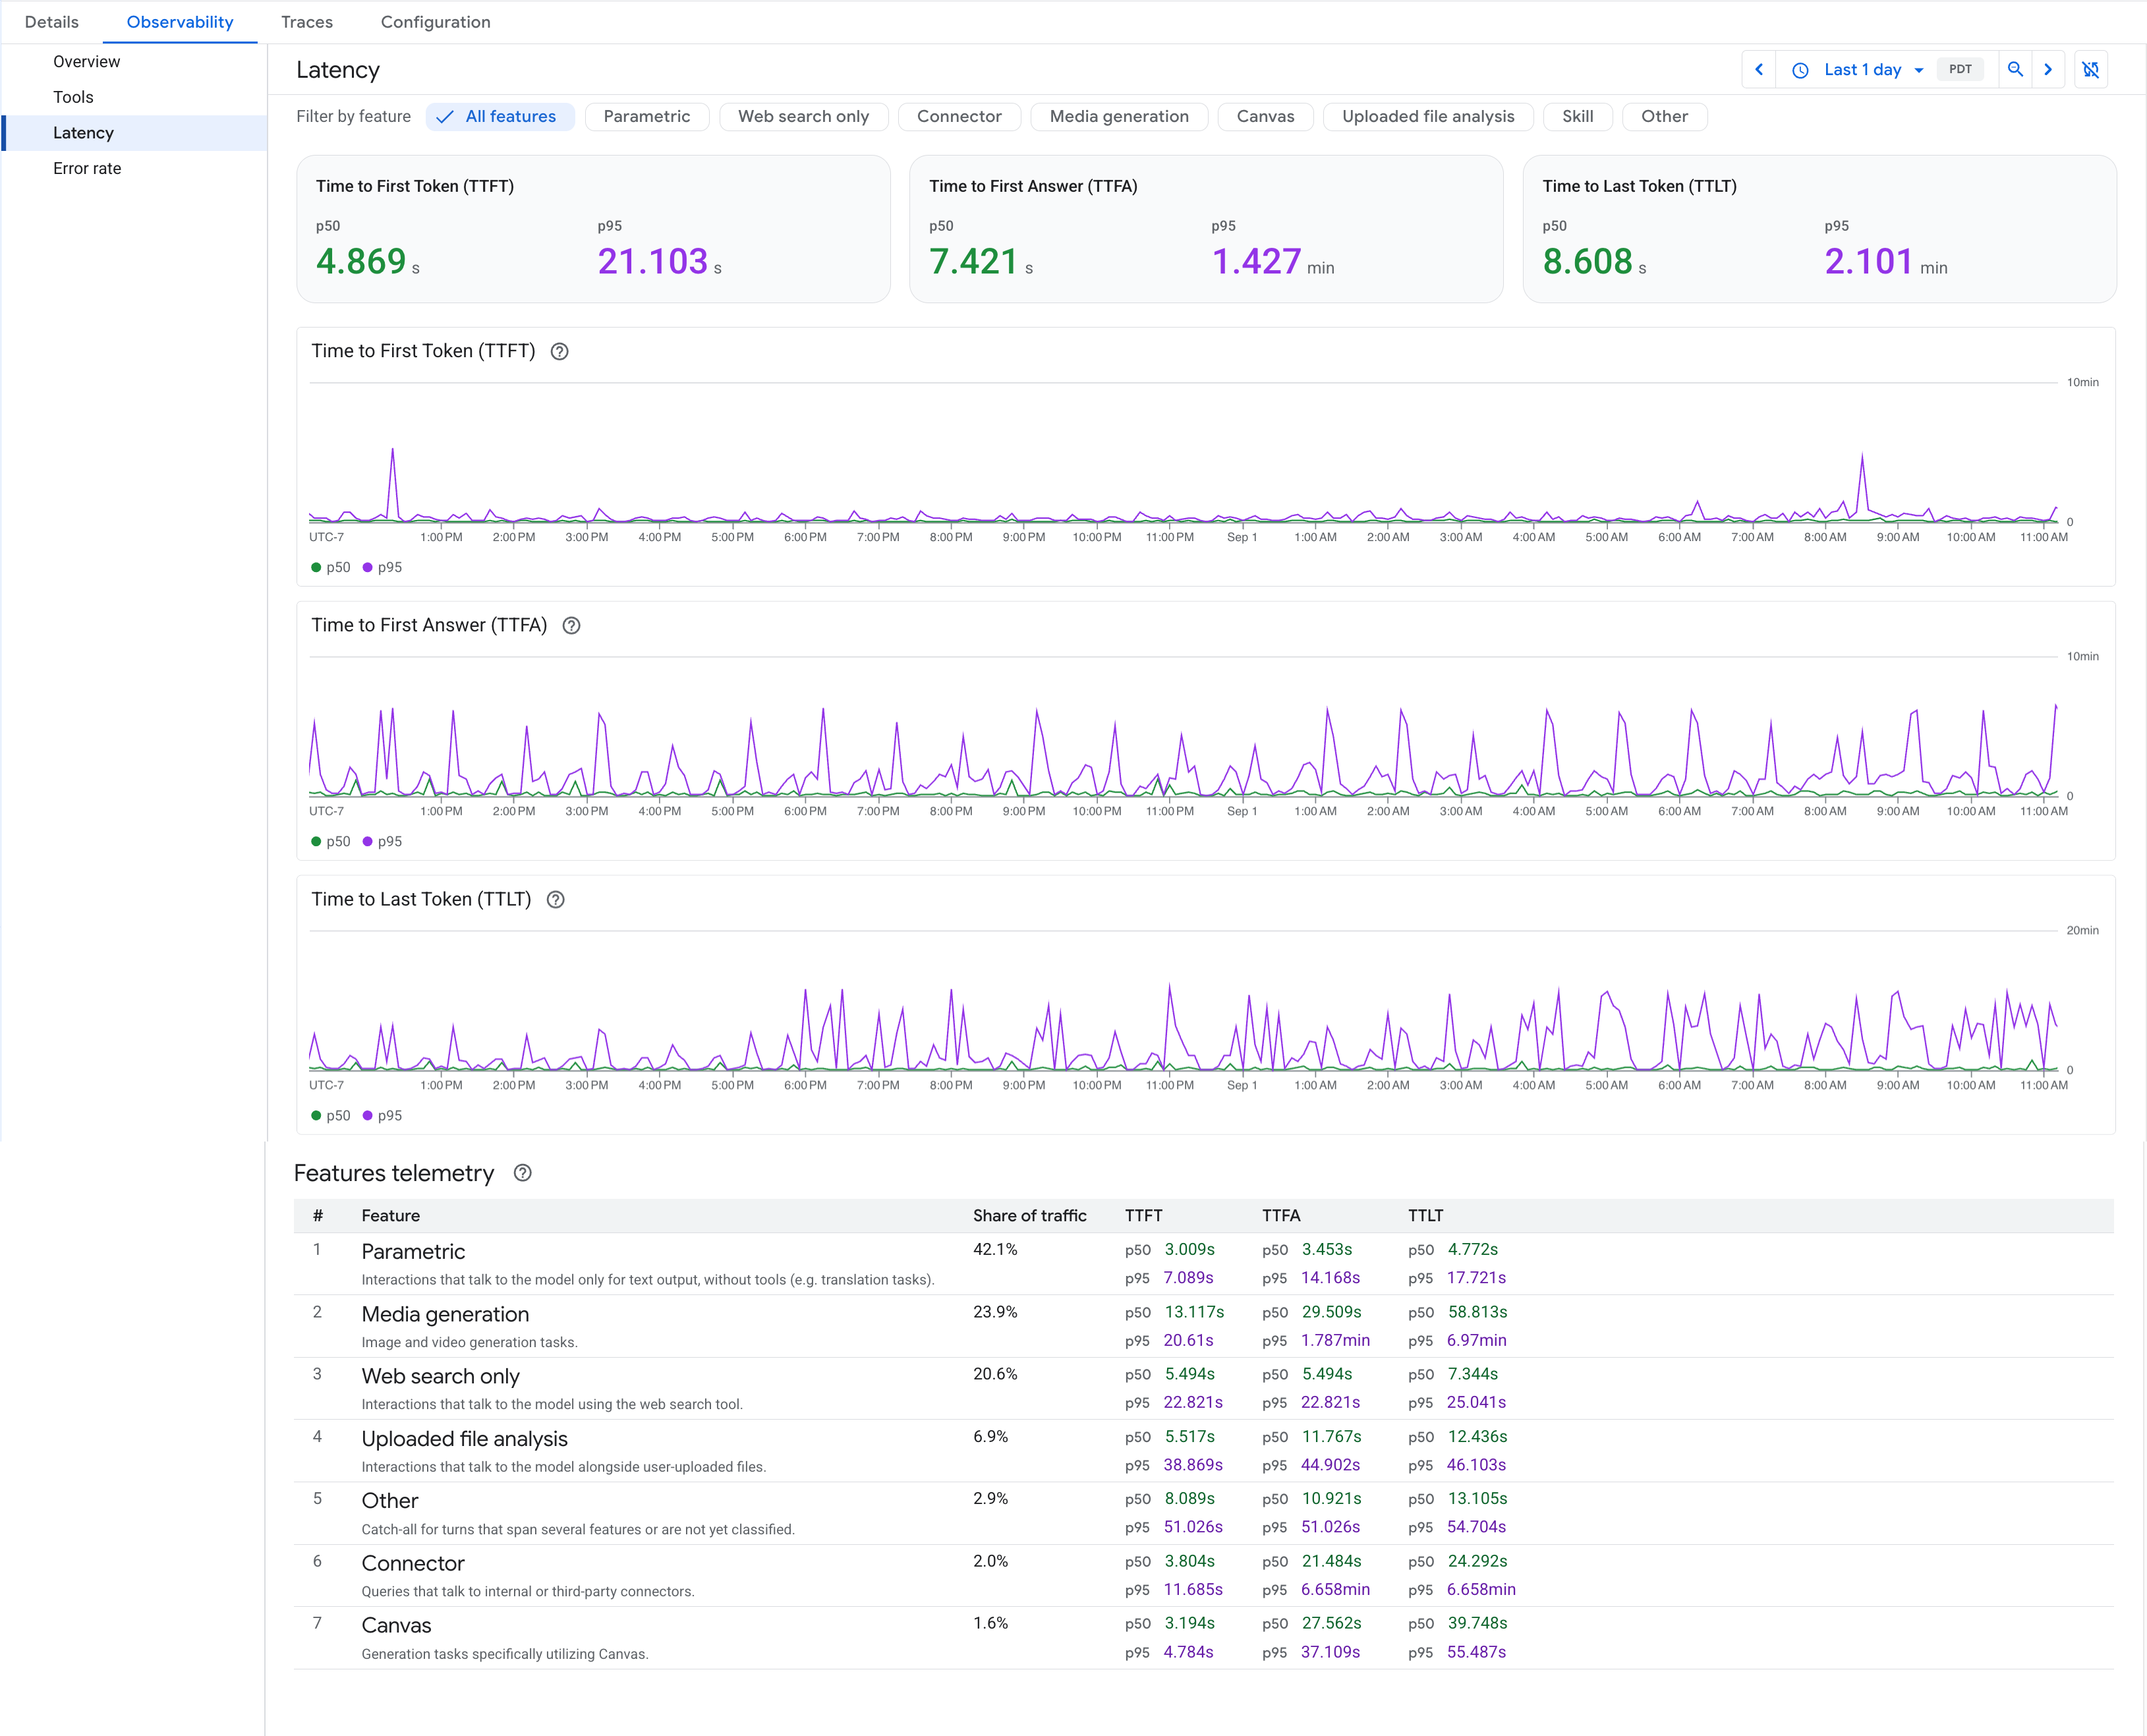
En esta vista, se muestra la latencia de respuesta de tu agente. Cada métrica se muestra como una tarjeta de resumen de p50 y p95 para el período seleccionado, y como un gráfico de series temporales que muestra las tendencias a lo largo del tiempo. También puedes filtrar las métricas de latencia por función. En la vista, se muestran las siguientes métricas:
- Tiempo hasta el primer token (TTFT): Es la latencia entre la recepción de una solicitud y la transmisión del primer token, ya sea que ese token forme parte del proceso de pensamiento del modelo o de la respuesta.
- Tiempo hasta la primera respuesta (TTFA): Es la latencia entre la recepción de una solicitud y la transmisión del primer token de respuesta, que es el primer token que no forma parte del pensamiento del modelo. Si el agente llama a una herramienta después de que comienza a responder, la medición se reinicia, por lo que TTFA refleja cuándo comenzó a transmitirse la respuesta que lee el usuario, no ninguna narración provisional.
- Tiempo hasta el último token (TTLT): Es la latencia entre la recepción de una solicitud y la transmisión del último token, que es cuando se completa la respuesta.
Filtra las métricas de latencia por función
Una función es el tipo de interacción que representa un turno, como una búsqueda web o una generación de imágenes. Filtra las métricas de latencia por función para ver qué tipos de interacción son más lentos y evitar que una función lenta sesgue la latencia general.
Para filtrar las métricas de latencia por función, haz lo siguiente:
- En la pestaña Observabilidad del agente, haz clic en la vista Latencia.
- Haz clic en Filtrar por función.
- Selecciona la función que deseas inspeccionar.
Las tarjetas de resumen y los gráficos de series temporales solo muestran los turnos de esa función.
Para comparar todas las funciones a la vez, usa la tabla Telemetría de funciones , que enumera lo siguiente para cada función:
- Porcentaje de tráfico: Es el porcentaje de turnos atribuidos a la función.
- TTFT, TTFA y TTLT: Es la latencia de p50 y p95 para la función.
Puedes filtrar con las siguientes funciones:
- Paramétrico: Interacciones que envían solicitudes al modelo solo para la salida de texto, sin herramientas, como tareas de traducción.
- Generación de contenido multimedia: Tareas de generación de imágenes y videos.
- Solo búsqueda web: Interacciones que envían solicitudes al modelo con la herramienta de búsqueda web.
- Análisis de archivos subidos: Interacciones que envían solicitudes al modelo junto con los archivos que subió el usuario.
- Conector: Consultas que envían solicitudes a conectores internos o externos.
- Canvas: Tareas de generación que usan Canvas.
- Habilidad: Interacciones que invocan una habilidad.
- Otros: Una categoría general para turnos que abarcan varias funciones o que aún no se clasificaron.
Métricas de tasa de errores
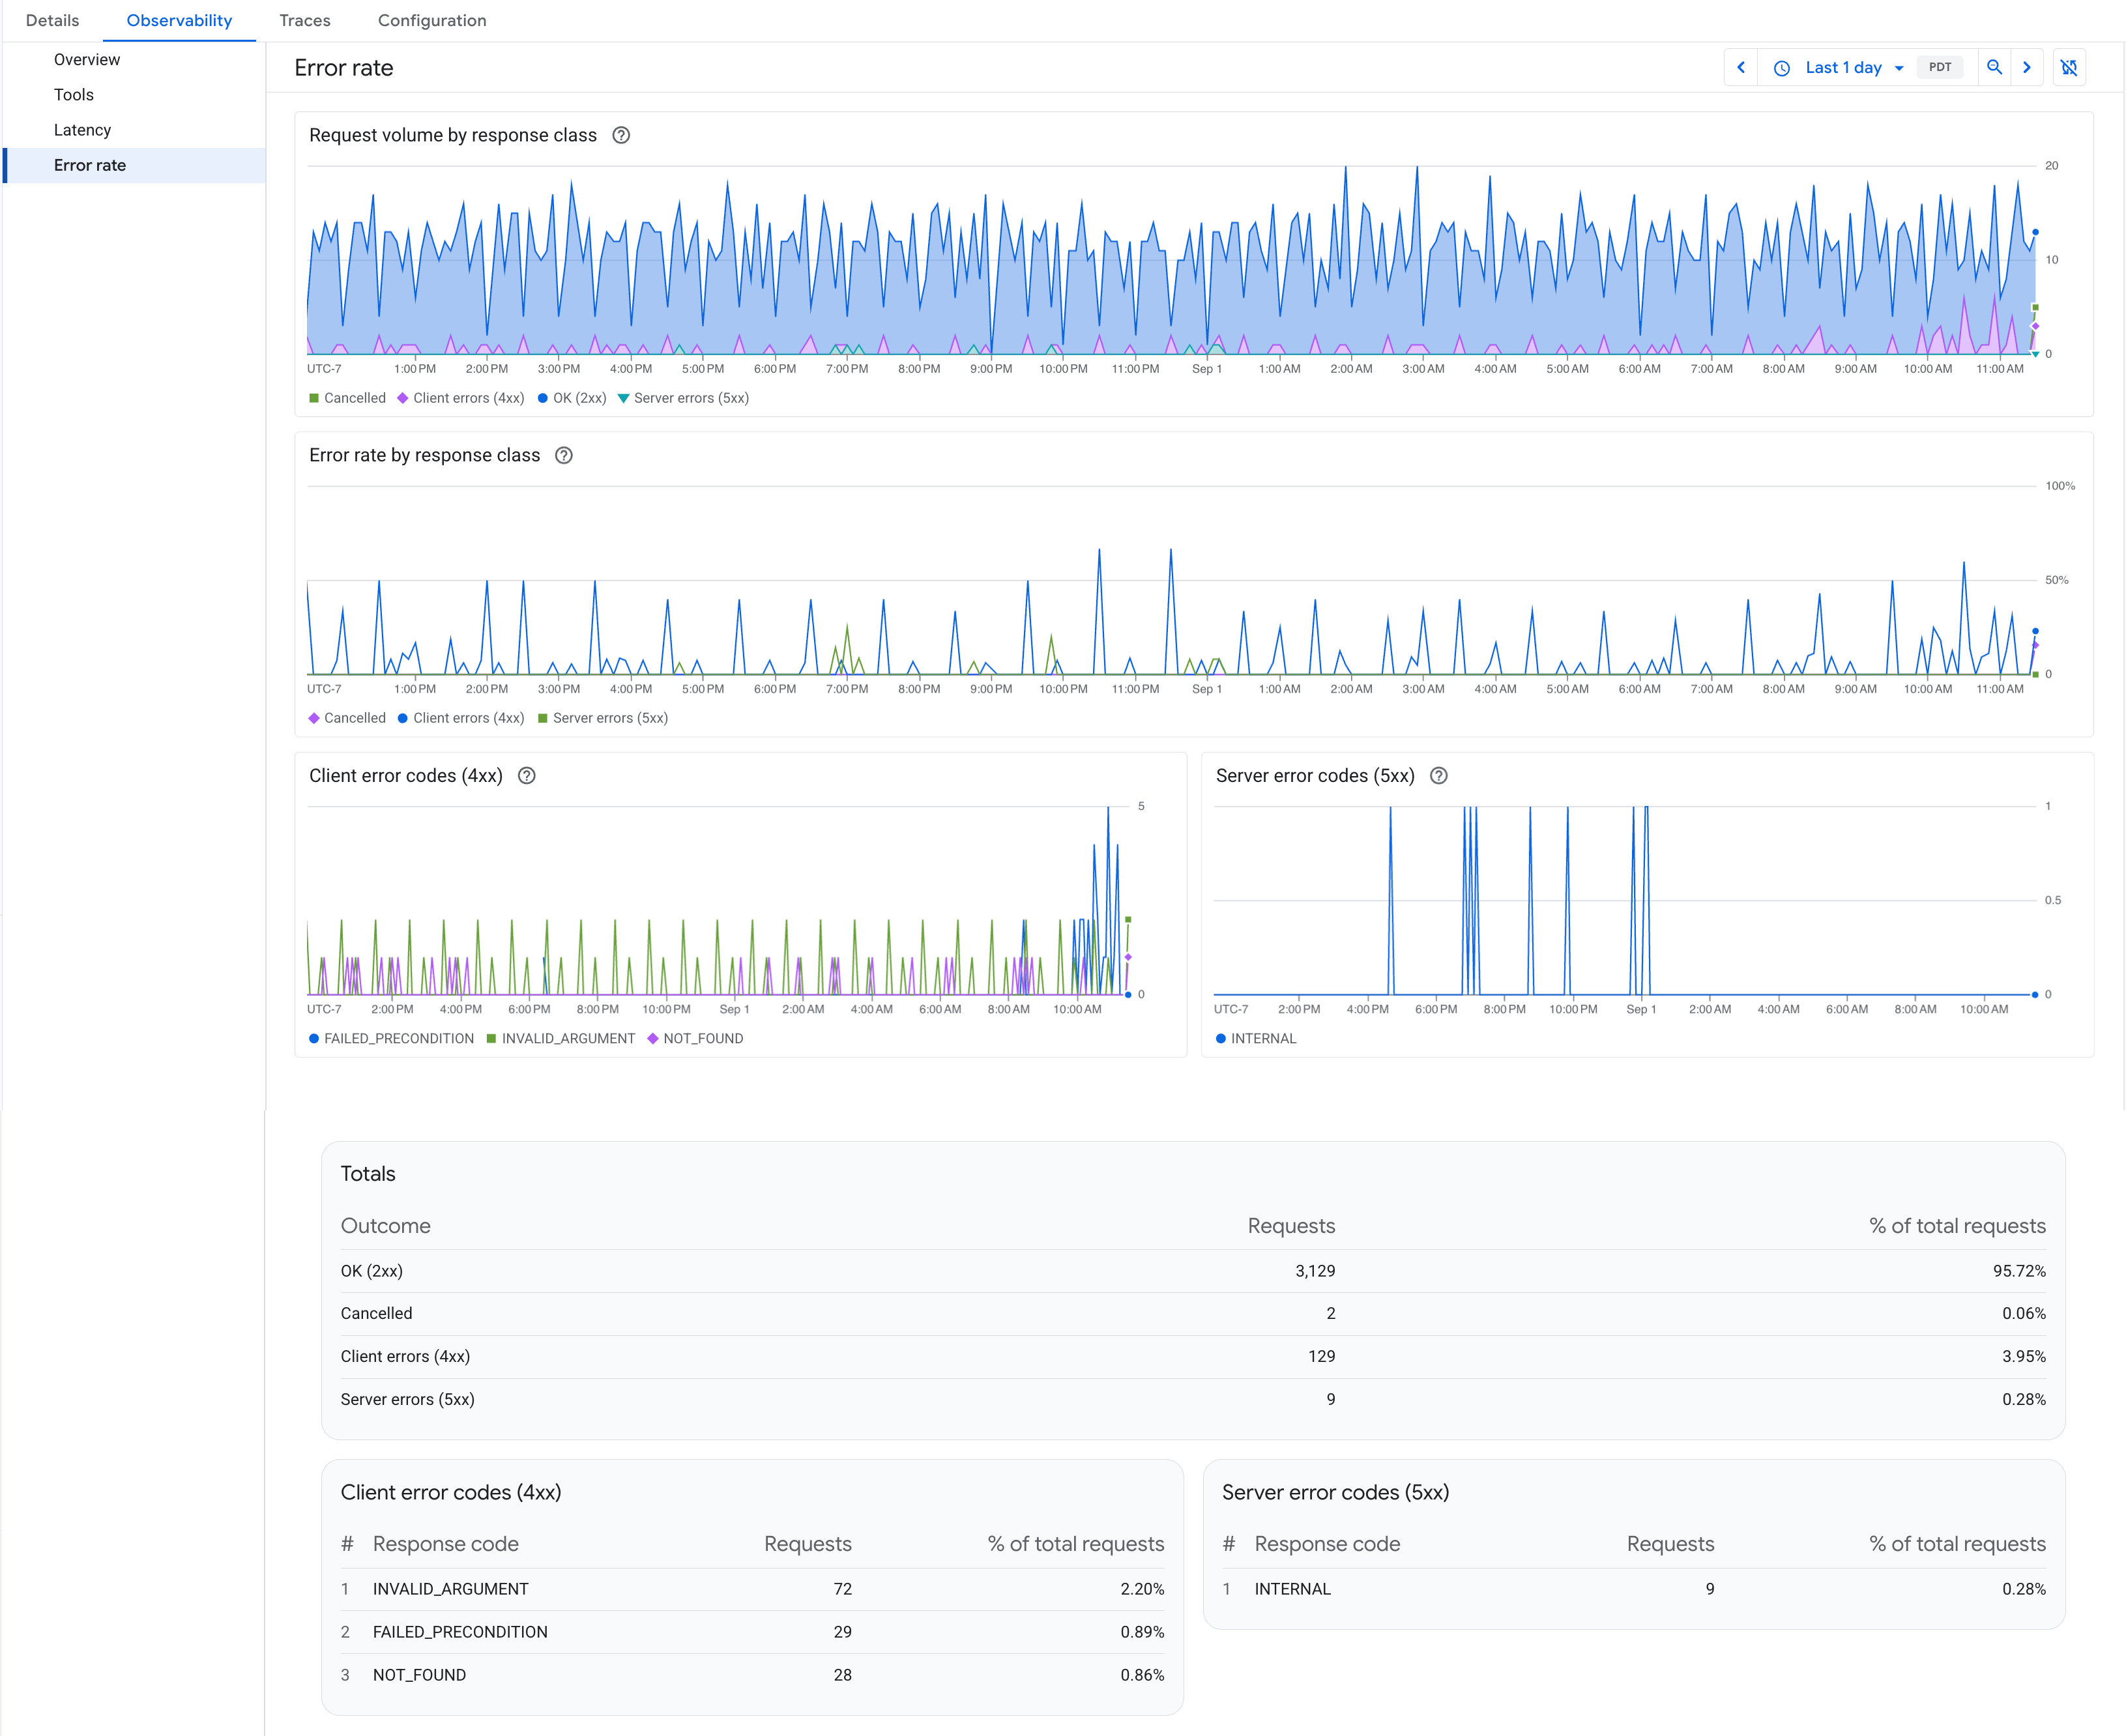
En esta vista, se muestra cómo se resuelven las solicitudes de tu agente, agrupadas por clase de respuesta: OK (2xx), Errores del cliente (4xx), Errores del servidor (5xx) y Cancelado. Incluye lo siguiente:
- Volumen de solicitudes por clase de respuesta: Es el recuento de solicitudes entrantes a lo largo del tiempo, apilado por clase de respuesta.
- Tasa de errores por clase de respuesta: Es el porcentaje de solicitudes que fallaron a lo largo del tiempo, dividido por clase de respuesta.
- Códigos de error del cliente (4xx) y Códigos de error del servidor (5xx): Son los
códigos de respuesta canónicos de gRPC individuales a lo largo del tiempo, como
INVALID_ARGUMENToINTERNAL, para que puedas saber qué errores específicos generan un aumento. - Totales: Es la cantidad de solicitudes y el porcentaje de solicitudes totales para cada resultado durante el período seleccionado, con tablas separadas que clasifican los códigos de error individuales del cliente y del servidor.
¿Qué sigue?
- Crea paneles con las métricas de Gemini Enterprise. Para obtener más información, consulta Crea y administra paneles personalizados.
- Crea alertas cuando las métricas superen un umbral. Para obtener más información, consulta Crea políticas de alertas de umbral de métrica.
- Para desactivar el seguimiento del Explorador de métricas, consulta Desactiva la configuración de observabilidad.