


Tutorial ini memandu Anda dalam men-deploy model Meta-Llama-3.1-8B di Gemini Enterprise Agent Platform. Anda akan mempelajari cara men-deploy endpoint dan mengoptimalkan untuk kebutuhan spesifik Anda. Jika memiliki workload yang fault-tolerant, Anda dapat mengoptimalkan biaya dengan menggunakan Spot VM. Jika ingin memastikan ketersediaan, gunakan pemesanan Compute Engine. Anda akan mempelajari cara men-deploy endpoint yang menggunakan:
- Spot VM: Gunakan instance yang disediakan spot untuk penghematan biaya yang signifikan.
- Pemesanan: Menjamin ketersediaan resource untuk performa yang dapat diprediksi, terutama untuk workload produksi. Tutorial ini menunjukkan penggunaan pemesanan otomatis (
ANY_RESERVATION) dan pemesanan tertentu (SPECIFIC_RESERVATION).
Untuk mengetahui informasi selengkapnya, lihat Spot VM atau Pemesanan resource Compute Engine.
Prasyarat
Sebelum memulai, selesaikan prasyarat berikut:
- Project dengan penagihan diaktifkan. Google Cloud
- Gemini Enterprise Agent Platform dan Compute Engine API diaktifkan.
- Kuota yang cukup untuk jenis mesin dan akselerator yang ingin Anda gunakan, seperti GPU NVIDIA L4. Untuk memeriksa kuota Anda, lihat Kuota dan batas sistem di Google Cloud konsol.
- Akun Hugging Face dan Token Akses Pengguna dengan akses baca.
- Jika Anda menggunakan pemesanan bersama, berikan izin IAM antar-project. Semua izin tersebut tercakup dalam notebook.
Men-deploy di Spot VM
Bagian berikut akan memandu Anda dalam proses menyiapkan project Google Cloud , mengonfigurasi autentikasi Hugging Face, men-deploy model Llama-3.1 menggunakan Spot VM atau pemesanan, dan menguji deployment.
1. Menyiapkan Google Cloud project dan pemesanan bersama
Buka notebook Colab Enterprise.
Di bagian pertama, tetapkan variabel PROJECT_ID, SHARED_PROJECT_ID (jika berlaku), BUCKET_URI, dan REGION di notebook Colab.
Notebook memberikan peran compute.viewer ke akun layanan kedua project.
Jika Anda ingin menggunakan pemesanan yang dibuat di project lain dalam organisasi yang sama, pastikan untuk memberikan peran compute.viewer ke P4SA (Principal Service Account) dari kedua project. Kode notebook akan mengotomatiskan hal ini, tetapi pastikan SHARED_PROJECT_ID ditetapkan dengan benar. Izin lintas project ini memungkinkan endpoint Gemini Enterprise Agent Platform di project utama Anda untuk melihat dan menggunakan kapasitas pemesanan di project bersama.
2. Menyiapkan autentikasi Hugging Face
Untuk mendownload model Llama-3.1, Anda harus memberikan Token Akses Pengguna Hugging Face di variabel HF_TOKEN dalam notebook Colab. Jika Anda tidak memberikannya, Anda akan mendapatkan error berikut: Cannot access gated repository for URL.
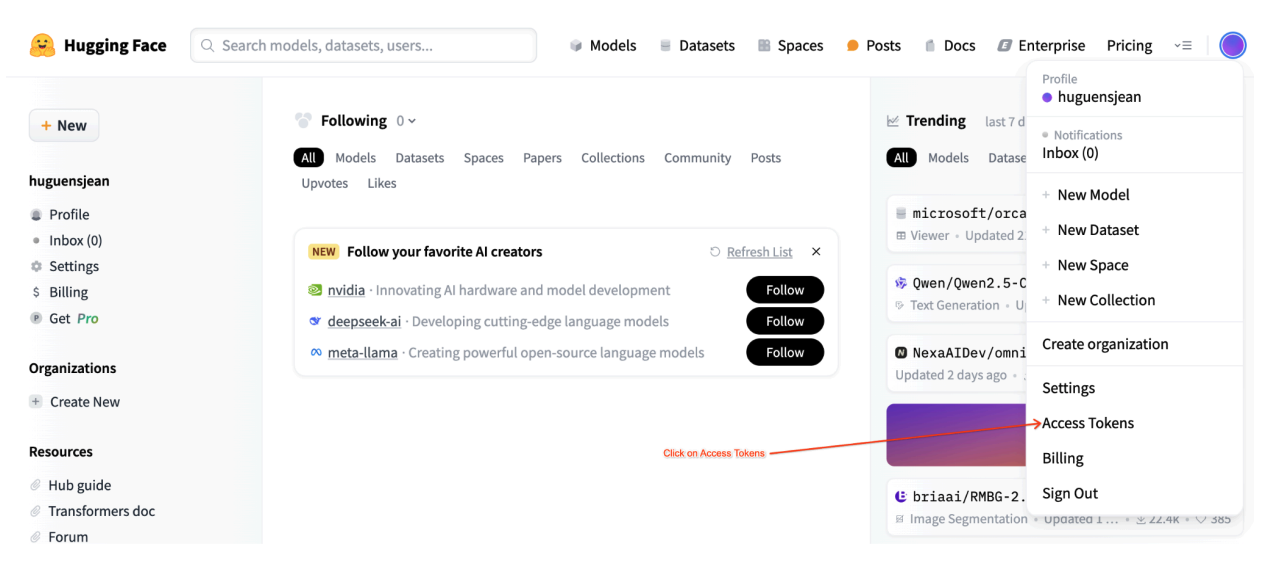 Gambar 1: Setelan Token Akses Hugging Face
3. Men-deploy dengan Spot VM
Untuk men-deploy model Llama ke Spot VM, buka bagian "Spot VM Gemini Enterprise Agent Platform Endpoint Deployment" di notebook Colab dan tetapkan is_spot=True.
base_model_name = "Meta-Llama-3.1-8B"
hf_model_id = "meta-llama/" + base_model_name

if "8b" in base_model_name.lower():
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-12"
    accelerator_count = 1
    max_loras = 5
else:
    raise ValueError(
        f"Recommended GPU setting not found for: {accelerator_type} and {base_model_name}."
    )

common_util.check_quota(
    project_id=PROJECT_ID,
    region=REGION,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    is_for_training=False,
)

gpu_memory_utilization = 0.95
max_model_len = 8192

models["vllm_gpu_spotvm"], endpoints["vllm_gpu_spotvm"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(prefix="llama3_1-serve-spotvm"),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=machine_type,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    gpu_memory_utilization=gpu_memory_utilization,
    max_model_len=max_model_len,
    max_loras=max_loras,
    enforce_eager=True,
    enable_lora=True,
    use_dedicated_endpoint=False,
    model_type="llama3.1",
    is_spot=True,
)
Men-deploy pada instance pemesanan bersama
Bagian berikut akan memandu Anda dalam proses membuat pemesanan bersama, mengonfigurasi setelan pemesanan, men-deploy model Llama-3.1 menggunakan ANY_RESERVATION atau SPECIFIC_RESERVATION, dan menguji deployment.
1. Membuat pemesanan bersama
Untuk mengonfigurasi pemesanan, buka bagian "Set Up Reservations for Gemini Enterprise Agent Platform Predictions" di notebook. Tetapkan variabel yang diperlukan untuk pemesanan seperti RES_ZONE, RESERVATION_NAME, RES_MACHINE_TYPE, RES_ACCELERATOR_TYPE, dan RES_ACCELERATOR_COUNT.
Anda harus menetapkan RES_ZONE menjadi {REGION}-{availability_zone}
RES_ZONE = "a"
RES_ZONE = f"{REGION}-{RES_ZONE}"

RESERVATION_NAME = "shared-reservation-1"
RESERVATION_NAME = f"{PROJECT_ID}-{RESERVATION_NAME}"
RES_MACHINE_TYPE = "g2-standard-12"
RES_ACCELERATOR_TYPE = "nvidia-l4"
RES_ACCELERATOR_COUNT = 1
rev_names.append(RESERVATION_NAME)

create_reservation(
    res_project_id=PROJECT_ID,
    res_zone=RES_ZONE,
    res_name=RESERVATION_NAME,
    res_machine_type=RES_MACHINE_TYPE,
    res_accelerator_type=RES_ACCELERATOR_TYPE,
    res_accelerator_count=RES_ACCELERATOR_COUNT,
    shared_project_id=SHARED_PROJECT_ID,
)
2. Membagikan pemesanan
Ada dua jenis pemesanan: pemesanan satu project (default) dan pemesanan bersama. Pemesanan satu project hanya dapat digunakan oleh VM dalam project yang sama dengan pemesanan itu sendiri. Sebaliknya, pemesanan bersama dapat digunakan oleh VM di project tempat pemesanan berada, serta oleh VM di project lain tempat pemesanan telah dibagikan. Memanfaatkan pemesanan bersama dapat meningkatkan pemanfaatan resource yang dipesan dan mengurangi jumlah keseluruhan pemesanan yang perlu Anda buat dan kelola. Tutorial ini berfokus pada pemesanan bersama. Untuk mengetahui informasi selengkapnya, lihat Cara kerja pemesanan bersama.
Sebelum melanjutkan, pastikan untuk "Share with other Google Services" dari Google Cloud konsol seperti yang ditunjukkan pada gambar:
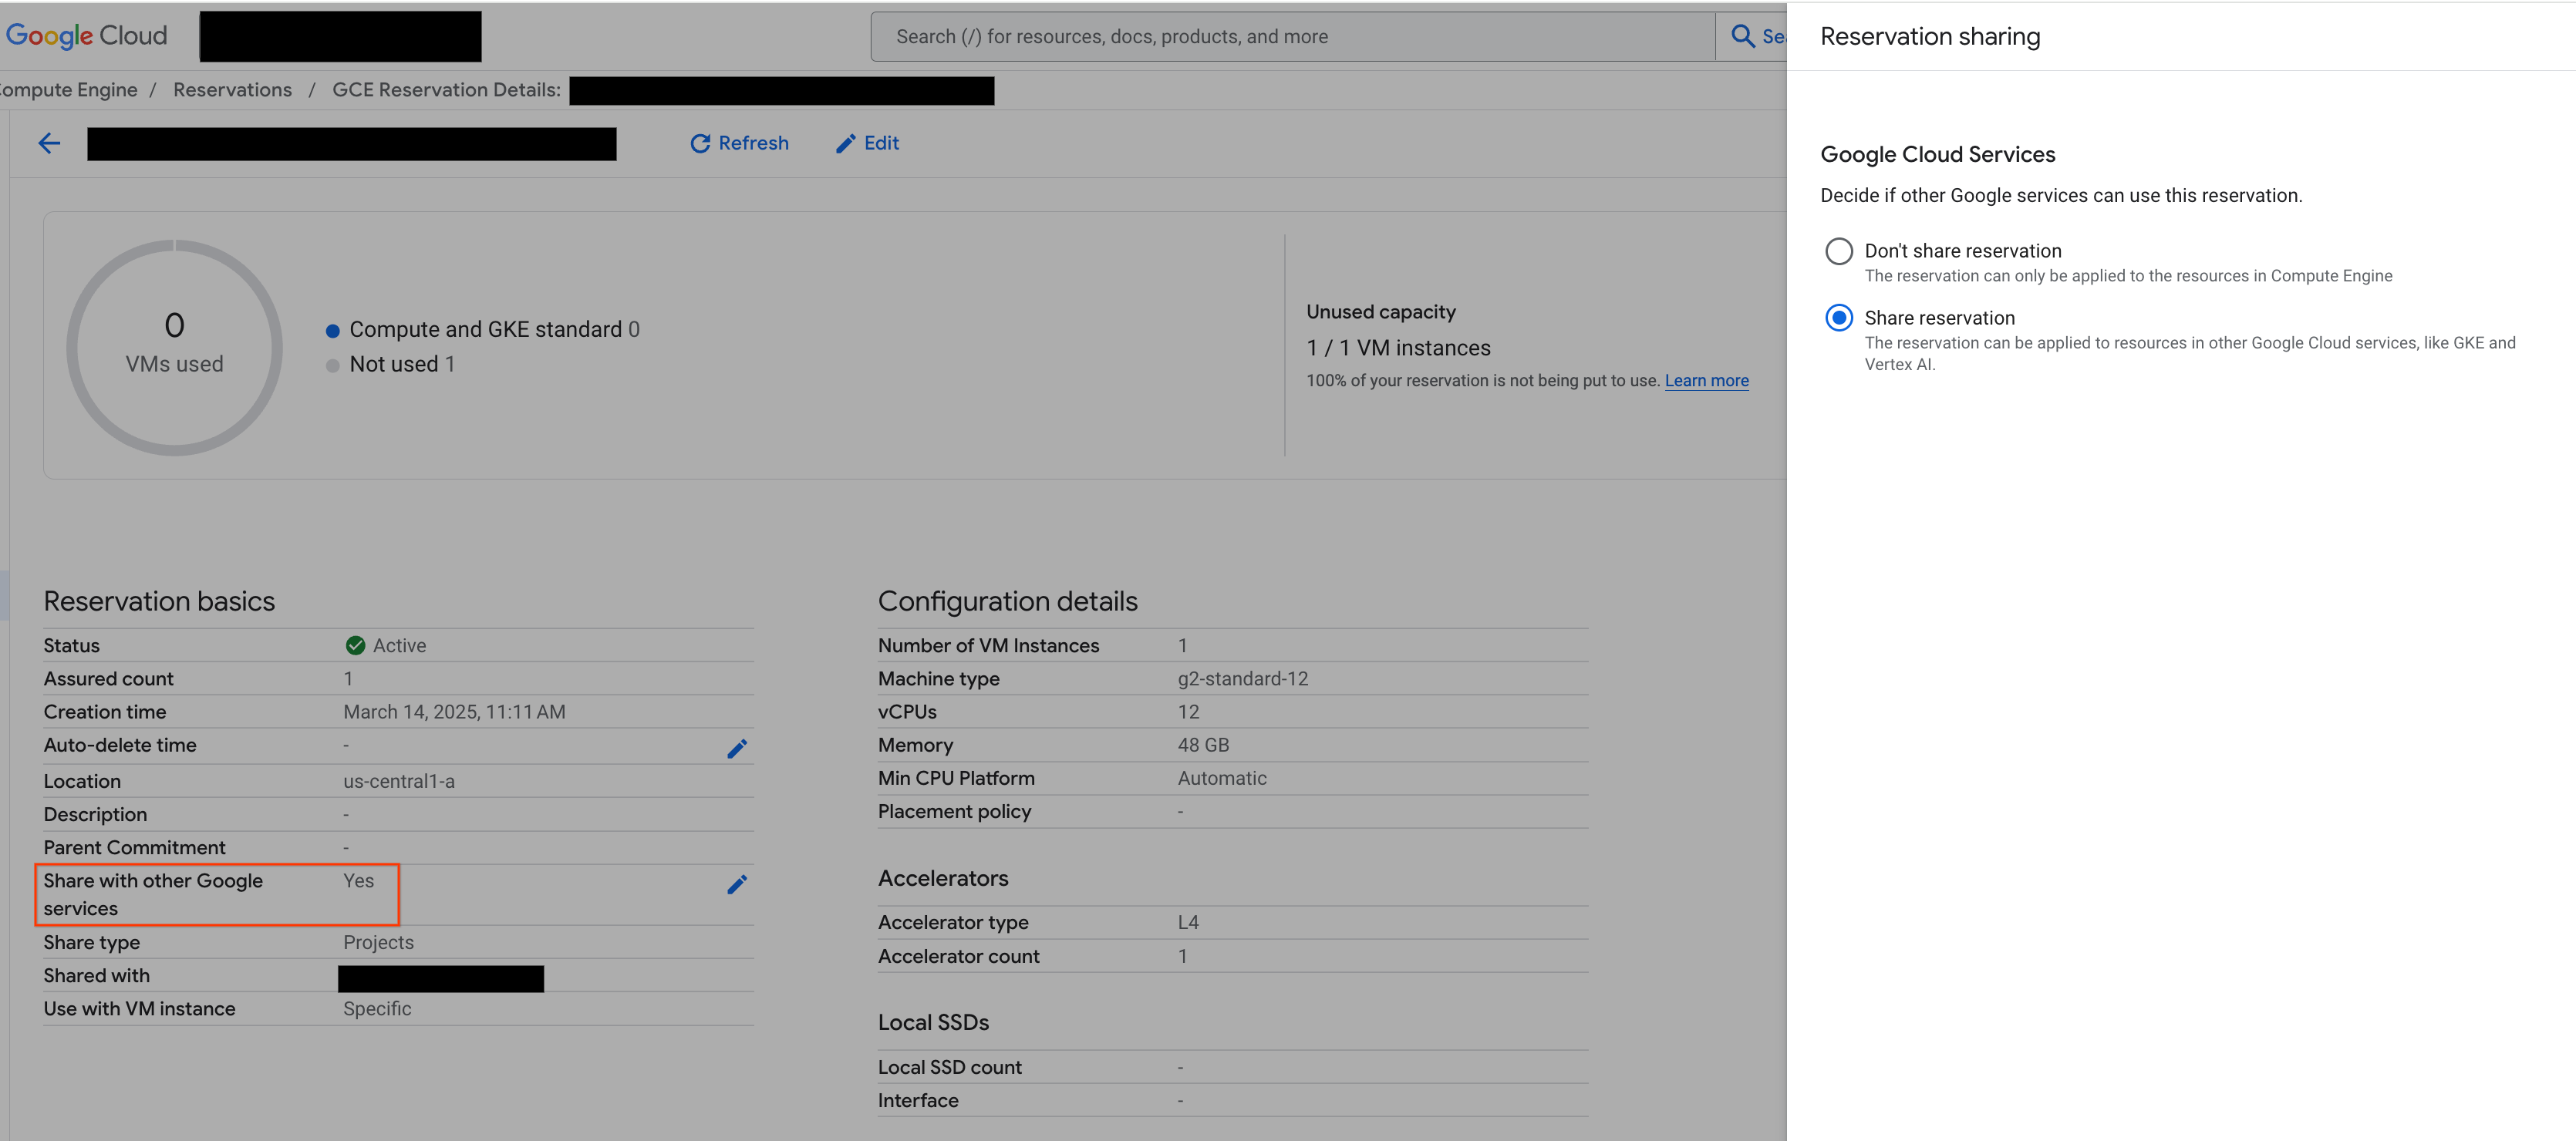 Gambar 2: Membagikan pemesanan dengan layanan Google lainnya
3. Men-deploy dengan ANY_RESERVATION
Untuk men-deploy endpoint menggunakan ANY_RESERVATION, buka bagian "Deploy Llama-3.1 Endpoint with ANY_RESERVATION" di notebook. Tentukan setelan deployment Anda, lalu tetapkan reservation_affinity_type="ANY_RESERVATION". Kemudian, jalankan sel untuk men-deploy endpoint.
hf_model_id = "meta-llama/Meta-Llama-3.1-8B"

models["vllm_gpu_any_reserve"], endpoints["vllm_gpu_any_reserve"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(
        prefix=f"llama3_1-serve-any-{RESERVATION_NAME}"
    ),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=MACHINE_TYPE,
    accelerator_type=ACCELERATOR_TYPE,
    accelerator_count=ACCELERATOR_COUNT,
    model_type="llama3.1",
    reservation_affinity_type="ANY_RESERVATION",
)
4. Menguji endpoint ANY_RESERVATION
Setelah endpoint di-deploy, pastikan untuk menguji beberapa perintah untuk memastikan endpoint di-deploy dengan benar.
5. Men-deploy dengan SPECIFIC_RESERVATION
Untuk men-deploy endpoint menggunakan SPECIFIC_RESERVATION, buka bagian "Deploy Llama-3.1 Endpoint with SPECIFIC_RESERVATION" di notebook. Tentukan parameter berikut: reservation_name, reservation_affinity_type="SPECIFIC_RESERVATION", reservation_project, dan reservation_zone. Kemudian, jalankan sel untuk men-deploy endpoint.
hf_model_id = "meta-llama/Meta-Llama-3.1-8B"

MACHINE_TYPE = "g2-standard-12"
ACCELERATOR_TYPE = "NVIDIA_L4"
ACCELERATOR_COUNT = 1

(
    models["vllm_gpu_specific_reserve"],
    endpoints["vllm_gpu_specific_reserve"],
) = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(
        prefix=f"llama3_1-serve-specific-{RESERVATION_NAME}"
    ),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=MACHINE_TYPE,
    accelerator_type=ACCELERATOR_TYPE,
    accelerator_count=ACCELERATOR_COUNT,
    model_type="llama3.1",
    reservation_name=RESERVATION_NAME,
    reservation_affinity_type="SPECIFIC_RESERVATION",
    reservation_project=PROJECT_ID,
    reservation_zone=RES_ZONE,
)
6. Menguji endpoint SPECIFIC_RESERVATION
Setelah endpoint di-deploy, verifikasi bahwa pemesanan digunakan oleh prediksi online Gemini Enterprise Agent Platform, dan pastikan untuk menguji beberapa perintah untuk memastikan endpoint di-deploy dengan benar.
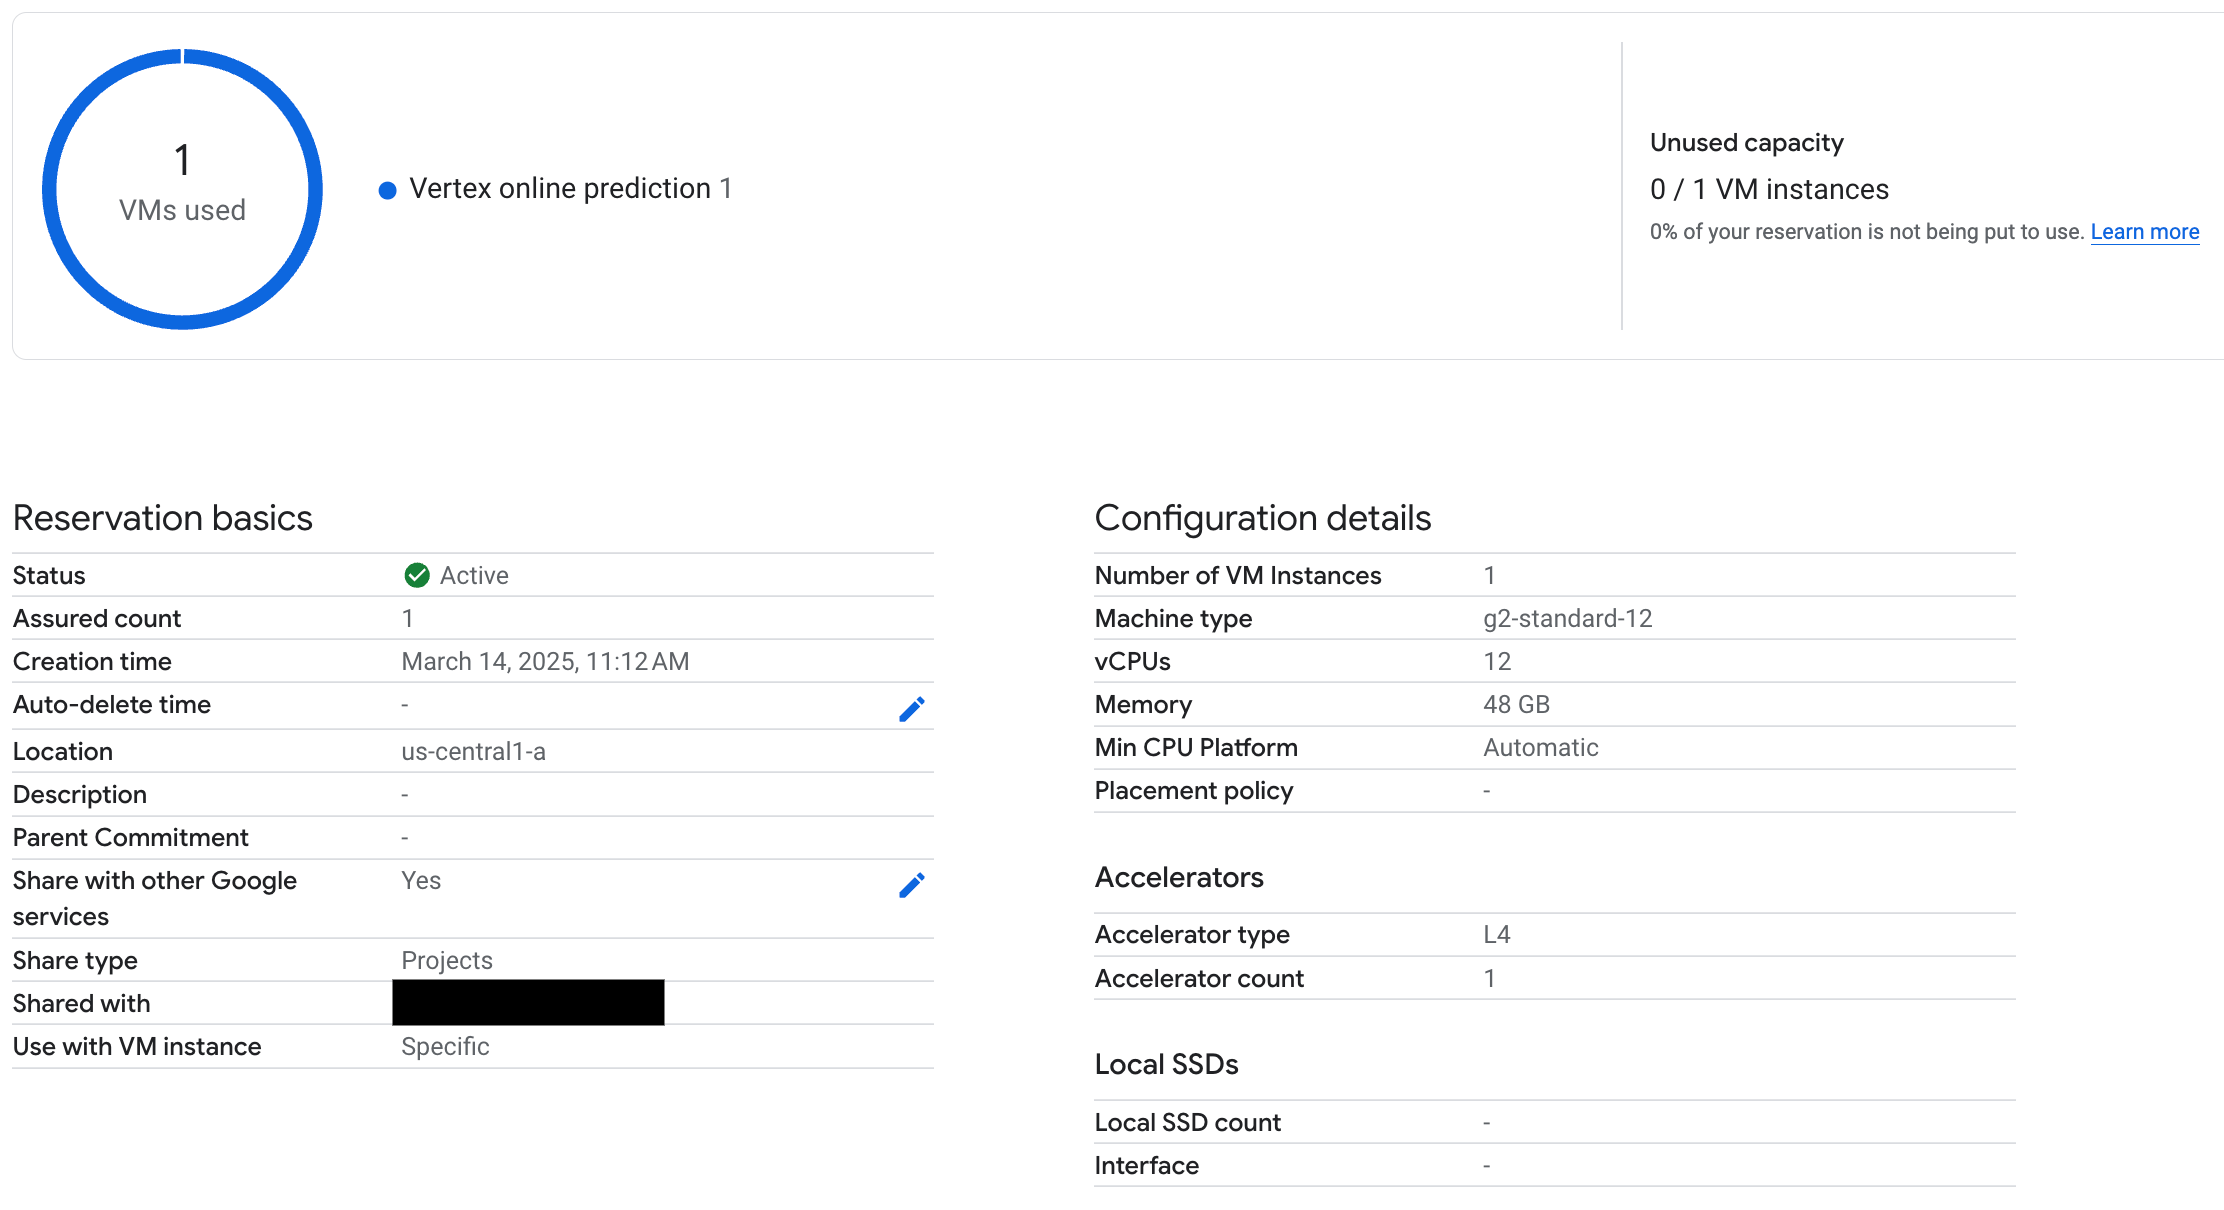 Gambar 3: Memeriksa pemesanan yang digunakan oleh prediksi online Vertex
7. Pembersihan
Untuk menghindari biaya berkelanjutan, hapus model, endpoint, dan pemesanan yang dibuat selama tutorial ini. Notebook Colab menyediakan kode di bagian "Clean Up" untuk mengotomatiskan proses pembersihan ini.
Pemecahan masalah
- Error Token Hugging Face: Periksa kembali apakah token Hugging Face Anda memiliki izin
readdan ditetapkan dengan benar di notebook. - Error Kuota: Pastikan Anda memiliki kuota GPU yang cukup di region tempat Anda men-deploy. Minta penambahan kuota jika diperlukan.
- Konflik Pemesanan: Pastikan jenis mesin dan konfigurasi akselerator deployment endpoint Anda cocok dengan setelan pemesanan Anda. Pastikan pemesanan diaktifkan untuk dibagikan dengan Layanan Google
Langkah berikutnya
- Jelajahi varian model Llama 3 yang berbeda.
- Pelajari pemesanan lebih lanjut dengan Ringkasan Pemesanan Compute Engine ini.
- Pelajari Spot VM lebih lanjut dengan Ringkasan Spot VM ini.