


此参考架构提供了一个概念框架,用于在 Google Distributed Cloud (GDC) 网闸隔离配置上部署和运行客户管理的 PostgreSQL 数据库。借助此解决方案,组织可以利用部署在虚拟机上的高可用性 (HA) 多可用区集群来维护关键数据库工作负载。
该架构侧重于弹性 3 节点配置,即使在单个可用区或基础设施发生故障时,也能确保数据库可用性。它涵盖了从自动化预配和网络到生产级运维(例如高可用性、备份、恢复和可观测性)的完整生命周期。
特性和功能
该解决方案提供了多个用于数据库管理的核心功能组件:
- 自动化高可用性:使用 Patroni 和 etcd 提供自动领导者选举和故障切换,确保数据库在无需人工干预的情况下保持运行。
- 多可用区弹性:将数据库节点分布在三个不同的可用区,以防范本地化硬件或基础架构服务中断。
- 标准化自动化:使用基于 Ansible 的 playbook 和 Autobase 预配整个堆栈,以确保可重复且一致的部署。
- 连接池:集成了 PgBouncer 服务,用于管理高连接数并稳定数据库节点上的资源消耗。
- 全球负载均衡:使用平台管理的全球 L4 负载均衡器提供可在所有可用区访问的单个稳定虚拟 IP (VIP)。
- 经过网闸隔离的就绪性:专用工作流,用于打包所有必需的操作系统依赖项和二进制文件,以便在断开连接的环境中进行部署。
- 数据保护:利用
pg_dump和pg_basebackup等标准工具以及 GDC 存储快照,维护强大的备份和恢复策略。
架构
该架构由一个三虚拟机环境组成,该环境分布在三个可用区中,运行一个共置的服务堆栈。
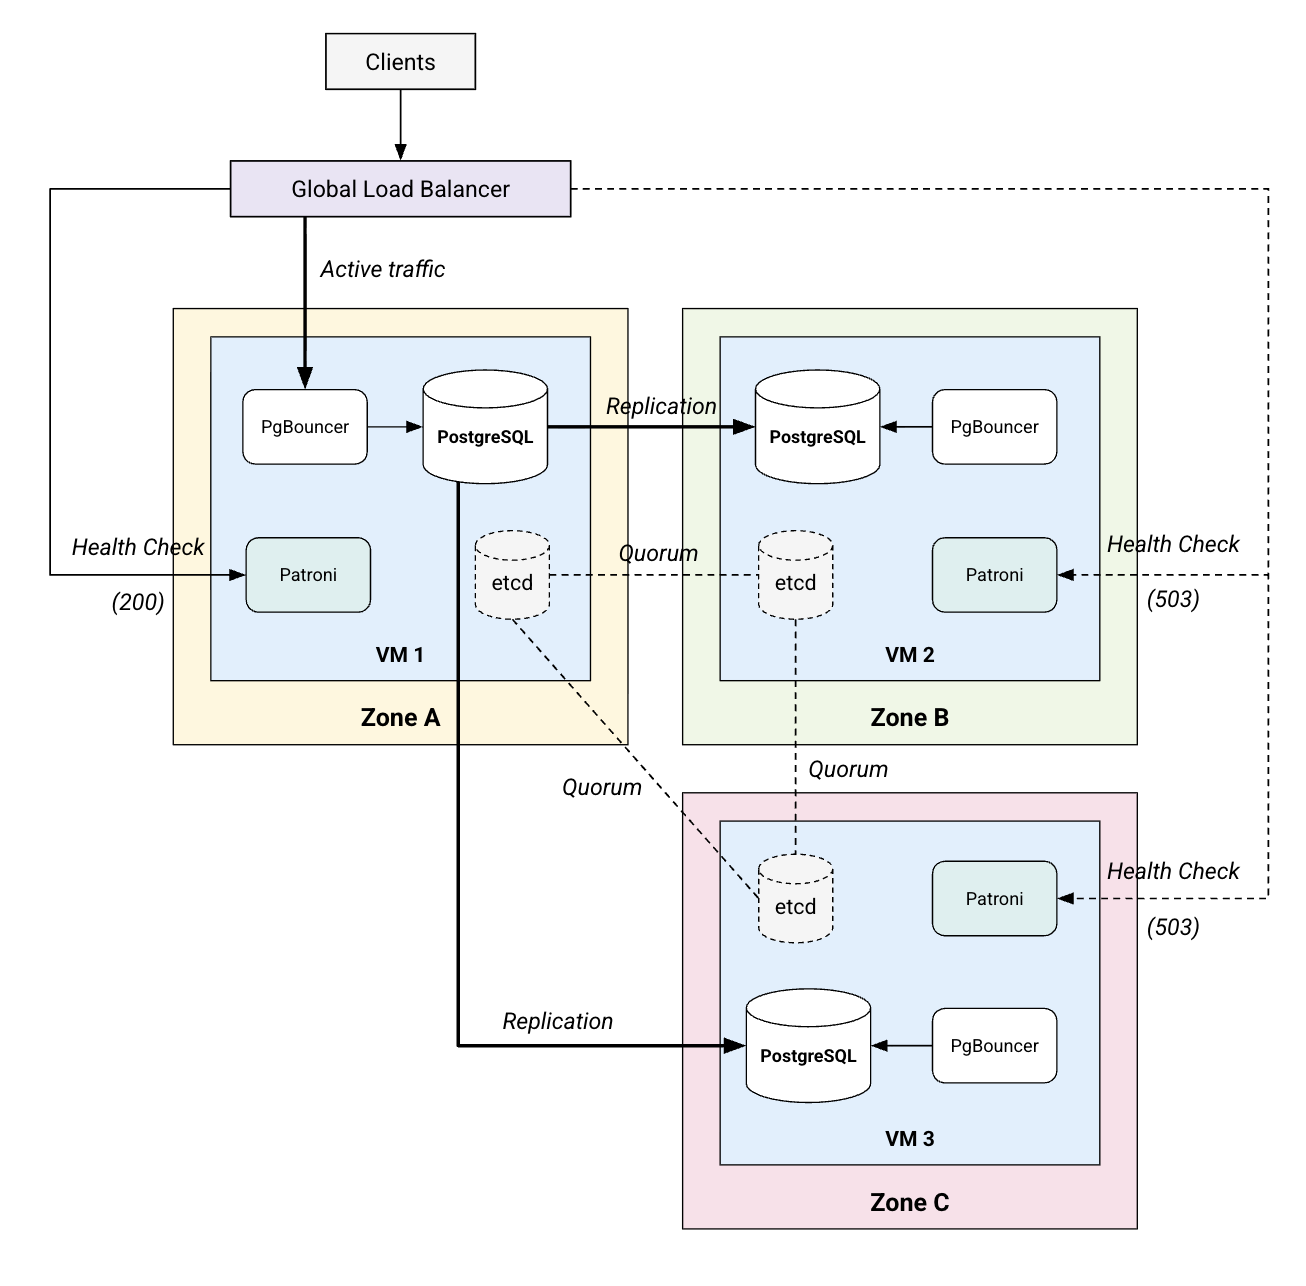
架构原则
- 基于多数的共识:使用基于仲裁的模型,其中大多数节点(3 个节点中的 2 个)必须就集群状态达成一致,从而防止“脑裂”情况并确保数据完整性。
- 关注点分离:每个虚拟机都运行一个共置但独立的服务栈(数据库、高可用性管理器、共识和池程序),以提供一个自包含且具有弹性的节点。
- 数据库感知型故障切换:优先考虑数据库健康指标,并使用 Patroni 的 REST API 通过平台负载均衡器协调流量重定向。
- 基础设施即代码:依赖自动化 playbook 执行所有配置任务,从而降低部署和伸缩过程中人为错误的风险。
概念和技术
本部分详细介绍了功能组件、其职责以及它们在系统中的通信方式。
基础架构和平台
- 虚拟机 (VM):分布在各个可用区中的专用计算实例,用于托管数据库堆栈。
- 全球 L4 负载均衡器:一项平台代管式服务,提供稳定的虚拟 IP (VIP),用于将流量路由到当前集群领导者。
- 永久性存储:需要高性能 SSD 支持的存储,以满足共识层预写式日志的严格延迟时间要求。
服务和逻辑
- PostgreSQL 17:负责数据持久化和查询执行的核心关系型数据库引擎。
- Patroni:高可用性管理器,用于监控本地 PostgreSQL 进程并使用 etcd 协调领导者选举。
- etcd:分布式配置存储区,提供共识层并保存集群的权威状态。
- PgBouncer:一种轻量级连接池,位于 PostgreSQL 前端,可高效处理传入的应用连接。
数据流和接口
- PgBouncer(端口 6432):应用数据库流量的主要入口点。
- Patroni API(端口 8008):负载均衡器使用的 HTTPS REST 接口,用于执行健康检查并使用
/primary端点识别当前领导者。 - etcd(端口 2379):共识集群用于维护状态和执行选举的通信通道。
注意事项
- 可伸缩性和性能:
- 数据库节点应根据工作负载进行大小调整,至少具有 2 个 vCPU 和 8 GiB RAM。生产环境工作负载通常从 8 个 vCPU 和 32 GiB 开始。
- 性能依赖于低延迟存储;需要使用 SSD 来确保 etcd 可以在 10 毫秒内处理数据同步。
- 同步复制:同步复制的开销直接取决于可用区之间的网络延迟时间。为确保零数据丢失配置的最佳性能,需要较低的可用区延迟时间。
- 资源管理和许可:
- 可用性和可靠性:
- 高可用性是通过 3 节点仲裁实现的。任何单个节点或可用区发生故障都不会中断服务。
- 集群稳定性:维护可靠的仲裁需要节点之间的网络延迟较低。平均往返时间 (RTT) 最好低于 10 毫秒,以防止选举超时和集群不稳定。
- 运营管理:
- 次要版本修补和主要升级等日常任务仍由客户的运维团队负责。
- 虚拟机的
stdout中的输出会自动注入到 GDC 网闸隔离配置监控平台中。我们日后会发布一份指南,介绍如何为各个组件集成更详细的监控。 - 应使用数据库原生工具和平台快照实施可靠的备份策略。这些程序的详细指南将单独发布。
设计决策
此解决方案的架构选择为多可用区部署提供了弹性路径。
Kubernetes 上的虚拟机
选择基于虚拟机的方法来提供多可用区高可用性。 GDC 不支持跨多个物理可用区的 Kubernetes 集群。因此,必须将专用虚拟机部署到不同的可用区,才能实现强大的跨可用区架构。此配置可以承受单个基础设施可用区的完全故障。
平台原生全球负载均衡
该架构利用 GDC 全球 L4 负载均衡器,而不是虚拟机上基于软件的代理。此方法具有以下优势:
- 全球覆盖:提供可在所有可用区访问的稳定虚拟 IP。
- 平台管理:VIP 由平台的控制平面独立管理。
- 简化的故障切换:故障切换通过标准健康检查探测进行管理,而不是通过复杂的本地软件配置进行管理。
- 高可用性:消除对本地代理的依赖可确保数据库流量的入口点保持弹性。
假设和限制
前提
- 环境具有本地注册表或机制,可导入打包的操作系统依赖项和二进制文件。
- 所有目标虚拟机均可使用基于密钥的 SSH 访问权限,以便进行基于 Ansible 的自动化。
- 项目有足够的配额来预配多可用区虚拟机和负载均衡器。
限制
- 手动维护:操作系统修补和 PostgreSQL 版本升级是手动任务,不会由解决方案自动执行。
- 存储敏感度:共识层 (etcd) 对磁盘延迟非常敏感。持续的高存储争用可能会影响共识层的稳定性。
- 网络稳定性:高可用性管理器依赖于可用区之间一致、低延迟的网络连接。延迟或网络抖动可能会影响集群协调和角色转换的时间。
其他资料
- 参考自动化代码库:GitHub 上的 Autobase 源代码
- PostgreSQL 数据库参考实现