


此参考架构提供了一个概念框架,用于在 Google Distributed Cloud (GDC) 网闸隔离配置上部署和运行高可用性、客户管理的 MariaDB 12 数据库。它使企业客户和抢先体验客户能够使用强大的多可用区虚拟机 (VM) 设置可靠地维护关键数据库工作负载。
由于 GDC 网闸隔离配置目前不支持跨可用区 Kubernetes 延伸集群,因此该架构严格依赖于跨三个可用性网域部署的专用虚拟机,以确保业务连续运行,并承受整个可用区故障而不丢失数据。
特性和功能
- 多可用区弹性:跨三个不同可用区部署的高弹性 3 节点配置,可防范单个基础设施可用区故障。
- 自动高可用性和共识:使用 Galera 进行同步多主集群,提供自动故障检测、节点共识和全局数据同步,而不会出现脑裂情况。
- 智能流量路由:共置的 HAProxy 实例管理连接池并严格路由流量,将写入操作(例如端口 3306)定向到活跃的主节点,并在同步的副本之间对读取操作(例如端口 3307)进行负载均衡。
- 全球负载均衡:与平台原生的 GDC 全球 L4 负载均衡器集成,为客户端应用提供单一、稳定的虚拟 IP (VIP),从而抽象化底层节点拓扑。
- 数据库感知型故障切换验证:利用轻量级自定义 Python 脚本或 clustercheck 等 OSS 解决方案(例如,在端口 9200 上公开),向负载均衡器和 HAProxy 提供健康检查,确保流量仅路由到健康且完全同步的节点。
架构原则
- 基于多数的同步共识:优先考虑严格的数据一致性,而不是最终一致性。Galera 强制执行基于仲裁的模型,该模型需要多数同意,从而消除了网络分区期间数据丢失或脑裂的风险。
- 关注点分离:将数据库复制层 (Galera) 与连接路由和故障切换检测层(HAProxy 和 Python 健康检查服务)分离。
- 基础架构优化:专为经过网闸隔离的环境而设计,利用强大的虚拟机绕过当前的 Kubernetes 网络限制。
架构
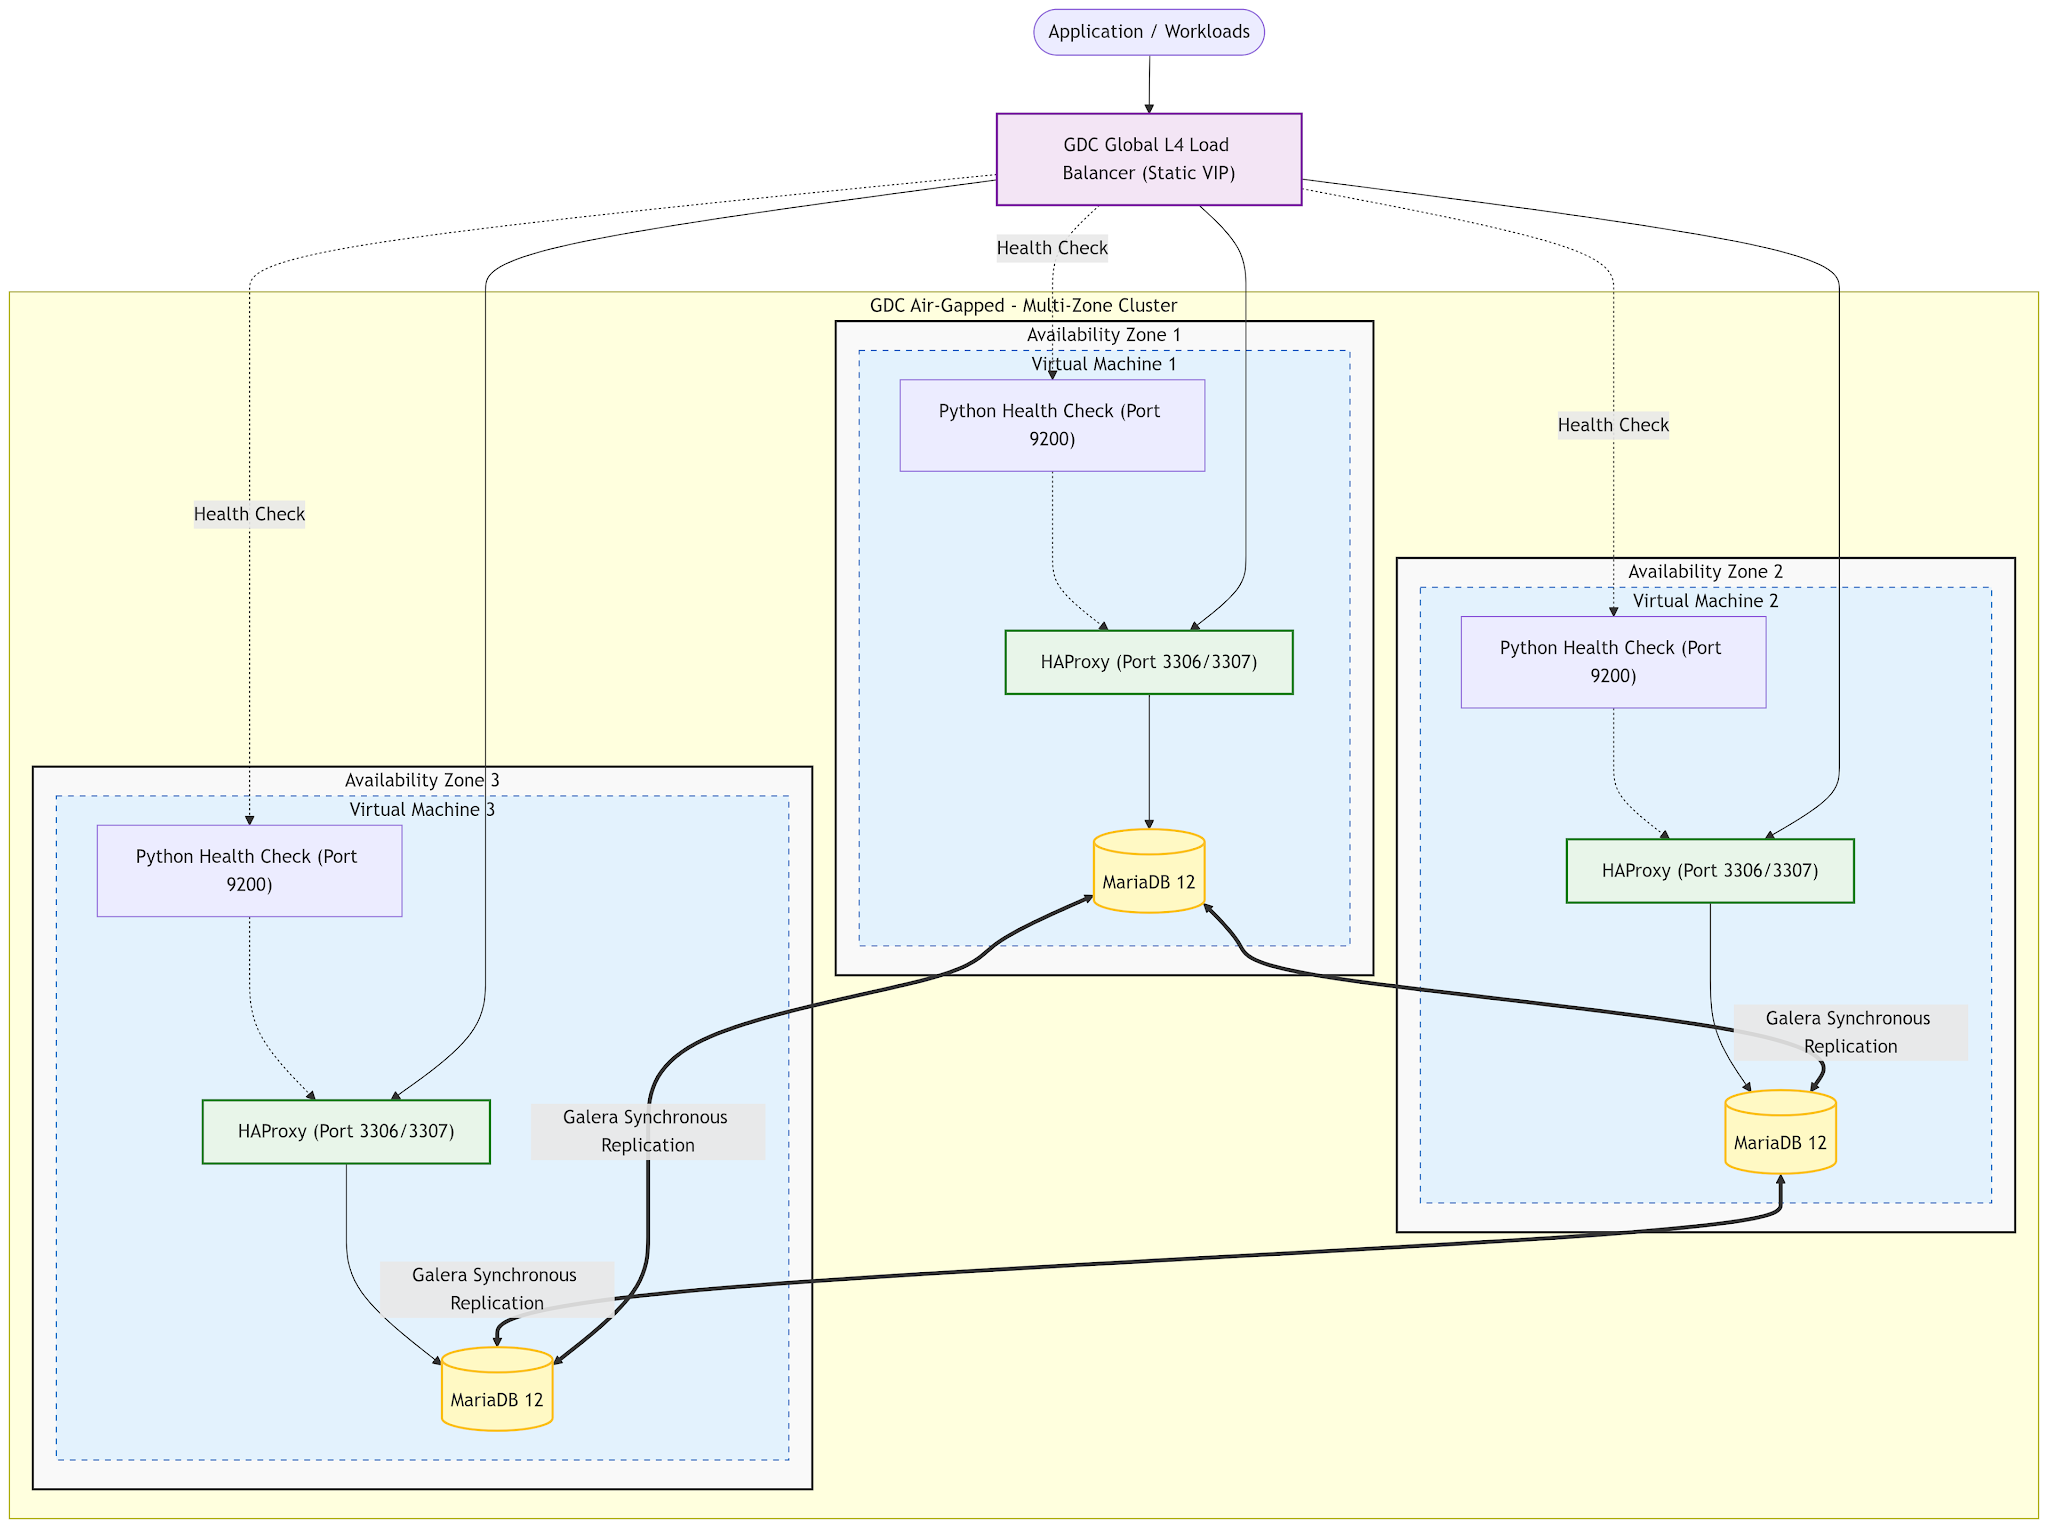
概念和技术
本部分详细介绍了多可用区架构中的功能组件及其具体职责。
基础架构和平台
- 虚拟机 (VM):三个专用计算实例,每个实例都部署到单独的可用区中,以形成故障域边界。
- GDC 全球 L4 负载均衡器:一种平台管理的网络结构,可公开稳定的内部 VIP,自动评估 Python 驱动的 HTTP 健康检查,以重定向入站流量。
服务和逻辑
- MariaDB 12:核心关系型数据库引擎。
- Galera 插件:负责同步多主节点复制和验证节点仲裁的集群框架。
- HAProxy:在每个虚拟机上充当流量路由器。配置为活跃/备份拓扑,用于写入以防止死锁,并配置为轮询以进行分布式读取。
- Python 健康检查服务:一个轻量级 HTTP 服务(封装在 systemd 中),它会持续轮询本地数据库状态,并通过端口 9200 将其健康状态信号传回 HAProxy 和 L4 负载均衡器。
数据流和接口
- 应用向全球 L4 负载均衡器 VIP 发送数据库请求。
- 负载均衡器会将连接代理到其中一个虚拟机上的健康 HAProxy 实例。
- HAProxy 会根据请求的端口动态转发流量:端口 3306 严格针对活跃节点进行写入,而端口 3307 则在整个集群中循环读取。
设计考虑事项
一般注意事项
- 性能与一致性之间的权衡:由于 Galera 是原生同步的,因此每笔事务都必须得到集群对等节点的确认。性能与 GDC 环境中的可用区际网络延迟直接相关。
- 资源管理:直接在数据库虚拟机上部署 HAProxy 可优化硬件利用率,但需要仔细调整资源,以防止连接池开销导致核心 MariaDB 进程资源不足。
健康检查注意事项
虽然此解决方案使用自定义 Python 脚本,因为它简单且没有外部依赖项,但客户可以选择使用 xinetd 和 clustercheck 实现标准 OSS 健康检查。
- 自定义 Python 脚本:利用预安装的 Python 3 和
http.server模块,非常适合经过网闸隔离的环境,因为它不需要额外的软件包传输。不过,客户必须维护自定义脚本代码。 - OSS 工具(
xinetd/clustercheck):将维护负担转移到开源社区,但在初始经过网闸隔离的软件准备期间,会增加架构复杂性和依赖项管理。
性能考虑因素
在规划部署时,请考虑以下具体因素,以优化性能和可靠性:
- 硬件容量:虽然要求因工作负载而异,但请使用这些标准配置文件作为每个虚拟机的起点:
- 开发/概念验证:2 个 vCPU,8GB RAM(稳定运行的最低要求)。
- 小型生产环境:4 个 vCPU,16GB RAM。适用于并发量适中的内部工具。
- 标准生产环境:8 个 vCPU,32 GB RAM。任务关键型应用的推荐基准。
- 高吞吐量:16 个以上 vCPU,64GB 以上 RAM。适用于具有大型工作集的工作负载,这些工作负载可受益于 InnoDB 缓冲池中的广泛数据缓存。
- 存储性能:高性能存储对于数据库持久性和集群稳定性至关重要。强烈建议使用 SSD 磁盘,以最大限度地减少同步复制“提交”阶段的写入延迟时间。为获得最佳性能,请将 p99 磁盘写入延迟时间控制在 10 毫秒以内,以确保 Galera
gcache或 MySQL 二进制日志不会成为瓶颈。 - 网络延迟时间和流控制:虚拟机之间的延迟时间会直接影响事务提交速度。
- 同步复制:在 Galera 或组复制集群中,每个写入事务都必须得到大多数节点的确认。GDC 网闸隔离配置中的可用区之间延迟时间通常小于 1 毫秒,这对于将写入开销保持在最低水平(通常为 10-30%)非常有利。
- 流控制:高网络抖动或单个“慢”节点可能会触发 Galera 流控制,从而暂停整个集群的写入,以便落后的节点赶上。
- HAProxy(或 MySQL 路由器)的作用:负载均衡器仍然必不可少:
- 流量拆分:HAProxy 可确保写入流量严格定向到单个活跃节点(端口 3306),以防止死锁,同时在所有同步副本(端口 3307)之间均衡只读查询。
- 连接稳定性:它提供了一个抽象层,可防止应用需要手动处理复杂的故障切换逻辑。
- 边车组件:自定义 Python 健康检查服务和负载均衡器虽然轻量,但至关重要。确保虚拟机具有一致的 CPU 可用性;在高负载场景中,虚拟机监控器级别的 CPU“窃取”可能会延迟健康检查响应,从而导致全球负载均衡器过早地从轮替中逐出健康状况良好的节点。
设计决策
此 SRA 中的架构选择明确解决了 GDC 网闸隔离配置的限制,并针对高吞吐量进行了优化。
- Kubernetes 上的虚拟机:GDC 网闸隔离配置目前不支持跨多个物理可用区的 Kubernetes 集群。我们之所以严格选择基于虚拟机的方法,是因为在不同的可用区中部署专用虚拟机是实现真正的多可用区高可用性并在整个可用区故障中幸存的唯一可行方法。
- Galera 与主/从手动设置(使用 ProxySQL):评估了与 ProxySQL 搭配使用的传统主/从架构,认为其是可行的替代方案。不过,除了 ProxySQL 之外,处理手动故障切换逻辑还涉及大量的脚本编写和操作复杂性。我们之所以选择 Galera,是因为其原生同步特性大大降低了故障切换的复杂性,并提供了明显更好的性能。
- 拒绝 Orchestrator:Orchestrator 被广泛视为用于自动故障切换的业界标准拓扑管理器。不过,经过评估,我们最终拒绝了该方案,因为它仅支持 MariaDB 10,与严格高于 11 的 MariaDB 版本不兼容。这导致它与我们的目标 MariaDB 12 要求不兼容。
- 平台原生全球负载均衡:利用原生 GDC 全球 L4 负载均衡器,可确保 VIP 受 GDC 控制平面控制,从而保持入口点的弹性并简化跨可用区流量传送。
假设和限制
前提
- 基础架构的可用性:客户有足够的项目配额来预配专用、大小合适的虚拟机和全球负载均衡器,这些虚拟机和负载均衡器均匀分布在 3 个可用区中。
- 安全网络:建立基于密钥的访问权限和适当的 ProjectNetworkPolicy (PNP),以允许集群内 Galera 同步和健康检查轮询。
限制
- Kubernetes 不受支持:在平台完全支持拉伸集群之前,严格寻求容器化/基于 Kubernetes 的解决方案的客户无法实现多可用区高可用性。
- 需要手动升级:与托管式服务不同,此解决方案将常规操作系统级修补、数据库次要版本升级和 Galera 版本管理的责任完全交由客户承担。
- 网络延迟敏感性:同步复制需要高质量、稳定的网络。经过网闸隔离的可用区之间的网络抖动或延迟时间峰值会按比例延迟整个 MariaDB 集群的写入操作。
其他资料
- 解决方案参考实现 - GDC 网闸隔离配置中的高可用性多可用区 MariaDB 12 数据库