


Descripción general
Esta arquitectura de referencia define el diseño conceptual para implementar Elastic Stack (Elasticsearch y Kibana) en Google Distributed Cloud (GDC) aislado y, luego, integrarlo en un servicio de modelo de lenguaje grande (LLM) para habilitar las funciones potenciadas por IA generativa de Elastic.
Elastic Stack es una plataforma de análisis de seguridad, observabilidad y búsqueda ampliamente adoptada. Las versiones recientes de Elastic agregan capacidades de IA generativa a Kibana, incluido el agente de IA de Elastic, los agentes personalizados creados con Agent Builder y Attack Discovery. Estas funciones se basan en un LLM para traducir las solicitudes en lenguaje natural en consultas de Elasticsearch, organizar llamadas a herramientas de varios pasos y correlacionar alertas de seguridad.
Esta arquitectura implementa Elastic Stack con el operador oficial de Elastic Cloud en Kubernetes (ECK) disponible en el Marketplace de GDC aislado y conecta Kibana a un extremo de inferencia de LLM alojado dentro del límite de GDC, ya sea el servicio administrado de Gemini en GDC o un servidor de inferencia autoadministrado compatible con OpenAI, como Ollama o vLLM.
Características y funciones
La solución proporciona varios componentes funcionales principales para la búsqueda asistida por IA, la observabilidad y el análisis de seguridad:
- Administración del ciclo de vida basada en Marketplace: Instala el operador de ECK desde
el Marketplace de GDC aislado en un espacio de nombres de proyecto
en un clúster compartido y deja que automatice el aprovisionamiento,
la configuración y la conciliación de los recursos personalizados de
ElasticsearchyKibana. - Investigación de datos en lenguaje natural: Usa el agente de IA de Elastic para explorar los datos de Elasticsearch en lenguaje natural. El agente descubre índices y asignaciones, genera y ejecuta consultas de ES|QL, y sintetiza los hallazgos sin necesidad de tener conocimientos previos del esquema subyacente.
- Agentes personalizados y flujos de trabajo automatizados: Usa Agent Builder para crear agentes diseñados específicamente que combinen instrucciones personalizadas con herramientas integradas, herramientas de ES|QL personalizadas y flujos de trabajo de Kibana (por ejemplo, abrir automáticamente casos de seguridad de Kibana con hallazgos de investigación).
- Correlación de alertas de seguridad impulsada por IA: Usa Attack Discovery para analizar las alertas abiertas de Elastic Security, asignarlas al framework de MITRE ATT&CK y correlacionar las alertas, las direcciones IP y las cuentas de usuario relacionadas en cadenas de ataque.
- Compatibilidad con entornos aislados: Las imágenes de contenedor del operador de ECK, Elasticsearch y Kibana se extraen del registro local de Harbor de GDC, y todo el tráfico de inferencia de LLM permanece en la red interna de GDC.
- Backends de LLM conectables: Conecta Kibana a Gemini administrado en
GDC o a cualquier servidor de inferencia autoadministrado que exponga
una API de
/v1/chat/completionscompatible con OpenAI a través del conector de OpenAI de Kibana.
Principios de arquitectura
- Modelo de responsabilidad compartida: GDC proporciona el clúster compartido, el paquete de Marketplace, el registro de Harbor y las herramientas de redes. El cliente opera la implementación de Elastic Stack, administra las licencias de Elastic y es propietario de la selección y la operación del servicio de LLM autoadministrado (si se usa).
- Soberanía de los datos: Todos los datos operativos y de seguridad, las instrucciones y las respuestas del modelo permanecen dentro del límite de GDC aislado. No se envía tráfico a los servicios de LLM públicos o alojados en Elastic.
- Operaciones nativas de la nube: Usa el patrón de operador de Kubernetes para administrar las cargas de trabajo de Elastic con estado de forma declarativa, lo que garantiza implementaciones coherentes y repetibles.
- Estandarización de protocolos: Se basa en la API de finalización de chats compatible con OpenAI, que es ampliamente compatible, con llamadas a funciones nativas, lo que desvincula a Kibana de cualquier motor de inferencia o proveedor de modelos específico.
Arquitectura
La arquitectura consiste en una implementación de Elastic Stack administrada por el operador de ECK dentro de un espacio de nombres del proyecto en un clúster de usuario compartido de GDC. Kibana se comunica a través de la red interna de GDC con un extremo de inferencia de LLM.
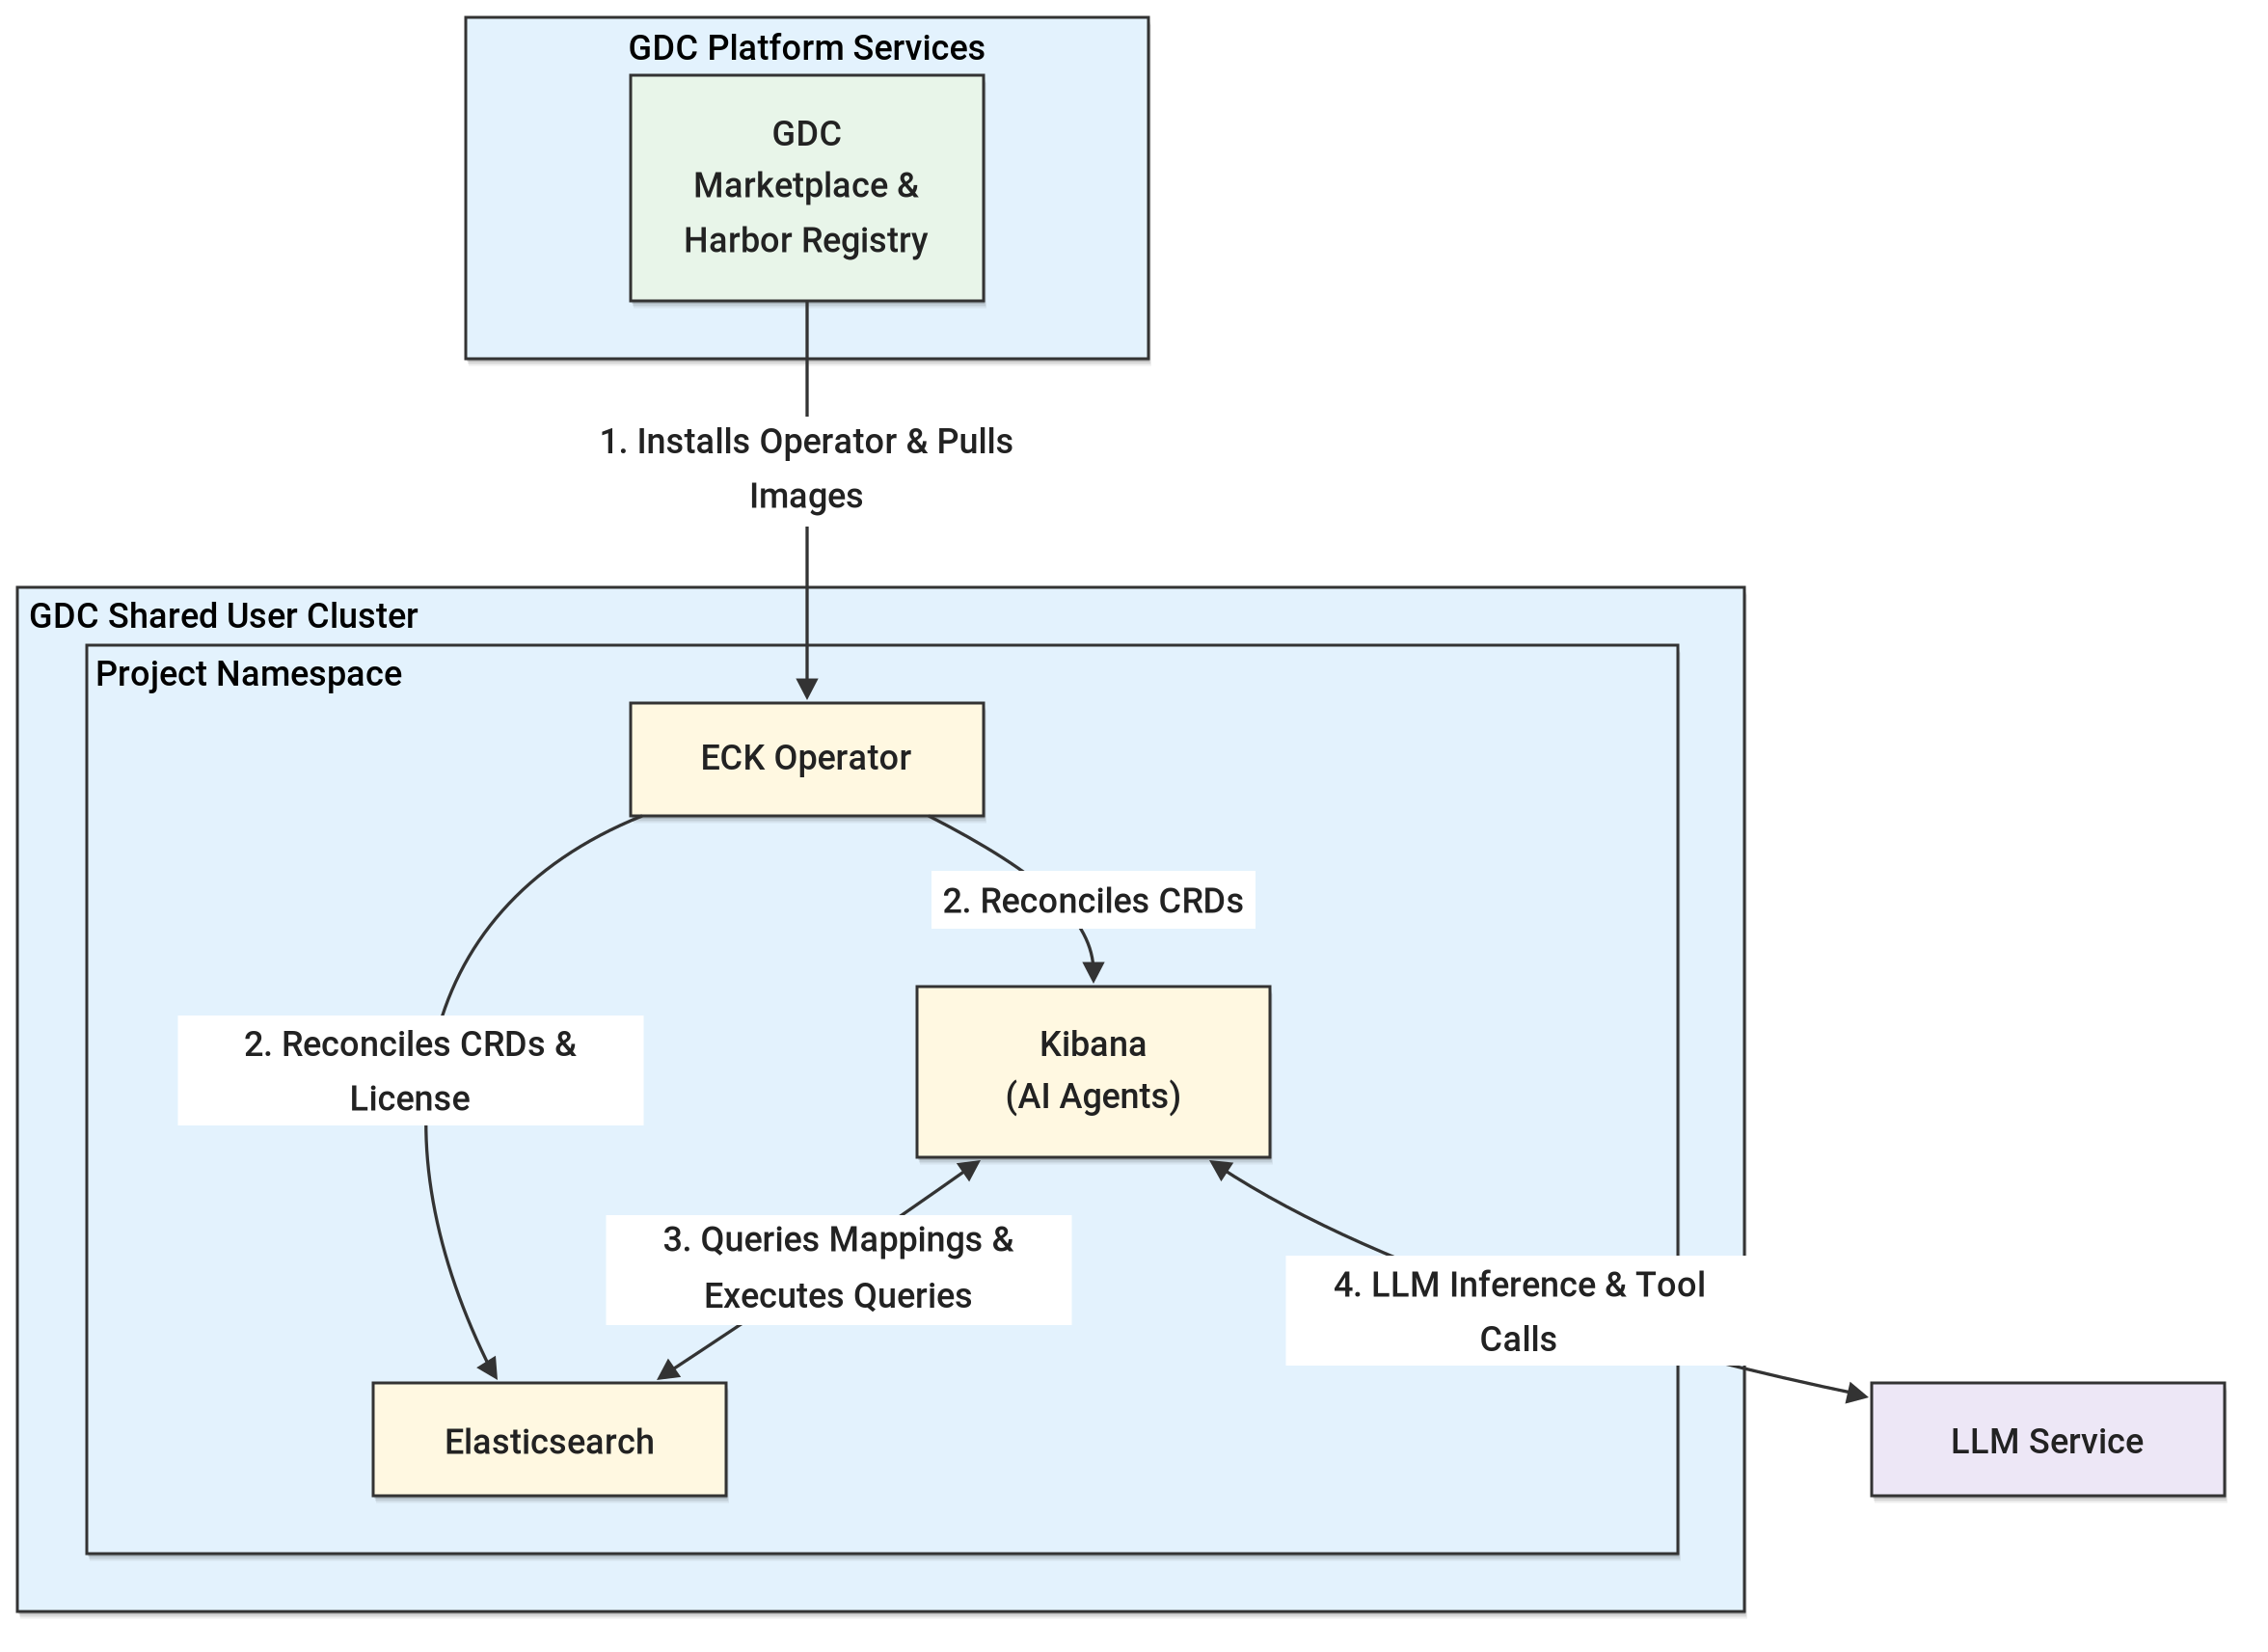
Entre los componentes clave de esta arquitectura, se incluyen los siguientes:
- Clúster compartido de GDC: Es un clúster de Kubernetes compartido con alcance de organización que se conecta a varios proyectos y aloja paquetes de software y cargas de trabajo de aplicaciones de GDC Marketplace.
- Proyecto de GDC: Es el espacio de nombres del proyecto en el clúster compartido que aísla el operador de ECK, el clúster de Elasticsearch, la instancia de Kibana y los Secrets y las NetworkPolicies de Kubernetes asociados.
- Operador de Elastic Cloud on Kubernetes (ECK): Se instala desde
Marketplace de GDC en el espacio de nombres del proyecto, el
operador administra los recursos personalizados
ElasticsearchyKibana, y concilia la licencia de Elastic necesaria para las funciones potenciadas por IA generativa y los conectores de LLM externos. - Elasticsearch: Almacena y, además, indexa datos operativos y de seguridad, y ejecuta consultas de búsqueda y ES|QL generadas por las funciones de IA y los agentes de Kibana.
- Kibana: Aloja las funciones de IA generativa de Elastic (Elastic AI Agent, Agent Builder y Attack Discovery) y administra los conectores de acciones de LLM que organizan las llamadas a herramientas de varios pasos entre el usuario, Elasticsearch y el servicio de LLM.
- Servicio de LLM: Es un servicio de LLM administrado (como Gemini en GDC) o un servidor de inferencia autoadministrado (como Ollama o vLLM) que proporciona capacidades de finalización de chat y llamada a la herramienta a Kibana a través de la red interna de GDC.
Conceptos y tecnologías
En esta sección, se detallan los componentes funcionales, sus responsabilidades y cómo se comunican dentro del sistema.
Infraestructura y plataforma
- Clúster compartido de GDC: Es el entorno de procesamiento principal en el que residen el operador de ECK, Elasticsearch y los Pods de Kibana dentro de un espacio de nombres del proyecto.
- Marketplace de GDC: Es el catálogo que se usa para instalar y actualizar el paquete de Marketplace de Elastic, que registra las CustomResourceDefinitions de Elastic y, además, implementa el StatefulSet de
elastic-operator. - Registro de Harbor: Es la fuente de información local y segura para el operador de ECK, Elasticsearch y las imágenes de contenedor de Kibana en el entorno aislado.
- Almacenamiento persistente: Las PersistentVolumeClaims aprovisionadas a través de
volumeClaimTemplatesde Elasticsearch proporcionan almacenamiento en bloque duradero para los datos de Elasticsearch. - Herramientas de redes de GDC: Los Services LoadBalancer exponen
Elasticsearch (puerto
9200) y Kibana (puerto5601), mientras que los recursosNetworkPolicyyProjectNetworkPolicyglobales de Kubernetes rigen el tráfico entrante y entre proyectos, incluida la conectividad con el servicio de LLM.
Servicios y lógica
- Operador de ECK: Es el controlador que supervisa los recursos personalizados
ElasticsearchyKibanay los concilia en StatefulSets, Deployments, Services y Secrets. Sulicense-controllerconcilia de forma continua la licencia del clúster con los Secrets de licencia en el espacio de nombres del operador. - Agente de IA de Elastic: Es el agente conversacional predeterminado en Kibana. Usa
herramientas integradas de Agent Builder (
platform.core.list_indices,platform.core.get_index_mapping,platform.core.searchyplatform.core.execute_esql) para descubrir datos, generar ES|QL y resumir resultados. - Agent Builder: Es el framework para crear agentes personalizados que combinan
instrucciones del sistema personalizadas con herramientas integradas y herramientas definidas por el usuario
(
esql,index_search,workflowymcp). - Flujos de trabajo de Kibana: Automatizaciones declarativas definidas por YAML (por ejemplo,
cases.createCase) que se pueden registrar como herramientas de Agent Builder para permitir que los agentes realicen acciones, como abrir casos de seguridad de Kibana. - Attack Discovery: Es una función de seguridad de Elastic Security que envía contexto de alerta anonimizado al LLM para correlacionar las alertas del índice
.alerts-security.alerts-defaulten cadenas de ataque asignadas a tácticas de MITRE ATT&CK. - Servicio de LLM: Proporciona finalizaciones de chat ajustadas a instrucciones con compatibilidad nativa con llamadas a herramientas. El modelo debe generar de forma confiable invocaciones de herramientas válidas, JSON estructurado y consultas de ES|QL.
Flujo de datos e interfaces
- API de finalización de chat compatible con OpenAI (
/v1/chat/completions): Es la interfaz entre el conector de OpenAI (.gen-ai) de Kibana y el servicio de LLM, configurada con el proveedor Otro (servicio compatible con OpenAI), la llamada a funciones nativa habilitada y la transmisión de eventos enviados por el servidor. - APIs de REST y ES|QL de Elasticsearch: Kibana y sus agentes las usan para inspeccionar asignaciones, ejecutar búsquedas y ejecutar agregaciones de ES|QL.
- APIs de REST de Kibana: Se usan para la administración programática de conectores
(
/api/actions), agentes y herramientas (/api/agent_builder), flujos de trabajo (/api/workflows), reglas de detección (/api/detection_engine) y Attack Discovery (/api/attack_discovery). - HTTPS con autenticación integrada: Los extremos de Elasticsearch y Kibana se entregan a través de TLS con certificados generados por ECK, con credenciales almacenadas en Secrets de Kubernetes administrados por ECK.
Consideraciones
- Escalabilidad y rendimiento:
- Las solicitudes de recursos, los límites, los recuentos de nodos y los tamaños de almacenamiento de Elasticsearch y Kibana deben ajustarse a partir de los valores predeterminados de evaluación para que coincidan con los volúmenes de datos de producción y la simultaneidad de consultas.
- El conector de OpenAI de Kibana aplica un tiempo de espera predeterminado de 60 segundos por turno de transmisión. El servicio de LLM debe ejecutarse en la aceleración de GPU con optimizaciones, como Flash Attention, para mantener cada turno dentro de este límite.
- Un solo turno de agente puede activar llamadas secundarias de LLM anidadas. El servidor de inferencia
debe mantener varias ranuras de caché de KV paralelas (por ejemplo,
OLLAMA_NUM_PARALLEL=2) para evitar que las llamadas secundarias expulsen el contexto almacenado en caché de la conversación principal.
- Requisitos del modelo de LLM:
- El modelo debe ajustarse con instrucciones y compatibilidad nativa con llamadas a funciones. La llamada a funciones nativa debe estar habilitada en el conector de Kibana, ya que la llamada a funciones simulada basada en instrucciones es menos confiable para las llamadas a la herramienta anidadas.
- Se recomienda una ventana de contexto de al menos 128,000 tokens, ya que las investigaciones de varios pasos que combinan definiciones de herramientas, esquemas de índices, documentación de ES|QL y resultados de la búsqueda pueden superar los 70,000 tokens.
- Se recomienda un límite de tokens de salida de al menos 8,192 tokens y una penalización
por repetición leve para los modelos con capacidad de razonamiento, ya que Kibana
trata un motivo de finalización
lengthcomo un error fatal y usa la decodificación codiciosa. - La detección de ataques requiere un modelo de clase 30B o superior (como
gemma4:31b) para sintetizar de forma confiable resultados estructurados de varias alertas.
- Seguridad y cumplimiento:
- Todas las instrucciones, los datos recuperados y las respuestas del modelo permanecen en la red interna de GDC.
- Las políticas de red deben ajustarse desde la configuración de evaluación permisiva para restringir el acceso entrante a Elasticsearch y Kibana a los clientes autorizados y limitar la salida al extremo del servicio de LLM.
- El acceso a Kibana y Elasticsearch debe regirse a través de los controles de acceso
basados en roles de Elastic, en lugar del superusuario
elastic.
- Administración de recursos y licencias:
- Las funciones de IA generativa de Elastic y los conectores de LLM externos requieren una licencia Enterprise (o una prueba de Enterprise activa de 30 días), que se debe aprovisionar a través de un Secret de licencia de ECK para que persista en los ciclos de conciliación del operador.
- Disponibilidad y confiabilidad:
- Las implementaciones de producción deben usar varios nodos de Elasticsearch con fragmentos de réplica y varias instancias de Kibana para evitar puntos únicos de falla.
- La disponibilidad de las funciones potenciadas por IA depende de la disponibilidad y la latencia del servicio de LLM.
- Administración operativa:
- El cliente es responsable de actualizar el paquete de Elastic de Marketplace y las versiones de Elastic Stack, administrar las licencias y crear copias de seguridad de los datos de Elasticsearch.
- Cuando se usa un servicio de LLM autoadministrado, el cliente es propietario de su implementación, la planificación de la capacidad de la GPU, las actualizaciones del modelo y el ajuste.
Decisión de diseño
Las principales opciones de arquitectura para esta solución se enfocan en habilitar las funciones de IA generativa de Elastic dentro de las restricciones del entorno aislado.
Operador de ECK desde GDC Marketplace
El operador de ECK se instala desde el Marketplace de GDC aislado, en lugar de implementarse de forma manual. El paquete de Marketplace viene preconfigurado para extraer imágenes de contenedor del registro local de Harbor, registra las CustomResourceDefinitions requeridas y se integra en los roles de IAM a nivel de proyecto de GDC. Esto reduce el esfuerzo de duplicación de imágenes y mantiene la implementación alineada con el ciclo de vida del software de GDC.
Implementación de clústeres compartidos
La solución implementa Elastic Stack en un espacio de nombres del proyecto en un clúster compartido de GDC. Esto permite que los clientes consuman el software de Marketplace junto con otras cargas de trabajo del proyecto sin aprovisionar ni operar un clúster dedicado, mientras que el espacio de nombres del proyecto proporciona aislamiento de recursos, Secrets y políticas de red.
Opciones de servicio de LLM
Gemini administrado en GDC es la opción preferida
cuando está disponible, ya que quita la carga operativa de alojar la infraestructura
de inferencia. Cuando no está disponible o cuando los clientes requieren un modelo abierto
específico, Kibana puede conectarse a cualquier servidor de inferencia autoadministrado que exponga
un extremo /v1/chat/completions compatible con OpenAI. La estandarización en esta API
mantiene la configuración de Elastic independiente del motor de inferencia (como
Ollama o vLLM).
Llamada a funciones nativas
La llamada a funciones nativa está habilitada en el conector de Kibana para que el formato de la llamada a la herramienta
se delegue al protocolo tools de OpenAI del servidor de inferencia.
La llamada a funciones simulada basada en instrucciones predeterminada de Kibana es menos confiable durante
las llamadas a herramientas anidadas y puede fallar con errores de análisis.
Conciliación de licencias administradas por ECK
La licencia de Enterprise (o de prueba) se declara como un Secret de licencia de ECK en lugar
de activarse directamente a través de la API de licencias de Elasticsearch. Debido a que ECK
concilia de forma continua la licencia del clúster, las licencias aplicadas fuera de ECK se
revierten a basic en el siguiente ciclo de conciliación.
Suposiciones y limitaciones
Suposiciones
- Un clúster compartido de GDC y un proyecto adjunto están disponibles, con suficiente capacidad de procesamiento y almacenamiento persistente para el operador de ECK, Elasticsearch y Kibana.
- El paquete de Elastic de Marketplace y las imágenes de contenedor de Elasticsearch y Kibana coincidentes están disponibles en el Marketplace de GDC aislado y en el registro local de Harbor.
- Los usuarios tienen los roles de proyecto requeridos (
namespace-admin,project-viewer,marketplace-editoryproject-networkpolicy-admin). - Se implementa un servicio de LLM (Gemini administrado en GDC o un servidor de inferencia compatible con OpenAI autoadministrado) y se puede acceder a él desde el Pod de Kibana a través de la red interna de GDC.
- Hay una licencia de Elastic Enterprise disponible o se usa la prueba de 30 días de Enterprise para la evaluación.
Limitaciones
- Servicio de LLM fuera del alcance: Esta arquitectura no abarca la implementación ni la operación de un servicio de LLM autoadministrado, incluida la infraestructura de GPU.
- No hay servicios de IA alojados en Elastic: Los LLM administrados por Elastic y otros servicios de IA de Elastic alojados en la nube no están disponibles en el entorno aislado.
- Calidad que depende del modelo: La exactitud y confiabilidad de los resultados de agente de IA, Agent Builder y Attack Discovery dependen de las capacidades del modelo seleccionado y su configuración de entorno de ejecución.
- Valores predeterminados de nivel de evaluación: La implementación de referencia usa un clúster de Elasticsearch de un solo nodo, certificados autofirmados y políticas de red permisivas, que se deben endurecer para el uso en producción.
- Especificidad de la versión: La solución se validó con Elastic v9.4.0, Elastic Kubernetes Operator v3.4.0 y GDC v1.16.2. Es posible que otras versiones requieran ajustes.
Materiales adicionales
Implementación de referencia de la solución (SRI): Implementa las funciones potenciadas por IA generativa de Elastic Stack en GDC aislado