


プロブレム ステートメント
エアギャップ環境で大規模言語モデル(LLM)を実行する組織は、モデル エンドポイントを急速に蓄積します。Google Distributed Cloud(GDC)エアギャップで提供されるすべてのオープン ウェイト モデル(コンパニオン ガイドセット GDC エアギャップのオープン ウェイト モデルを参照)は、独自の Kubernetes Service、独自のアドレス、独自の認証情報、独自の運用ライフサイクルを公開します。アプリケーション開発者とエージェント開発者は、アーキテクチャのサイロ化に陥り、モデルごとに 1 つのエンドポイントをハードコードし、モデルの反復処理ごとに統合を書き直すことになります。この断片化により、技術的負債が発生し、ミッション クリティカルなマルチステップのエージェント型ワークロードのデプロイが遅くなります。
標準のネットワーキング レイヤは「AI を認識」しません。従来のロードバランサは、推論トラフィックを汎用 HTTP のように扱い、リクエストの model フィールドを読み取ったり、レイテンシの影響を受けやすいワークロードを優先したり、リクエストではなくトークンを考慮したり、関連する KV キャッシュをすでに保持しているモデルサーバー レプリカにリクエストを転送したりすることはできません。高コストのエアギャップ GPU クラスタでは、ハードウェアの使用率が低下し、投資収益率が低下します。GDC の Gemini はマネージド フロンティア モデルを提供しますが、セルフホスト型のオープン ウェイト モデルと組み合わせるお客様には、データ主権を損なうことなく、クラウドのような俊敏性を提供する推論レイヤが必要です。リクエスト、プロンプト、モデルの重みが GDC の境界を越えることはありません。
提案するソリューション
このドキュメントでは、GDC エアギャップ上のセルフマネージド AI ゲートウェイのリファレンス アーキテクチャについて説明します。これは、アプリケーションにすべてのモデルに対して 1 つの OpenAI 互換エンドポイントを提供し、各リクエストを適切なバックエンドにルーティングする、安全で一元化された推論レイヤです。リファレンス実装は Kubernetes Gateway API をベースにしています。Envoy Gateway は Gateway API 実装(コントロール プレーンと Envoy プロキシ データプレーン)であり、Envoy Agent Router(旧 Envoy AI Gateway)は、AI 固有のリクエスト処理(リクエスト本文からのモデル抽出、リクエストとレスポンスの変換、アップストリーム認証、トークン アカウンティング、オプションのトークンベースのレート制限)でこれを拡張します。Gateway API Inference Extension は、モデルサーバー対応のエンドポイント選択(InferencePool とエンドポイント ピッカー)を追加して、GPU 容量を効率的に使用できるようにします。すべてのアーティファクトは GDC 組織の Harbor レジストリにステージングされ、スタック全体が外部接続なしで標準クラスタで実行されます。
含まれる内容: このアーキテクチャでは、標準クラスタでの Envoy Gateway と Envoy Agent Router のデプロイ、統合された OpenAI 互換エンドポイントを公開する Gateway API リソース(GatewayClass、Gateway)と Envoy Agent Router リソース(AIGatewayRoute、AIServiceBackend、BackendSecurityPolicy、GatewayConfig)、model フィールドでの本文ベースのルーティング、モデル認識ロード バランシング用の Gateway API Inference Extension(InferencePool、InferenceObjective、エンドポイント ピッカー)、Redis を使用したオプションのトークンベースのレート制限、ゲートウェイでの TLS 終端、ネットワーク ポリシー(NetworkPolicy / ProjectNetworkPolicy)、Harbor でのエアギャップ アーティファクト管理について説明します。ゲートウェイの背後にあるモデル提供バックエンド(Ollama、vLLM)は、コンパニオン ガイド セットの GDC エアギャップのオープン ウェイト モデルとともにデプロイされます。
含まれないもの: このアーキテクチャでは、マネージド AI ゲートウェイ プロダクト、モデル自体のデプロイとチューニング(コンパニオン ガイドセット)、モデルのファインチューニング、LLM 以外の生成 AI モダリティ、エージェントからツールへのトラフィック(MCPRoute)、商用サポートされているゲートウェイ ディストリビューションは対象外です。Gemini on GDC はマネージド プロダクト機能です。そのプロビジョニングは対象外です。このバージョンのガイドセットでは、セルフホスト型のオープン ウェイト モデルを使用してゲートウェイを検証します。
対象者: このドキュメントの主な対象者は、標準クラスタでのゲートウェイのデプロイと運用を担当するプラットフォーム管理者と、エアギャップ環境内で AI プラットフォームを設計するテクニカル アーキテクトです。統合エンドポイントを使用するアプリケーション デベロッパーは、リクエストのルーティング方法を理解することでメリットを得られる二次的な対象者です。
アーキテクチャ
このソリューションは、GDC エアギャップ組織の標準クラスタで完全に実行されます。サービスレイヤでは、Kubernetes Gateway API が構成モデルを標準化します。AI ゲートウェイ コントロール プレーン(Envoy Gateway コントローラと Envoy Agent Router コントローラ)は、Gateway API リソースと Envoy Agent Router リソースを読み取り、データプレーンを構成します。データプレーンは、リクエストのエントリ ポイントである Envoy プロキシ Deployment(LoadBalancer タイプの Service を介して公開)と、プロキシ Pod でサイドカーとして実行され、AI 固有のロジックを実行する Envoy Agent Router 外部プロセッサです。アプリケーション レイヤでは、顧客のワークロード(アプリケーションとエージェント)が AI リクエストをプロキシに送信します(1)。プロキシはリクエストを外部プロセッサに渡し、外部プロセッサはモデル名を抽出してリクエストを変換し、トークンの使用状況を記録します(2)。プロキシは、バランス調整されたトラフィックを選択したモデルの推論 Pod に転送します(3)。モデルはインフラストラクチャ レイヤの GPU ノードで実行されます(4)。モデル提供バックエンドは、AIServiceBackend(OpenAI 互換の Service)または InferencePool(エンドポイント ピッカーがリクエストごとに最適なレプリカを選択する)としてゲートウェイに接続されます。コンテナ イメージと Helm チャートは Harbor から pull されます。
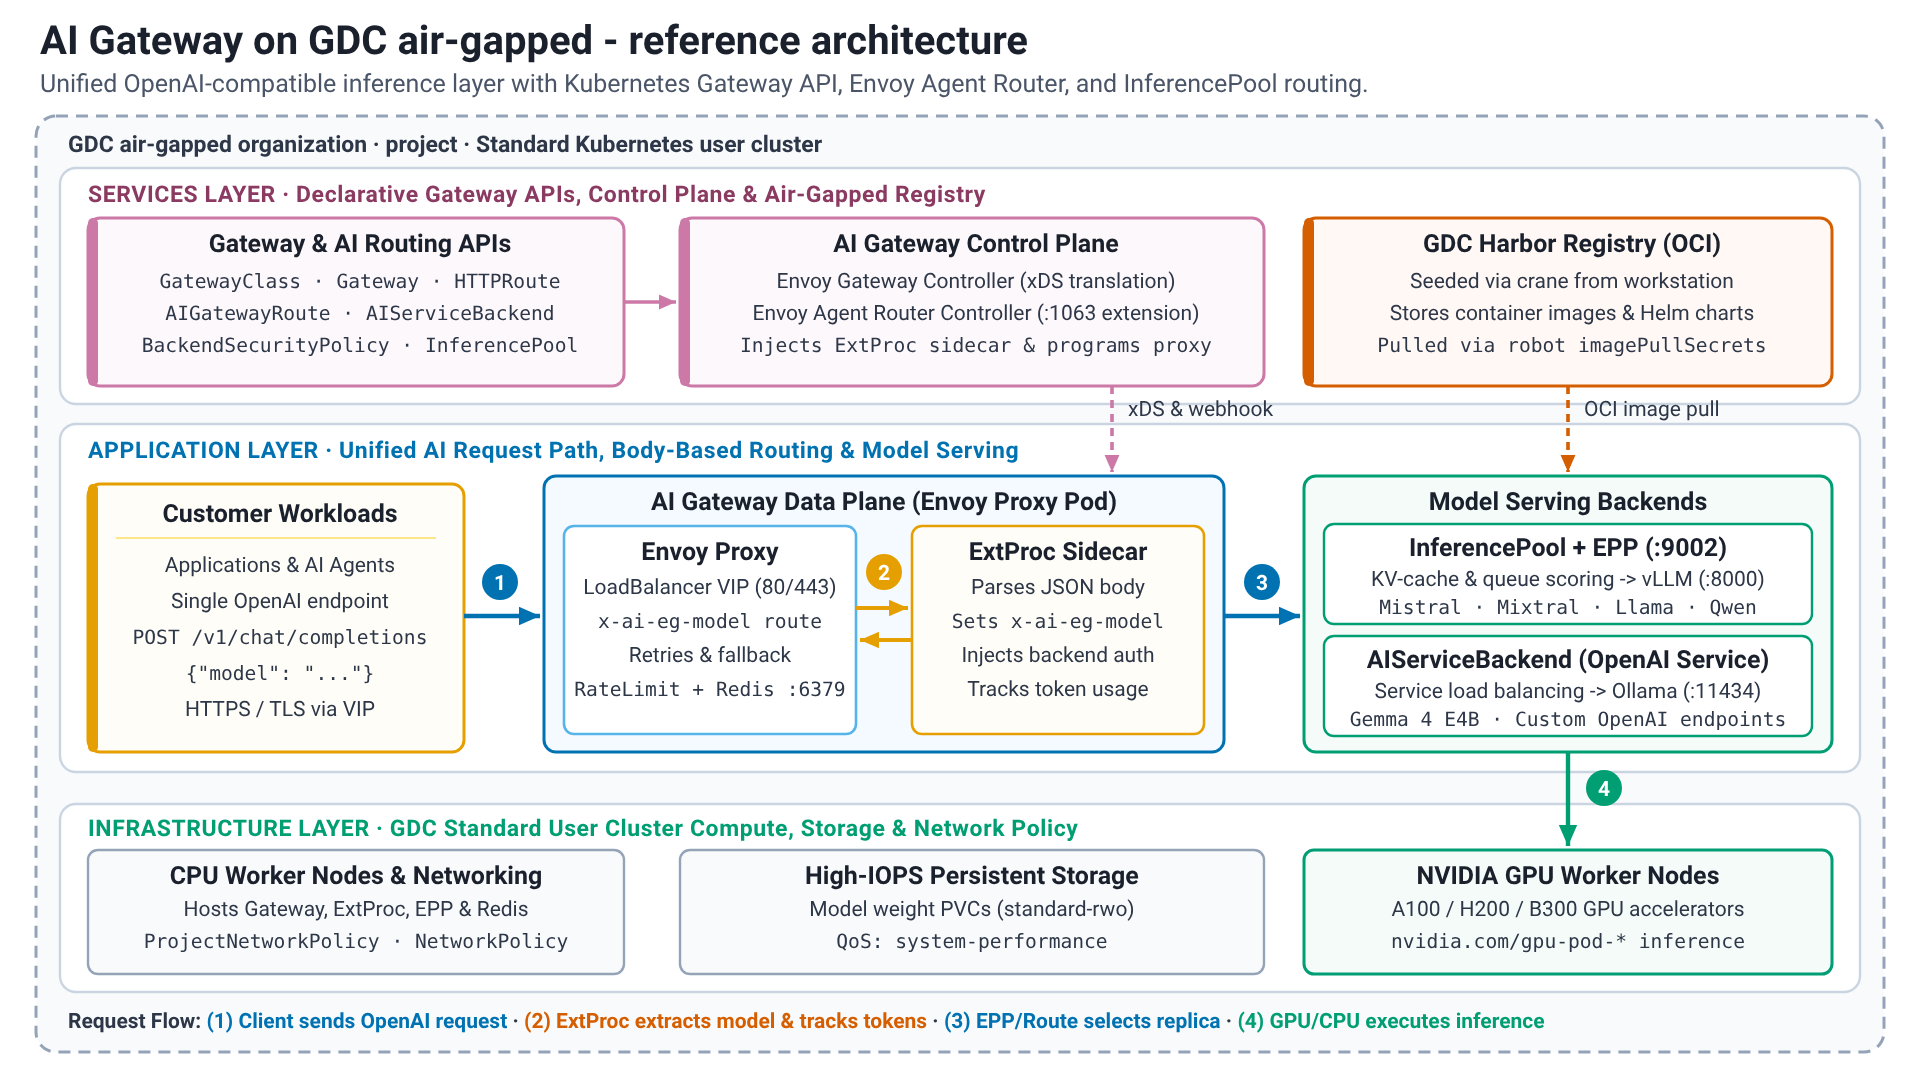
ソリューション コンポーネント
このソリューションでは、次のコンポーネントを使用します。
| ソリューション コンポーネント | 責任 | データフロー | インターフェース |
|---|---|---|---|
| Kubernetes Gateway API | Ingress とルーティング用の標準的なロール指向のリソースモデル: GatewayClass(プラットフォームが所有)、Gateway(リスナー、TLS)、ルートリソース(アプリケーション チームが所有)。ベンダー固有のアノテーションのない Ingress API の後継。 |
宣言型構成のみ。リソースはコントローラによって監視され、リクエスト トラフィックは発生しません。 | Kubernetes API(gateway.networking.k8s.io/v1)。CRD は Envoy Gateway CRD チャートからインストールされます。 |
| Envoy Gateway コントローラ(コントロール プレーン) | Gateway API を実装します。Gateway ごとに 1 つの Envoy プロキシ Deployment と LoadBalancer Service をプロビジョニングし、ルートとポリシー(BackendTrafficPolicy、SecurityPolicy、EnvoyExtensionPolicy、Backend、EnvoyProxy)を xDS 構成に変換します。構成されている場合はグローバル レート制限サービスを実行し、拡張機能マネージャーを介して Envoy Agent Router 拡張機能サーバーを呼び出して、InferencePool バックエンドが変換に追加されるようにします。 |
Kubernetes API を監視し、xDS 構成をプロキシに push します。リクエスト トラフィックはありません。 | Kubernetes API(watch)、プロキシへの xDS gRPC、拡張サーバー(ポート 1063)への gRPC。 |
| Envoy Agent Router コントローラ(コントロール プレーン) | aigateway.envoyproxy.io/v1beta1 リソース、AIGatewayRoute(抽出されたモデル名のルーティング ルール)、AIServiceBackend(API スキーマを含むバックエンド)、BackendSecurityPolicy(アップストリーム認証情報)、GatewayConfig(Gateway ごとの外部プロセッサ設定)を Envoy Gateway リソースに調整し、外部プロセッサ サイドカーを Envoy プロキシ Pod に挿入して、Envoy Gateway で使用される拡張サーバーを提供します。 |
構成のみ。 | Kubernetes API、gRPC 拡張サーバー(ポート 1063)、サイドカー インジェクション用の変更アドミッション Webhook。 |
| Envoy プロキシ(データプレーン) | リクエスト エントリ ポイント: TLS を終端し、リスナーとルートを照合し、バックエンド エンドポイント間でロード バランシングを行い、レート制限とタイムアウトを適用し、再試行して代替バックエンドにフォールバックし、アクセスログと指標を出力します。 | LoadBalancer VIP(80/443)でクライアント リクエストを受信し、AI リクエストごとに外部プロセッサに問い合わせ、選択されたバックエンド エンドポイント(エンドポイント ピッカーによって選択された Service または Pod)にリクエストを転送し、レスポンスをクライアントにストリーミングします。 |
クライアントへの HTTP/HTTPS(OpenAI 互換 API)、サイドカーとエンドポイント ピッカーへの ext_proc gRPC、バックエンドへの HTTP、レート制限サービスへの gRPC。 |
| Envoy Agent Router 外部プロセッサ(ExtProc) | OpenAI 互換のリクエスト本文を解析し、model フィールドをルーティング ヘッダー x-ai-eg-model に抽出し、モデル名のオーバーライドを適用し、クライアント API スキーマとバックエンド API スキーマの間でリクエストとレスポンスのペイロードを変換し、BackendSecurityPolicy で定義されたアップストリーム認証情報を挿入し、レスポンスからトークンの使用量(入力、出力、合計)を抽出して、トークンベースのレート制限と指標に使用される動的メタデータに変換します。 |
Envoy プロキシ Pod のサイドカー コンテナ。ストリーミング レスポンスを含むリクエストとレスポンスの本文を処理します。 |
Envoy ext_proc gRPC、Prometheus 指標エンドポイント。 |
| Gateway API Inference Extension(InferencePool + エンドポイント ピッカー) | InferencePool(inference.networking.k8s.io/v1)は、1 つのモデルサーバー デプロイの Pod(ラベルセレクタ、ターゲット ポート(8000 など))をグループ化し、そのエンドポイント ピッカー(EPP)を参照します。InferenceObjective(v1alpha2)は、モデルまたは目標ごとに優先度を割り当てます。EPP は、モデルサーバーの指標(リクエスト キューの深さ、KV キャッシュ使用率、読み込まれた LoRA アダプタ)をスクレイピングし、リクエストごとにエンドポイントを選択します。 |
プロキシは、リクエスト ヘッダーを使用して EPP(ext_proc、ポート 9002)を呼び出します。EPP は、使用するエンドポイントを返します。プロキシは、その Pod にリクエストを転送します。 |
Kubernetes API(CRD)、gRPC ext_proc(9002)、モデルサーバーの Prometheus スクレイピング。 |
| Redis(省略可) | Envoy レート制限サービスのバッキング ストア: すべてのプロキシ レプリカにわたるリクエストベースとトークンベースの制限の共有カウンタ。グローバル レート制限が構成されている場合にのみ必要です。 | レート制限サービスは、制限されたリクエストごとにポート 6379 のカウンタを読み取り、インクリメントします。 | Redis プロトコル(6379)。クラスタにデプロイされた Redis 8.10、または既存の Redis インスタンス。 |
| モデル提供バックエンド(Ollama / vLLM) | ゲートウェイの背後でオープンウェイト モデルを提供します。これは、コンパニオン ガイド「GDC エアギャップでオープンウェイト モデルを設定する」でデプロイされます。AIServiceBackend(Ollama などの OpenAI 互換の Service)または InferencePool(エンドポイント ピッカーがスコア付けする指標を公開する vLLM などのモデルサーバー)として接続されます。 |
プロキシからルーティングされたリクエストを受信し、GPU ノード(または小規模なモデルを使用した機能評価用の CPU)で推論を実行して、OpenAI 互換のレスポンスを返します。 | OpenAI 互換の REST API: ポート 8000 の vLLM、ポート 11434 の Ollama、エンドポイント ピッカーの Prometheus 指標(vLLM)。 |
| Harbor | コンテナ イメージ(Envoy プロキシ、Envoy Gateway、Envoy Agent Router コントローラと外部プロセッサ、レート制限サービス、エンドポイント ピッカー、Redis)とソリューションの Helm チャート(OCI アーティファクト)を保存します。 | アーティファクトは、インターネット アクセスが可能なワークステーションから seed_registry.sh(crane)を使用して、公開レジストリから Harbor にコピーされます。クラスタは、イメージ pull シークレットを介してロボット アカウントを使用してイメージを pull し、チャートは helm template を使用して Harbor からレンダリングされます。 |
OCI Distribution API、Harbor UI、ロボット アカウント。 |
| Standard クラスタと GPU ノード | すべてのゲートウェイ コンポーネント(CPU ノードで十分)と推論 Pod(ノードから検出されたアクセラレータ リソースを持つ GPU ノード)をホストします。LoadBalancer VIP、モデルの重みの永続ストレージ、ネットワーク ポリシーの適用を提供します。 |
基盤プラットフォーム。リクエストは Gateway の LoadBalancer VIP を介して入り、クラスタ ネットワーク内にとどまります。 |
Kubernetes API、GDC ネットワーキング API(networking.gdc.goog/v1 ProjectNetworkPolicy)、GDC コンソール、プラットフォーム管理者用の gdcloud。 |
特長と機能
このリファレンス アーキテクチャには、次のコア機能が用意されています。
- 統合された OpenAI 互換エンドポイント: アプリケーションは、ゲートウェイの背後でモデル提供されるモデルごとに 1 つのアドレス(
/v1/chat/completions、/v1/models、…)を呼び出します。- コンポーネント:
Gateway、AIGatewayRoute、Envoy プロキシ、外部プロセッサ。 - 責任: 安定した仮想 IP の公開、TLS の終了、OpenAI 互換のリクエスト形式の受け入れ、必要に応じたバックエンド スキーマへの変換。
- インターフェース: HTTPS REST(JSON、ストリーミング用のサーバー送信イベントを含む)。
- コンポーネント:
- 本文ベース(モデル対応)ルーティング: ゲートウェイはリクエスト本文の
modelフィールドを読み取り、クライアントサイドのエンドポイント ロジックなしで、一致するバックエンドにリクエストをルーティングします。- コンポーネント: 外部プロセッサ、
x-ai-eg-model、AIServiceBackend、InferencePoolに一致するAIGatewayRouteルール。 - 責任: モデル名の抽出、ルートルールの照合、モデル名の変更(
modelNameOverride)、重みによるトラフィックの分割、優先度による代替バックエンドへのフォールバック。 - インターフェース: Kubernetes API(
aigateway.envoyproxy.io/v1beta1)。
- コンポーネント: 外部プロセッサ、
- モデルサーバー対応のロード バランシング:
InferencePoolへのリクエストは、ラウンドロビンではなく、キューが最も短く、最も有用な KV キャッシュを持つレプリカに送信されます。- コンポーネント: Gateway API Inference Extension(
InferencePool、InferenceObjective、エンドポイント ピッカー)。 - 責任: モデルサーバー指標のスクレイピング、エンドポイントのスコアリング(キューの深さ、KV キャッシュ使用率、プレフィックス キャッシュ アフィニティ、LoRA アダプタ)、負荷時の目標ごとの優先度の遵守。
- インターフェース: Kubernetes API(
inference.networking.k8s.io/v1、inference.networking.x-k8s.io/v1alpha2)、ext_proc gRPC(9002)。
- コンポーネント: Gateway API Inference Extension(
- アップストリームの認証とセキュリティ ポリシー: 認証情報を必要とするバックエンドの認証情報は、ゲートウェイによって挿入され、アプリケーションに配布されることはありません。
- コンポーネント:
BackendSecurityPolicy、Envoy GatewaySecurityPolicy、TLS リスナー。 - 責任: バックエンドに API キーを挿入する、
Gatewayでクライアント TLS を終了する、必要に応じてクライアント認証と認可ポリシーを適用する。 - インターフェース: ポリシーによって参照される Kubernetes
Secret。
- コンポーネント:
- トークンベースのレート制限(省略可): 使用量は、リクエストだけでなくトークンでも測定されます。
- コンポーネント: 外部プロセッサ(
llmRequestCosts)、Envoy GatewayBackendTrafficPolicy(グローバル レート制限)、レート制限サービス、Redis。 - 責任: すべてのレスポンスから入力トークン、出力トークン、合計トークンを抽出し、リクエスト費用として添付します。すべてのプロキシ レプリカで、コンシューマごとまたはモデルごとの予算を適用します。
- インターフェース: Kubernetes API、Redis(6379)。
- コンポーネント: 外部プロセッサ(
- トラフィック管理: 標準の Gateway API 機能が AI トラフィックに適用されます。
- コンポーネント:
Gateway、HTTPRoute、AIGatewayRoute、BackendTrafficPolicy。 - 責任: ホスト、パス、ヘッダーベースのマッチング、長い生成に適したタイムアウト、再試行、重み付けされたトラフィック分割、バックエンド間の優先度ベースのフォールバック。
- インターフェース: Kubernetes API。
- コンポーネント:
- オブザーバビリティ: リクエスト、レイテンシ、トークンの指標は、すべてのモデルで使用できます。
- コンポーネント: Envoy プロキシのアクセスログと統計情報、外部プロセッサの指標(トークンの使用量、リクエストの所要時間、最初のトークンまでの時間)、エンドポイント ピッカーの指標。
- 責任: GDC オブザーバビリティ スタックまたはお客様が管理する Prometheus がスクレイピングできる Prometheus 形式の指標と構造化アクセスログを公開します。
- インターフェース: Prometheus 指標エンドポイント、標準出力ログ。
- エアギャップのあるアーティファクト管理: すべてのイメージとグラフは、インストール前に Harbor でステージングされます。
- コンポーネント: Harbor、
seed_registry.sh、ロボット アカウント、イメージ pull シークレット、EnvoyProxyリソース(プロキシ イメージと pull シークレット)。 - 責任: 接続されたワークステーションからイメージと OCI Helm チャートをシードする、バージョンを固定する、
helm templateを使用してチャートをオフラインでレンダリングする。 - インターフェース: OCI Distribution API、Kubernetes API。
- コンポーネント: Harbor、
アーキテクチャの原則
- 標準ファースト: ゲートウェイは Kubernetes Gateway API とその推論拡張機能を使用して構成され、アプリケーションに対して OpenAI 互換の API を使用します。これにより、アプリケーション、ルート、バックエンドはゲートウェイ実装間でポータブルな状態を維持できます。
- セキュリティ ファースト: すべてのコンポーネントとデータは GDC エアギャップ境界内にあります。TLS は
Gatewayで終端し、バックエンド認証情報はゲートウェイによって挿入され、ネットワーク アクセスはNetworkPolicyオブジェクトとProjectNetworkPolicyオブジェクトによって制限されます。 - データ主権: プロンプト、レスポンス、モデルの重み、使用状況データがお客様の GDC 組織外に流出することはありません。運用に外部接続は必要ありません。
- 関心の分離: ロール指向の Gateway API を使用すると、プラットフォーム管理者は
GatewayClass、Gateway、TLS、ネットワーク ポリシーを所有し、アプリケーション チームは独自の名前空間でAIGatewayRoute、AIServiceBackend、InferencePoolリソースを所有できます。 - 分離されたコントロール プレーンとデータプレーン: コントローラは構成の変換のみを行います。リクエストパスは、Envoy プロキシ、その外部プロセッサ サイドカー、エンドポイント ピッカーで構成されます。これらは、コントローラが再起動してもトラフィックの処理を継続します。
- オープンかつ柔軟: このアーキテクチャでは、オープンソース ソフトウェア(Envoy Gateway、Envoy Agent Router、Gateway API Inference Extension、Ollama、vLLM)が全体で使用されています。同じ Gateway API リソースを代替実装で提供することもできます。
- スケーラビリティとパフォーマンス: データプレーンは、プロキシ レプリカを追加することで水平方向にスケーリングし、CPU とメモリを調整することで垂直方向にスケーリングします。モデルサーバー対応のロード バランシングにより、個々のレプリカに過負荷をかけることなく GPU を飽和状態に保ちます。
- エンドユーザー エクスペリエンスの簡素化: モデルごとに 1 つのエンドポイント、1 つの API 形式、1 つの認証情報を使用することで、モデルのデプロイから使用までのパスを短縮できます。
- 復元性: Kubernetes のヘルスチェックとレプリケーション、Envoy の再試行、バックエンド間の優先度ベースのフォールバックにより、個々のモデルレプリカが失敗した場合でもエンドポイントが使用可能な状態を維持します。
考慮事項
- スケーラビリティとパフォーマンス:
- ゲートウェイ コンポーネントは CPU のみのワークロードです。
Gatewayの Envoy プロキシDeploymentは、レプリカ数(EnvoyProxyリソース)を増やすことで水平方向にスケーリングし、CPU とメモリのリクエストを増やすことで垂直方向にスケーリングします。外部プロセッサによる本文の検査では、リクエストとレスポンスのサイズに比例して CPU が消費されます。ストリーミングされたレスポンスは、段階的に処理されます。 - モデルサーバー対応のロード バランシングは、
InferencePoolとして接続されたバックエンドにのみ適用されます。AIServiceBackendとして接続されたバックエンドは、プロキシによってServiceのエンドポイント間でロード バランシングされます。 - ゲートウェイは GPU 容量を追加しません。スループットとレイテンシはモデルサーバーによって制限されます。コンパニオン ガイドセット(高スループット用の vLLM、使いやすさと CPU のみの評価用の Ollama)を使用して、モデルのデプロイのサイズを設定します。
- 長い生成には、一般的な HTTP API よりも長いリクエスト タイムアウトとアイドル タイムアウトが必要です。クライアントではなく、ルートとポリシーで構成します。
- ゲートウェイ コンポーネントは CPU のみのワークロードです。
- リソース管理:
- すべてのゲートウェイ コンポーネントは CPU ノードで実行され、アクセラレータは必要ありません。次の表に、機能的なデプロイの目安となるサイズを示します。リファレンス実装では、正確なリクエストと上限が設定されます。本番環境の値は、リクエスト率とペイロード サイズによって異なります。
- 次のポートテーブルに、ネットワーク ポリシーで許可する必要があるすべてのポートを示します。
- GPU の計画はモデルのデプロイに属します。アクセラレータ リソース名は、コンパニオン ガイドセットで説明されているように、ノードから検出されます。
ゲートウェイ コンポーネントの目安となるサイズ(CPU のみ)
| コンポーネント | レプリカ | CPU(リクエスト) | メモリ(リクエスト) | メモ |
|---|---|---|---|---|
| Envoy Gateway コントローラ | 1 | 1 億~ 5 億 | 256Mi ~ 1Gi | コントロール プレーン。リクエストパスには含まれません |
| Envoy Agent Router コントローラ | 1 | 1 億~ 5 億 | 256Mi ~ 512Mi | コントロール プレーンと拡張機能サーバー |
Envoy プロキシ Pod(プロキシ + 外部プロセッサ サイドカー) |
1 ~ 2/Gateway |
500m–2 | 512Mi ~ 2Gi | リクエスト率とペイロード サイズに応じてスケーリングする |
| エンドポイント ピッカー | InferencePool あたり 1 |
1 億~ 5 億 | 256Mi ~ 512Mi | モデルサーバーの指標をスクレイピングする |
| レート制限サービス(省略可) | 1 | 1 億~ 5 億 | 256Mi ~ 512Mi | グローバル レート制限のみ |
| Redis(省略可) | 1 | 1 億~ 5 億 | 256Mi ~ 1Gi | グローバル レート制限のみ |
ネットワーク ポート
| ポート | コンポーネント | 目的 |
|---|---|---|
| 80 / 443 | Envoy プロキシ(Gateway 個のリスナー) |
LoadBalancer VIP の HTTP / HTTPS エントリ ポイント |
| 1063 | Envoy Agent Router コントローラ(拡張サーバー) | Envoy Gateway 拡張機能マネージャーからの gRPC 呼び出し |
| 9002 | エンドポイント ピッカー | Envoy プロキシからの ext_proc gRPC 呼び出し |
| 6379 | Redis | レート制限カウンタ |
| 8000 | vLLM | OpenAI 互換 API とモデルサーバーの指標 |
| 11434 | Ollama | モデルサーバーの Ollama および OpenAI 互換 API |
- 可用性と信頼性:
- プロキシと外部プロセッサは同じ
Podで実行されます。LoadBalancerServiceの背後にある複数のレプリカが個々のPodの障害をマスクし、コントローラはトラフィックを中断することなく再起動できます。 AIGatewayRouteルールでは、バックエンドが正常でない場合にゲートウェイが別のレプリカセットまたはモデルサーバーにフォールバックするように、優先度付きの複数のバックエンドを一覧表示できます。- エンドポイント ピッカーはプールごとの
Deploymentです。エンドポイント ピッカーが使用できない場合、そのInferencePoolへのリクエストは、エンドポイント ピッカーが復旧するまで失敗します。リソース リクエストと readiness プローブを使用して実行し、データプレーン コンポーネントのようにモニタリングします。 - Redis はレート制限カウンタのみを保持します。Redis の停止は、ルーティングではなくレート制限に影響します。
- プロキシと外部プロセッサは同じ
- 運用の複雑さ:
- Envoy Gateway、Envoy Agent Router、Gateway API Inference Extension のバージョンを調整: テスト済みの組み合わせ(Envoy Gateway 1.8.4、Envoy Agent Router 1.1.0、Gateway API Inference Extension 1.5.0)で 3 つをアップグレードします。
- エアギャップ ライフサイクル: アップグレードごとに、すべてのイメージとチャートが Harbor に再シードされます。
EnvoyProxyリソースとチャートの値は、レジストリと pull シークレットを固定します。 - 2 つの構成レイヤ: プラットフォーム所有の
GatewayClass/Gateway/EnvoyProxyとチーム所有のAIGatewayRoute/AIServiceBackend/InferencePool。新しいモデルをオンボーディングするということは、新しいゲートウェイではなく、ルートルールとバックエンドを追加することを意味します。 - モニタリング: リクエスト率、レイテンシ(最初のトークンまでの時間を含む)、モデルごとおよびコンシューマごとのトークン使用量、エンドポイント ピッカーのスコア、モデルサーバーの GPU 使用率。
InferenceObjectiveはまだアルファ版 API(v1alpha2)です。Inference Extension のリリース間でスキーマが変更される可能性があります。
- セキュリティとコンプライアンス:
- ソリューション全体が GDC エアギャップ セキュリティ境界内で動作します。
- ネットワーク ポリシーは必須です。名前空間
NetworkPolicyは、プロキシからモデルサーバー ポート(8000、11434)とエンドポイント ピッカー(9002)へのトラフィックを許可します。ProjectNetworkPolicyは、コンシューマがプロジェクトの外部に存在する場合に、LoadBalancerVIP へのクライアント トラフィックを許可します。 - TLS は、Kubernetes
Secretに保存されている証明書を使用してGatewayで終端します。クライアントにはゲートウェイ エンドポイントのみが表示されます。 - アップストリーム認証情報(モデルサーバーに必要な API キーなど)は、
BackendSecurityPolicyによって参照され、ゲートウェイによって挿入されるSecretに保存されます。そのため、アプリケーションがバックエンド認証情報を保持することはありません。 - トークンベースのレート制限により、コンシューマごとまたはモデルごとに高価な GPU 容量の消費が制限されます。
- Harbor ロボット アカウントと Kubernetes イメージ pull シークレットにより、コンテナ イメージへの安全なアクセスが確保されます。ロール指向の Gateway API RBAC により、プラットフォームとアプリケーションの責任が分離されます。
設計上の意思決定
このリファレンス アーキテクチャでは、次の重要な設計上の決定が行われています。
決定 1: AI ゲートウェイの実装: Envoy Gateway 上のオープンソースの Envoy Agent Router と代替ディストリビューションの比較
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| AI ゲートウェイは、セルフマネージドのオープンソース オプションから商用サポート付きのサービスまで、実行可能な代替手段を備えた主要なアーキテクチャの選択肢です。(a)Envoy Gateway 上の Envoy Agent Router(オープンソース)、(b)kgateway と agentgateway(LLM プロバイダ トラフィック、MCP ツール、エージェント間通信を 1 つのデータプレーンで処理するオープンソースの Gateway API 実装。オプションで solo.io のベンダー サポート付き)、(c)商用サポート付きのプレミアム オプションとしての agentgateway 向け Solo Enterprise。 | リファレンス実装では、Envoy Gateway でオープンソースの Envoy Agent Router を使用します。代替手段は、同じ Gateway API リソースの背後にある有効な選択肢です。専用のベンダー サポートが必要な本番環境には、商用サポートされているディストリビューションをおすすめします。 | オープンソースの利点: 軽量で標準に準拠、高性能な L7 ルーティング、ライセンス料なし、有料サービスにコミットする前にソリューションを評価するのに最適。Envoy Agent Router は、このガイドセットで検証されているオプションです。オープンソースのデメリット: サポートはソリューション チームによるベスト エフォートであり、コミュニティ主導であるため、コアな本番環境には適さない可能性があります。プレミアムのメリット: ゲートウェイ ライフサイクルのエンタープライズ サポート契約と、多くの場合、高度なエージェント機能。プレミアムのデメリット: 有料のライセンスまたはサポート契約、追加のベンダー関係。 |
決定 2: 推論拡張機能を使用した Kubernetes Gateway API と、Ingress または独自の Gateway API の比較
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| 推論エンドポイントは、以前の Ingress API、ゲートウェイ固有の構成形式、または Kubernetes Gateway API を使用して公開できます。モデル認識ロード バランシングでは、モデルサーバー プールとその優先度を記述する方法も必要です。 | このソリューションは、Envoy Gateway によって実装された Kubernetes Gateway API(GatewayClass、Gateway、ルート)と、モデル対応ルーティング用の Gateway API Inference Extension(InferencePool、InferenceObjective、エンドポイント ピッカー)で標準化されています。 |
Gateway API は、Ingress の後継となる Kubernetes 標準であり、ロール指向(プラットフォーム チームとアプリケーション チーム)で、実装間でポータブルです。Inference Extension は、モデルサーバー対応ルーティング(キューの深さ、KV キャッシュ、優先度)のコミュニティ標準であり、Envoy Agent Router でそのままサポートされています。代替のゲートウェイ ディストリビューションは同じ API を実装しているため、決定 1 は可逆的なままです。 |
決定 3: 統合エンドポイントとして OpenAI 互換リクエストの model フィールドで本文ベースのルーティングを行う
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
アプリケーションは、モデルごとに 1 つのエンドポイント(ホストベースまたはパスベース)、クライアントによって設定されたカスタム ヘッダー、またはすべての OpenAI 互換リクエストにすでに含まれている model フィールドを介してモデルをアドレス指定できます。 |
ゲートウェイは、1 つの OpenAI 互換エンドポイントを公開し、model フィールドでルーティングします。外部プロセッサは、これを x-ai-eg-model ヘッダーに抽出し、AIGatewayRoute ルールがそのヘッダーと一致します。 |
既存の OpenAI 互換クライアントと SDK は変更なしで動作し、1 つの文字列を変更するだけでモデルを切り替えることができます。エンドポイント、認証情報、モデルの配置は、アプリケーションに触れることなく変更できます。同じルールで、トラフィック分割、フォールバック、モデル名のオーバーライドのために、モデル名を複数のバックエンドにマッピングできます。 |
決定 4: Harbor へのエアギャップ アーティファクトのシーディングとオンデマンド pull
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| アップストリーム インストールでは、コンテナ イメージがパブリック レジストリから pull され、Helm チャートが OCI アーティファクトとしてオンデマンドで pull されます。これは、エアギャップ環境では不可能です。 | すべてのコンテナ イメージ(Envoy プロキシ、Envoy Gateway、Envoy Agent Router コントローラと外部プロセッサ、レート制限サービス、エンドポイント ピッカー、Redis)と、Envoy Gateway と Envoy Agent Router の Helm チャートは、seed_registry.sh(crane)を使用して Harbor プロジェクトにシードされます。チャートは Harbor から helm template を使用してオフラインでレンダリングされ、EnvoyProxy リソースとチャート値は Harbor レジストリと pull シークレットを固定します。 |
バージョンごとに 1 つの繰り返し可能で監査可能なシーディング ステップ。クラスタは外部接続を必要としません。バージョンを固定することで、アップグレードが明示的かつ可逆的になります。 |
決定 5: Redis を使用したオプションのトークンベースのレート制限とリクエストベースの制限のみの比較
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| GPU 容量はリクエストごとではなくトークンごとに消費されます。リクエスト数の上限を設定しても、少数の非常に大きなプロンプトや長い生成から共有モデルを保護することはできません。Envoy Gateway のグローバル レート制限には、共有カウンタ ストアが必要です。 | トークンベースのレート制限は、アーキテクチャのオプション機能です。外部プロセッサがリクエストあたりの入力トークン、出力トークン、合計トークンを記録し(llmRequestCosts)、BackendTrafficPolicy が予算を適用し、Redis インスタンス(Redis 8.10、クラスタまたは既存のインスタンスにデプロイ)がカウンタを保存します。レート制限のないデプロイでは、Redis は必要ありません。 |
使用量は費用を反映する単位で測定され、予算はすべてのプロキシ レプリカに一貫して適用されます。依存関係の費用は、割り当てを必要とするお客様のみが支払います。 |
決定 6: トポロジ: 標準クラスタの専用 Namespace 内のゲートウェイ コントロール プレーンとデータプレーン、アプリケーション Namespace 内のモデル
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| ゲートウェイは、専用クラスタ、すべてのアプリケーション名前空間、または標準クラスタごとに 1 回、フロントエンドとなるモデルの横で実行できます。GDC エアギャップのオープンウェイト モデルは、標準クラスタ(コンパニオン ガイドセット)にデプロイされます。 | Envoy Gateway と Envoy Agent Router のコントロール プレーン、および Envoy プロキシのデータプレーンは、モデルをホストする標準クラスタの専用の名前空間で実行されます。AIGatewayRoute、AIServiceBackend、InferencePool、およびモデルのデプロイは、アプリケーションの名前空間に存在し、名前空間をまたいで参照されます。 |
リクエストはプロキシとモデル Pod 間のクラスタ ネットワーク内に留まり(レイテンシが最も低く、追加のロードバランサは不要)、プラットフォーム管理者がゲートウェイの名前空間を所有し、アプリケーション チームがルートとモデルを所有します。また、エンドポイント ピッカーはモデルサーバーを直接スクレイピングできます。中央サーバー ゲートウェイに転送するプロジェクトごとのクライアント ゲートウェイは、マルチプロジェクトで使用するためのこのトポロジの拡張機能として残ります。 |
前提条件と制限事項
- GDC エアギャップ 1.16.2-hf1 以降の環境は、Kubernetes v1.32.13-gke.400 以降を実行する標準クラスタで使用できます。
- モデル提供バックエンドに十分なハードウェア リソース(特に GPU)が存在する。ゲートウェイ コンポーネント自体は CPU ノードで実行されます。実際のモデルには GPU が必要です。Ollama の小規模なモデルは、機能評価のみを目的として CPU で実行できます。
- Harbor インスタンスが設定され、アクセス可能である。また、インターネット アクセスと GDC 環境(Harbor API と Kubernetes API)への接続を備えたワークステーションが、イメージとチャートのシードに使用できる。
- ユーザーに必要な権限がある: プロジェクト ロール Harbor Instance Viewer と Standard Cluster Admin、およびクラスタ スコープのインストール(CRD、
GatewayClass、名前空間)用の標準クラスタのcluster-adminロールに対するStandardClusterRoleBinding。リファレンス実装をご覧ください。 - モデル提供バックエンドは OpenAI 互換の API を公開します。
InferencePoolとして接続されたバックエンドは、エンドポイント ピッカーが依存する vLLM 互換の指標も公開します。 - 制限事項: オープンソース コンポーネント(Envoy Gateway、Envoy Agent Router、Gateway API Inference Extension)のサポートは、ソリューション チームによるベスト エフォートです。専用のベンダー サポートには、商用サポート対象のディストリビューションが必要です(決定 1)。
- 制限事項:
InferenceObjectiveはアルファ版 API(inference.networking.x-k8s.io/v1alpha2)であり、Inference Extension のリリース間で変更される可能性があります。 - 制限事項: プロジェクト外のコンシューマには、
GatewayのLoadBalancerVIP とProjectNetworkPolicyが必要です。プロジェクト内では、クラスタ内クライアントまたはkubectl port-forwardがゲートウェイServiceに直接アクセスできます。 - 制限事項: GDC の Gemini、モデルのファインチューニング、LLM 以外の生成 AI モデル、マルチノード モデル提供は、このバージョンのソリューションの対象外です。
ユーザーフロー
以下は、GDC エアギャップの AI ゲートウェイの包括的なユーザーフローです。まず、アプリケーション デベロッパーが依存するリクエストパス、次にプラットフォーム管理者が従う設定パスです。
1. デベロッパーのリクエストパス
アプリケーションまたはエージェントに必要なのは、ゲートウェイ エンドポイント、クライアント認証情報(ゲートウェイが適用する場合)、モデル名のみです。
- リクエストを送信する: アプリケーションは、OpenAI 互換サービスを呼び出す場合とまったく同じように、モデル(
"model": "gemma"など)を指定する OpenAI 互換の JSON 本文を使用して、ゲートウェイ エンドポイントでPOST /v1/chat/completionsを呼び出します。 - ゲートウェイに入る: リクエストが
GatewayのLoadBalancerVIP に到達します。Envoy プロキシが TLS を終端し、リスナーとルートを照合します。 - 本文を処理する: プロキシはリクエストを Envoy Agent Router 外部プロセッサに渡します。このプロセッサは本文を解析し、モデル名を
x-ai-eg-modelヘッダーに抽出し、ペイロードが異なる場合はバックエンド スキーマに変換します。 - バックエンドを選択する: モデル名に一致する
AIGatewayRouteルールは、AIServiceBackend(OllamaServiceなど)またはInferencePool(vLLM レプリカセットなど)を選択します。InferencePoolの場合、エンドポイント ピッカーは、キューが最も短く、KV キャッシュの一致が最も良好なレプリカを選択します。 - 転送と応答:
BackendSecurityPolicyが適用されると、プロキシはアップストリーム認証情報を挿入し、選択したPodにリクエストを転送します。レスポンスをストリーミングして、外部プロセッサがトークンの使用状況を記録できるようにします。これにより、指標がフィードされ、構成されている場合はトークンベースのレート制限が適用されます。 - モデルを切り替える: 別のモデルを使用するには、デベロッパーが
model文字列を変更します。新しいエンドポイント、認証情報、クライアント ライブラリは必要ありません。
2. プラットフォーム管理者の設定パス
- アーティファクトを Harbor にシードする: Harbor ロボット アカウントを作成し、インターネット アクセスが可能なワークステーションから
seed_registry.shを使用して、コンテナ イメージ、Envoy Gateway、Envoy Agent Router の Helm チャートを Harbor にコピーします。 - Envoy Gateway をインストールする:
helm templateを使用して Harbor から CRD とコントローラ チャートをレンダリングし、ゲートウェイの名前空間に適用します。プロキシ イメージと pull シークレットを固定するEnvoyProxyリソースを作成し、基本的なGatewayClass、Gateway、HTTPRouteを使用してコントローラを確認します。 - Envoy Agent Router をインストールする: Envoy Agent Router CRD と Gateway API Inference Extension CRD をインストールし、Envoy Agent Router コントローラをデプロイします。また、拡張サーバー(ポート 1063)を呼び出し、
InferencePoolバックエンドを受け入れるように Envoy Gateway を再構成します。必要に応じて、Redis をデプロイし、グローバル レート制限サービスを有効にします。 - ゲートウェイを公開する: HTTP リスナーと HTTPS リスナー(TLS 証明書
Secret)を使用してGatewayClassとGatewayを作成し、LoadBalancerVIP を待機して、プロジェクト外のコンシューマにProjectNetworkPolicyを適用します。 - モデルをアタッチする: コンパニオン ガイドセットを使用してモデル提供バックエンドをデプロイし、OpenAI 互換の
ServiceとInferencePoolのAIServiceBackendリソースと、vLLM 互換のレプリカセットの Endpoint Picker リソースを、名前空間NetworkPolicyオブジェクトとともに作成します。 - ルートを公開する: モデル名ごとに 1 つのルール(本文ベースのルーティング)を含む
AIGatewayRouteを作成します。必要に応じて、アップストリーム認証情報とトークン予算のBackendSecurityPolicyオブジェクトとBackendTrafficPolicyオブジェクトを作成します。 - 検証と運用: VIP(または
kubectl port-forwardフォールバック)を介して/v1/modelsと/v1/chat/completionsを呼び出し、プロキシ、外部プロセッサ、エンドポイント ピッカーの指標を確認して、エンドポイント名とモデル名をアプリケーション チームに渡します。プロキシ レプリカとモデルのデプロイを個別にスケーリングします。Envoy Gateway、Envoy Agent Router、Inference Extension を一緒にアップグレードします。
詳細な手順については、Envoy Agent Router のリファレンス実装と Envoy Agent Router を使用した本文ベースのルーティングのユーザーガイドをご覧ください。
その他の教材
- Envoy Agent Router のリファレンス実装
- Envoy Agent Router を使用した本文ベースのルーティングのユーザーガイド
- オープンウェイト LLM のリファレンス アーキテクチャ
- Envoy Agent Router のドキュメント
- Envoy Gateway
- Kubernetes Gateway API
- Gateway API Inference Extension
- Google Distributed Cloud エアギャップのドキュメント