


Planteamiento del problema
Las organizaciones que ejecutan modelos de lenguaje grandes (LLM) en entornos aislados
acumulan rápidamente extremos de modelos: cada modelo de ponderación abierta que se entrega en
Google Distributed Cloud (GDC) aislado (consulta el conjunto de guías complementarias Modelos de ponderación abierta
en GDC aislado) expone su propio Service de Kubernetes,
su propia dirección, sus propias credenciales y su propio ciclo de vida operativo.
Los desarrolladores de aplicaciones y agentes terminan en silos arquitectónicos, con un extremo hard-coded por modelo y reescribiendo integraciones con cada iteración del modelo. Esta
fragmentación genera deuda técnica y ralentiza la implementación de
cargas de trabajo de agentes de varios pasos y de misión crítica.
Las capas de red estándar también son "ciegas a la IA": un balanceador de cargas convencional
trata el tráfico de inferencia como HTTP genérico y no puede leer el campo model de una
solicitud, priorizar las cargas de trabajo sensibles a la latencia, tener en cuenta los tokens en lugar de
las solicitudes ni dirigir una solicitud a la réplica del servidor de modelos que ya contiene la
caché de KV relevante. En los clústeres de GPU aislados de alto costo, esto genera una infrautilización del hardware
y un retorno de la inversión deficiente. Si bien Gemini en
GDC
proporciona modelos de frontera administrados, los clientes que los combinan con modelos de pesos abiertos
autohospedados
necesitan una capa de inferencia que ofrezca agilidad similar a la de la nube
sin comprometer la soberanía de los datos: ninguna solicitud, instrucción ni peso del modelo puede
salir del límite de GDC.
Solución propuesta
En este documento, se describe la arquitectura de referencia para una puerta de enlace de IA autoadministrada
en GDC aislado: una capa de inferencia segura y centralizada
que proporciona a las aplicaciones un extremo compatible con OpenAI para todos los modelos y enruta
cada solicitud al backend correcto. La implementación de referencia se basa en la API de Gateway de Kubernetes: Envoy Gateway es la implementación de la API de Gateway (plano de control y plano de datos del proxy de Envoy) y Envoy Agent Router (antes Envoy AI Gateway) la extiende con el procesamiento de solicitudes específico de la IA: extracción de modelos del cuerpo de la solicitud, traducción de solicitudes y respuestas, autenticación ascendente, contabilización de tokens y, de forma opcional, límite de frecuencia basado en tokens. La extensión de inferencia de la API de Gateway agrega una selección de extremos que reconoce el servidor de modelos (InferencePool
y el selector de extremos) para que la capacidad de la GPU se use de manera eficiente. Todos los artefactos se
almacenan en etapa de pruebas en el registro de Harbor de la organización de GDC,
y toda la pila se ejecuta en un clúster estándar sin conectividad
externa.
Qué se incluye: Esta arquitectura abarca la implementación de Envoy Gateway
y Envoy Agent Router en un clúster estándar, los recursos de la API de Gateway
(GatewayClass, Gateway) y los recursos de Envoy Agent Router (AIGatewayRoute,
AIServiceBackend, BackendSecurityPolicy, GatewayConfig) que exponen un
extremo unificado compatible con OpenAI, el enrutamiento basado en el cuerpo en el campo model, la
extensión de inferencia de la API de Gateway (InferencePool, InferenceObjective, selector de extremos)
para el balanceo de cargas adaptado al modelo, el límite de frecuencia opcional basado en tokens con
Redis, la finalización de TLS en la puerta de enlace, las políticas de red (NetworkPolicy/
ProjectNetworkPolicy) y la administración de artefactos aislados en Harbor. Los
backends de entrega de modelos detrás de la puerta de enlace (Ollama, vLLM) se implementan con el
conjunto de guías complementarias Modelos de pesos abiertos en GDC
aislado.
Qué no se incluye: Esta arquitectura no abarca un producto de puerta de enlace de IA administrada, la implementación y el ajuste de los modelos en sí (conjunto de guías complementarias), el ajuste de modelos, las modalidades de IA generativa que no son LLM, el tráfico de agente a herramienta
(MCPRoute) ni las distribuciones de puertas de enlace con asistencia comercial. Gemini en
GDC es una capacidad de producto administrada; su aprovisionamiento está
fuera del alcance y esta versión del conjunto de guías valida la puerta de enlace con
modelos de pesos abiertos alojados de forma independiente.
Público: El público principal de este documento incluye a los administradores de plataformas responsables de implementar y operar la puerta de enlace en un clúster estándar y a los arquitectos técnicos que diseñan plataformas de IA dentro del entorno aislado. Los desarrolladores de aplicaciones que consumen el extremo unificado son un público secundario que se beneficia de comprender cómo se enrutan sus solicitudes.
Arquitectura
La solución se ejecuta por completo en un clúster estándar de la
organización de GDC aislado. En la capa de servicios, la
API de Gateway de Kubernetes estandariza el modelo de configuración; el plano de control de la puerta de enlace de IA (el controlador de Envoy Gateway y el controlador de Envoy Agent Router) lee los recursos de la API de Gateway y de Envoy Agent Router, y
configura el plano de datos: un proxy de Envoy Deployment que es el punto de entrada de la solicitud (expuesto a través de un Service de tipo LoadBalancer) y el procesador externo de Envoy Agent
Router que se ejecuta como un archivo adicional en el proxy Pod y ejecuta
la lógica específica de la IA. En la capa de aplicación, las cargas de trabajo de los clientes
(aplicaciones y agentes) envían una solicitud de IA al proxy (1), el proxy entrega
la solicitud al procesador externo, que extrae el nombre del modelo, traduce
la solicitud y registra el uso de tokens (2), el proxy reenvía el tráfico balanceado
a los Pod de inferencia del modelo seleccionado (3) y el modelo se ejecuta en los nodos de GPU
de la capa de infraestructura (4). Los backends de entrega de modelos se adjuntan a
la puerta de enlace como un AIServiceBackend (cualquier Service compatible con OpenAI) o
como un InferencePool cuyo selector de extremos elige la mejor réplica por
solicitud. Las imágenes de contenedor y los gráficos de Helm se extraen de Harbor.
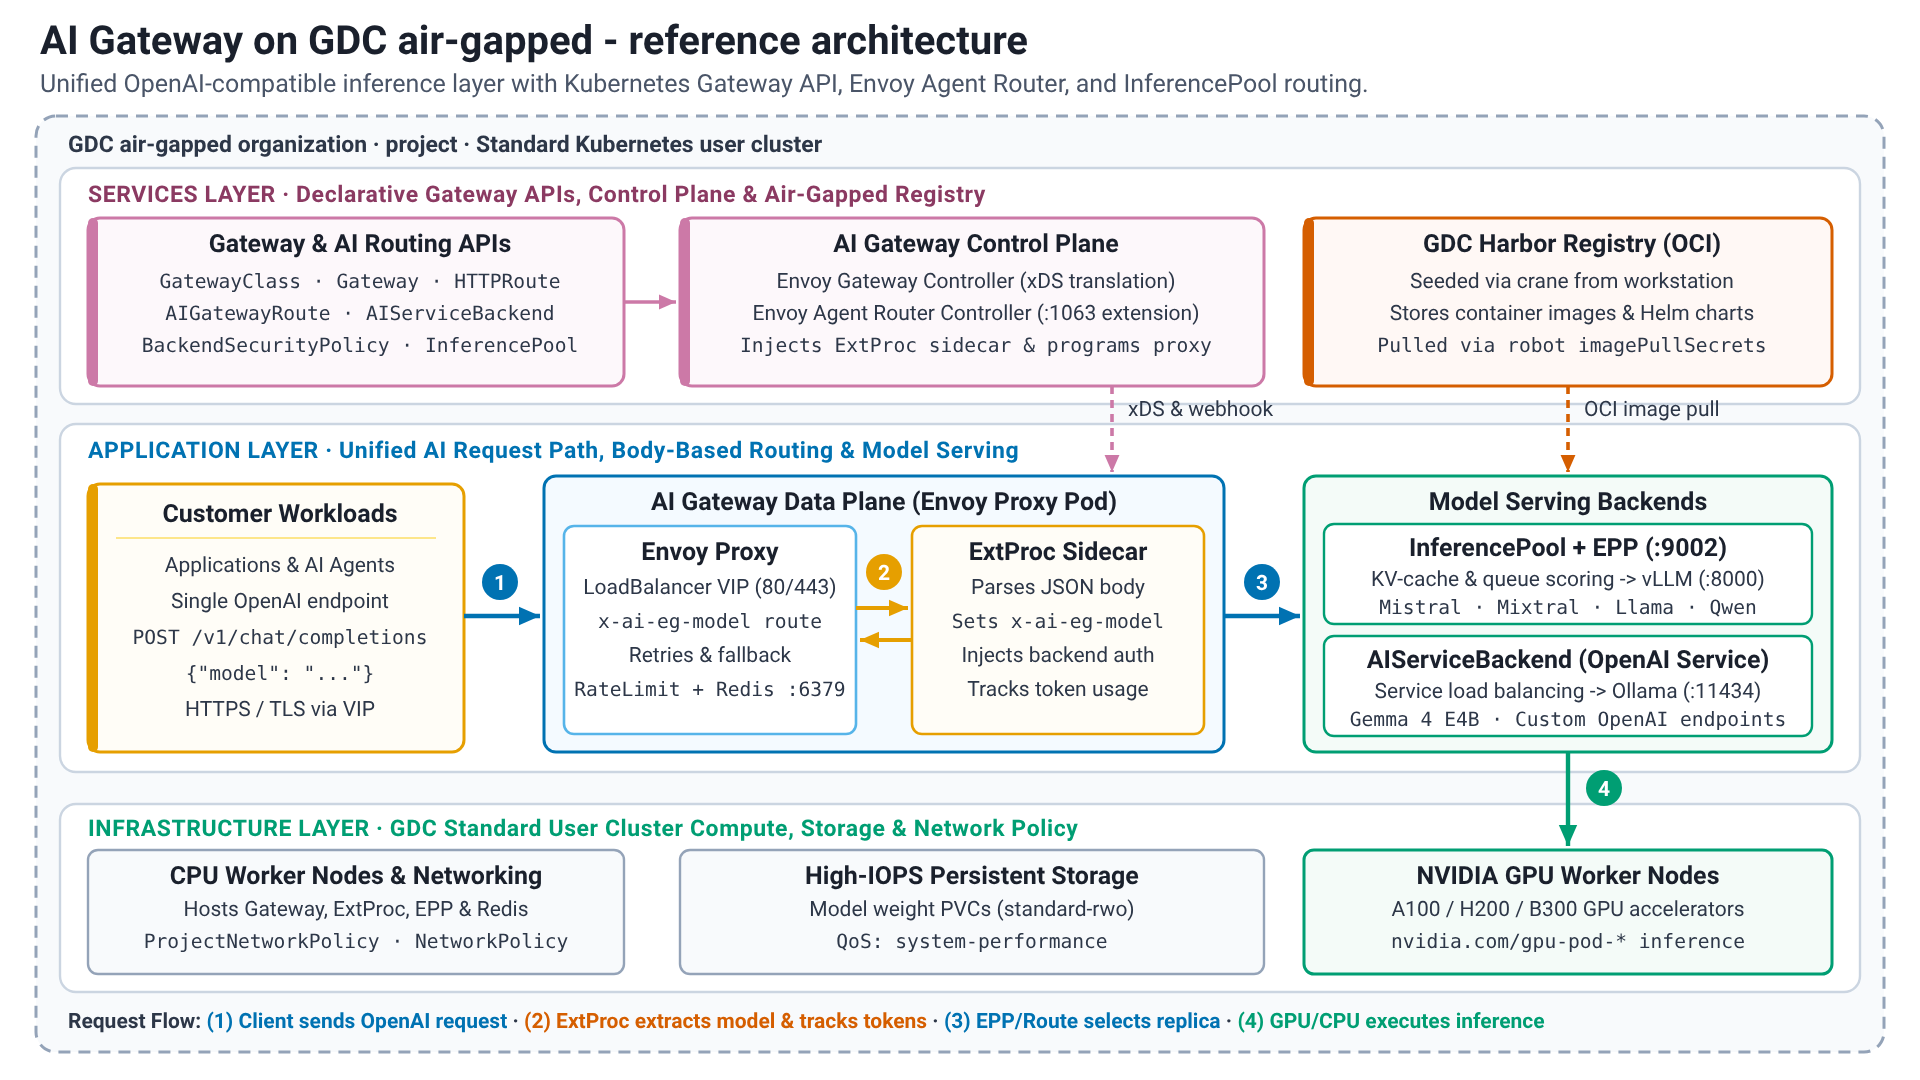
Componentes de la solución
La solución usa los siguientes componentes:
| Componente de la solución | Responsabilidades | Flujo de datos | Interfaces |
|---|---|---|---|
| API de puerta de enlace de Kubernetes | Modelo de recursos estándar orientado a roles para la entrada y el enrutamiento: GatewayClass (propiedad de la plataforma), Gateway (objetivos de escucha, TLS) y recursos de ruta (propiedad de los equipos de aplicaciones). Es el sucesor de la API de Ingress sin anotaciones específicas del proveedor. |
Solo configuración declarativa; los controladores supervisan los recursos y no transportan tráfico de solicitudes. | API de Kubernetes (gateway.networking.k8s.io/v1); las CRD se instalan desde el gráfico de CRD de Envoy Gateway. |
| Controlador de Envoy Gateway (plano de control) | Implementa la API de Gateway: aprovisiona un proxy de Envoy Deployment y LoadBalancer Service por Gateway, traduce rutas y políticas (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) en la configuración de xDS, ejecuta el servicio de límite de frecuencia global cuando se configura y llama al servidor de extensión del router del agente de Envoy a través de su administrador de extensiones para que se agreguen backends de InferencePool a la traducción. |
Supervisa la API de Kubernetes y envía la configuración de xDS a los proxies; no hay tráfico de solicitudes. | API de Kubernetes (watch), gRPC de xDS hacia los proxies, gRPC hacia el servidor de extensiones (puerto 1063). |
| Controlador del router del agente de Envoy (plano de control) | Concilia los recursos aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (reglas de enrutamiento en el nombre del modelo extraído), AIServiceBackend (un backend con su esquema de API), BackendSecurityPolicy (credenciales upstream) y GatewayConfig (configuración del procesador externo por Gateway) en recursos de Envoy Gateway, inserta el archivo adicional del procesador externo en los Pod del proxy de Envoy y entrega el servidor de extensiones que usa Envoy Gateway. |
Solo configuración. | API de Kubernetes, servidor de extensión de gRPC (puerto 1063), webhook de admisión de mutación para la inyección de sidecar. |
| Proxy de Envoy (plano de datos) | Punto de entrada de la solicitud: finaliza la TLS, hace coincidir los objetos de escucha y las rutas, balancea las cargas entre los extremos de backend, aplica límites de frecuencia y tiempos de espera, reintenta y recurre a backends alternativos, y emite registros de acceso y métricas. | Recibe solicitudes de clientes en la VIP de LoadBalancer (80/443), consulta al procesador externo para cada solicitud de IA, reenvía la solicitud al extremo de backend seleccionado (un Service o el Pod elegido por el selector de extremos) y transmite la respuesta de vuelta al cliente. |
HTTP/HTTPS hacia los clientes (API compatible con OpenAI), gRPC ext_proc hacia el archivo adicional y el selector de extremos, HTTP hacia los backends y gRPC hacia el servicio de límite de frecuencia. |
| Procesador externo (ExtProc) del router del agente de Envoy | Analiza el cuerpo de la solicitud compatible con OpenAI, extrae el campo model en el encabezado de enrutamiento x-ai-eg-model, aplica anulaciones de nombres de modelos, traduce las cargas útiles de solicitud y respuesta entre el esquema de API del cliente y el esquema de API del backend, inserta las credenciales upstream definidas por BackendSecurityPolicy y extrae el uso de tokens (entrada, salida, total) de la respuesta en metadatos dinámicos que se usan para las métricas y el límite de frecuencia basado en tokens. |
Contenedor sidecar en el proxy de Envoy Pod; procesa los cuerpos de solicitud y respuesta, incluidas las respuestas transmitidas. |
gRPC ext_proc de Envoy; extremo de métricas de Prometheus. |
| Extensión de inferencia de la API de Gateway (InferencePool + selector de extremos) | InferencePool (inference.networking.k8s.io/v1) agrupa los Pod de una implementación de servidor de modelos (selector de etiquetas, puerto de destino, por ejemplo, 8000) y hace referencia a su selector de extremos (EPP). InferenceObjective (v1alpha2) asigna una prioridad por modelo u objetivo. El EPP extrae las métricas del servidor de modelos (profundidad de la cola de solicitudes, utilización de la caché de KV, adaptadores de LoRA cargados) y selecciona el extremo para cada solicitud. |
El proxy llama al EPP (ext_proc, puerto 9002) con los encabezados de la solicitud; el EPP responde con el extremo que se usará; el proxy reenvía la solicitud a ese Pod. |
API de Kubernetes (CRD), ext_proc de gRPC (9002), recopilación de Prometheus de los servidores de modelos. |
| Redis (opcional) | Almacén de copia de seguridad del servicio de límite de frecuencia de Envoy: contadores compartidos para los límites basados en solicitudes y en tokens en todas las réplicas de proxy. Solo es necesario cuando se configura el límite de frecuencia global. | El servicio de límite de frecuencia lee y aumenta los contadores en el puerto 6379 para cada solicitud limitada. | Protocolo de Redis (6379). Redis 8.10 implementado en el clúster o una instancia de Redis existente. |
| Backends de entrega de modelos (Ollama/vLLM) | Entrega los modelos de ponderación abierta detrás de la puerta de enlace, implementados con la guía complementaria Establece modelos de ponderación abierta en GDC aislado. Se adjunta como un AIServiceBackend (cualquier Service compatible con OpenAI, por ejemplo, Ollama) o como un InferencePool (servidores de modelos, como vLLM, que exponen las métricas que califica el selector de extremos). |
Recibir las solicitudes enrutadas del proxy, ejecutar la inferencia en los nodos de GPU (o en la CPU para la evaluación funcional con modelos pequeños) y devolver la respuesta compatible con OpenAI | API de REST compatible con OpenAI: vLLM en el puerto 8000, Ollama en el puerto 11434; métricas de Prometheus (vLLM) para el selector de extremos. |
| Harbor | Almacena las imágenes de contenedor (proxy de Envoy, Envoy Gateway, controlador de Envoy Agent Router y procesador externo, servicio de límite de frecuencia, Endpoint Picker y Redis) y los gráficos de Helm (artefactos de OCI) de la solución. | Los artefactos se copian de los registros públicos a Harbor con seed_registry.sh (crane) desde una estación de trabajo con acceso a Internet. El clúster extrae imágenes con una cuenta de robot a través de secretos de extracción de imágenes, y los gráficos se renderizan desde Harbor con helm template. |
API de OCI Distribution, IU de Harbor y cuentas de robot. |
| Clúster de Standard y nodos de GPU | Aloja todos los componentes de la puerta de enlace (los nodos de CPU son suficientes) y los Pod de inferencia (nodos de GPU con los recursos del acelerador descubiertos desde los nodos). Proporciona VIP de LoadBalancer, almacenamiento persistente para los pesos del modelo y la aplicación de la política de red. |
Plataforma fundamental; las solicitudes ingresan a través de la VIP de LoadBalancer de Gateway y permanecen dentro de la red del clúster. |
API de Kubernetes, APIs de redes de GDC (networking.gdc.goog/v1 ProjectNetworkPolicy), consola de GDC y gdcloud para el administrador de la plataforma. |
Características y funciones
Esta arquitectura de referencia proporciona las siguientes funciones principales:
- Extremo unificado compatible con OpenAI: Las aplicaciones llaman a una dirección
(
/v1/chat/completions,/v1/models, …) para cada modelo que se entrega detrás de la puerta de enlace.- Componentes:
Gateway,AIGatewayRoute, proxy de Envoy y procesador externo. - Responsabilidades: Exponer una IP virtual estable, finalizar TLS, aceptar el formato de solicitud compatible con OpenAI y traducirlo al esquema de backend cuando sea necesario.
- Interfaces: HTTPS REST (JSON, incluidos los eventos enviados por el servidor para la transmisión).
- Componentes:
- Enrutamiento basado en el cuerpo (en función del modelo): La puerta de enlace lee el campo
modeldel cuerpo de la solicitud y enruta la solicitud al backend coincidente sin ninguna lógica de extremo del cliente.- Componentes: Procesador externo, reglas de
AIGatewayRouteque coinciden conx-ai-eg-model,AIServiceBackendyInferencePool. - Responsabilidades: Extraer el nombre del modelo, hacer coincidir las reglas de enrutamiento,
cambiar el nombre de los modelos (
modelNameOverride), dividir el tráfico por peso y recurrir a backends alternativos por prioridad. - Interfaces: API de Kubernetes (
aigateway.envoyproxy.io/v1beta1).
- Componentes: Procesador externo, reglas de
- Balanceo de cargas con reconocimiento del servidor de modelos: Las solicitudes a un
InferencePoolse envían a la réplica con la cola más corta y la caché de KV más útil, en lugar de round robin.- Componentes: Extensión de inferencia de la API de Gateway (
InferencePool,InferenceObjective, Endpoint Picker). - Responsabilidades: Extraer métricas del servidor de modelos, calificar extremos (profundidad de la cola, uso de la caché de KV, afinidad de la caché de prefijos, adaptadores de LoRA) y respetar las prioridades por objetivo bajo carga.
- Interfaces: API de Kubernetes (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- Componentes: Extensión de inferencia de la API de Gateway (
- Políticas de seguridad y autenticación ascendentes: La puerta de enlace inserta las credenciales para los backends que las requieren y nunca se distribuyen a las aplicaciones.
- Componentes:
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, receptores de TLS. - Responsabilidades: Insertar claves de API en los backends, finalizar
la TLS del cliente en el
Gateway, aplicar políticas de autenticación y autorización del cliente cuando sea necesario. - Interfaces: Son los
Secretde Kubernetes a los que hacen referencia las políticas.
- Componentes:
- Limitación de límite de frecuencia basada en tokens (opcional): El uso se mide en tokens, no
solo en solicitudes.
- Componentes: Procesador externo (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(límite de frecuencia global), servicio de límite de frecuencia, Redis. - Responsabilidades: Extraer los tokens de entrada, salida y totales de cada respuesta, adjuntarlos como costos de solicitud y aplicar presupuestos por consumidor o por modelo en todas las réplicas de proxy.
- Interfaces: API de Kubernetes, Redis (6379).
- Componentes: Procesador externo (
- Administración del tráfico: Las capacidades estándar de la API de Gateway se aplican al tráfico de IA.
- Componentes:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Responsabilidades: Coincidencia basada en el host, la ruta de acceso y el encabezado, tiempos de espera adecuados para generaciones largas, reintentos, división del tráfico ponderada y resguardo basado en prioridades entre backends.
- Interfaces: API de Kubernetes.
- Componentes:
- Observabilidad: Las métricas de solicitud, latencia y tokens están disponibles para
cada modelo.
- Componentes: Registros y estadísticas de acceso del proxy de Envoy, métricas del procesador externo (uso de tokens, duración de la solicitud, tiempo hasta el primer token) y métricas del selector de extremos.
- Responsabilidades: Exponer métricas en formato Prometheus y registros de acceso estructurados que la pila de observabilidad de GDC o un Prometheus administrado por el cliente puedan recopilar.
- Interfaces: Extremos de métricas de Prometheus y registros de salida estándar.
- Administración de artefactos aislados: Cada imagen y gráfico se almacena en
Harbor antes de la instalación.
- Componentes: Harbor,
seed_registry.sh, cuentas de robot, secretos de extracción de imágenes, recursoEnvoyProxy(imagen de proxy y secreto de extracción). - Responsabilidades: Propagar imágenes y gráficos de Helm de OCI desde una estación de trabajo conectada, fijar versiones y renderizar gráficos sin conexión con
helm template. - Interfaces: API de distribución de OCI, API de Kubernetes.
- Componentes: Harbor,
Principios de arquitectura
- Estándares primero: La puerta de enlace se configura a través de la API de Gateway de Kubernetes y su extensión de inferencia, y habla la API compatible con OpenAI hacia las aplicaciones, por lo que las aplicaciones, las rutas y los backends siguen siendo portátiles en todas las implementaciones de la puerta de enlace.
- La seguridad es lo primero: Todos los componentes y datos residen dentro del
límite de GDC aislado. La finalización de TLS se produce en la
Gateway, la puerta de enlace inserta las credenciales de backend y el acceso a la red se restringe con los objetosNetworkPolicyyProjectNetworkPolicy. - Soberanía de los datos: Las instrucciones, las respuestas, los pesos de los modelos y los datos de uso nunca salen de la organización de GDC del cliente; no se requiere conectividad externa para la operación.
- Separación de problemas: La API de Gateway orientada a roles permite que el administrador de la plataforma sea propietario de las políticas de red, TLS,
GatewayClassyGateway, mientras que los equipos de aplicaciones son propietarios de sus recursosAIGatewayRoute,AIServiceBackendyInferencePoolen sus propios espacios de nombres. - Plano de control y de datos desacoplado: Los controladores solo traducen la configuración; la ruta de solicitud consiste en el proxy de Envoy, su sidecar de procesador externo y el selector de extremos, que siguen entregando tráfico si se reinicia un controlador.
- Abierta y flexible: La arquitectura usa software de código abierto en todo momento (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM), y los mismos recursos de la API de Gateway se pueden entregar con implementaciones alternativas.
- Escalabilidad y rendimiento: El plano de datos se escala de forma horizontal agregando réplicas de proxy y de forma vertical ajustando la CPU y la memoria. El balanceo de cargas que reconoce el servidor de modelos mantiene las GPU saturadas sin sobrecargar las réplicas individuales.
- Experiencia del usuario final simplificada: Un extremo, un formato de API y una credencial para cada modelo acortan la ruta desde la implementación del modelo hasta el consumo.
- Resiliencia: Las verificaciones de estado y la replicación de Kubernetes, los reintentos de Envoy y el resguardo basado en prioridades entre backends mantienen el extremo disponible cuando fallan las réplicas de modelos individuales.
Consideraciones
- Escalabilidad y rendimiento:
- Los componentes de la puerta de enlace son cargas de trabajo solo de CPU; el proxy de Envoy
Deploymentde unGatewayescala de forma horizontal aumentando su recuento de réplicas (recursoEnvoyProxy) y de forma vertical aumentando las solicitudes de CPU y memoria. La inspección del cuerpo por parte del procesador externo cuesta CPU proporcional al tamaño de la solicitud y la respuesta; las respuestas transmitidas se procesan de forma incremental. - El balanceo de cargas que reconoce el servidor de modelos solo se aplica a los backends conectados como
un
InferencePool. El proxy balancea las cargas de los backends conectados como unAIServiceBackenden los extremos de suService. - La puerta de enlace no agrega capacidad de GPU: el rendimiento y la latencia están limitados por los servidores de modelos. Ajusta el tamaño de las implementaciones de modelos con el conjunto de guías complementarias (vLLM para una alta capacidad de procesamiento, Ollama para facilitar el uso y la evaluación solo de CPU).
- Las generaciones largas necesitan tiempos de espera de solicitud y de inactividad más largos que las APIs de HTTP típicas. Configúralos en las rutas y las políticas, en lugar de en los clientes.
- Los componentes de la puerta de enlace son cargas de trabajo solo de CPU; el proxy de Envoy
- Administración de recursos:
- Todos los componentes de la puerta de enlace se ejecutan en nodos de CPU y no necesitan acelerador. En la siguiente tabla, se proporciona un tamaño indicativo para una implementación funcional. La implementación de referencia establece las solicitudes y los límites exactos; los valores de producción dependen de la tasa de solicitudes y los tamaños de las cargas útiles.
- En la siguiente tabla de puertos, se enumeran todos los puertos que deben admitir las políticas de red.
- La planificación de GPU pertenece a las implementaciones de modelos: los nombres de los recursos del acelerador se descubren a partir de los nodos, como se describe en el conjunto de guías complementarias.
Dimensionamiento indicativo de los componentes de la puerta de enlace (solo CPU)
| Componente | Réplicas | CPU (solicitud) | Memoria (solicitud) | Notas |
|---|---|---|---|---|
| Controlador de Envoy Gateway | 1 | Entre 100 y 500 millones | 256Mi-1Gi | Plano de control; no está en la ruta de la solicitud |
| Controlador Envoy Agent Router | 1 | Entre 100 y 500 millones | De 256 Mi a 512 Mi | Plano de control y servidor de extensiones |
Proxy de Envoy Pod (proxy + sidecar de procesador externo) |
De 1 a 2 por Gateway |
500 m–2 | 512Mi-2Gi | Escala con el porcentaje de solicitudes y el tamaño de la carga útil |
| Selector de extremo | 1 por InferencePool |
Entre 100 y 500 millones | De 256 Mi a 512 Mi | Recopila las métricas del servidor de modelos |
| Servicio de límite de frecuencia (opcional) | 1 | Entre 100 y 500 millones | De 256 Mi a 512 Mi | Solo con límite de frecuencia global |
| Redis (opcional) | 1 | Entre 100 y 500 millones | 256Mi-1Gi | Solo con límite de frecuencia global |
Puertos de red
| Puerto | Componente | Objetivo |
|---|---|---|
| 80 / 443 | Proxy de Envoy (Gateway objetos de escucha) |
Punto de entrada HTTP/HTTPS en la VIP de LoadBalancer |
| 1063 | Controlador del router del agente de Envoy (servidor de extensiones) | Llamadas de gRPC desde el administrador de extensiones de Envoy Gateway |
| 9002 | Selector de extremo | Llamadas de gRPC ext_proc desde el proxy de Envoy |
| 6379 | Redis | Contadores de límite de frecuencia |
| 8000 | vLLM | API compatible con OpenAI y métricas del servidor de modelos |
| 11434 | Ollama | API compatible con Ollama y OpenAI del servidor de modelos |
- Disponibilidad y confiabilidad:
- El proxy y el procesador externo se ejecutan en el mismo
Pod; varias réplicas detrás de laServicedeLoadBalancerenmascaran las fallas individuales dePod, y los controladores se pueden reiniciar sin interrumpir el tráfico. - Las reglas de
AIGatewayRoutepueden enumerar varios backends con prioridades para que la puerta de enlace recurra a otro conjunto de réplicas o servidor de modelos cuando un backend no esté en buen estado. - El selector de extremos es un
Deploymentpor grupo. Si no está disponible, las solicitudes a eseInferencePoolfallarán hasta que vuelva a estar disponible. Ejecútalo con solicitudes de recursos y sondeos de preparación, y supervisalo como un componente del plano de datos. - Redis solo contiene contadores de límite de frecuencia; una interrupción de Redis afecta el límite de frecuencia, no el enrutamiento.
- El proxy y el procesador externo se ejecutan en el mismo
- Complejidad operativa:
- Alineación de versiones entre Envoy Gateway, Envoy Agent Router y la extensión de inferencia de la API de Gateway: actualiza los tres junto con la combinación probada (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, extensión de inferencia de la API de Gateway 1.5.0).
- Ciclo de vida aislado: Cada imagen y gráfico se vuelven a propagar en Harbor para
cada actualización; el recurso
EnvoyProxyy los valores del gráfico fijan el registro y el secreto de extracción. - Dos capas de configuración:
GatewayClass/Gateway/EnvoyProxy, que pertenecen a la plataforma, yAIGatewayRoute/AIServiceBackend/InferencePool, que pertenecen al equipo. Incorporar un modelo nuevo significa agregar una regla de enrutamiento y un backend, no una puerta de enlace nueva. - Supervisión: porcentaje de solicitudes, latencia (incluido el tiempo hasta el primer token), uso de tokens por modelo y por consumidor, puntuación del selector de extremos y uso de GPU de los servidores de modelos.
InferenceObjectivesigue siendo una API alfa (v1alpha2). Se esperan cambios en el esquema entre las versiones de la extensión de inferencia.
- Seguridad y cumplimiento:
- Toda la solución funciona dentro del perímetro de seguridad aislado de GDC.
- Las políticas de red son obligatorias: un espacio de nombres
NetworkPolicyadmite el tráfico del proxy a los puertos del servidor de modelos (8000, 11434) y al selector de extremos (9002), y unProjectNetworkPolicyadmite el tráfico de clientes a la VIP deLoadBalancercuando los consumidores residen fuera del proyecto. - La TLS finaliza en la
Gatewaycon un certificado almacenado en unSecretde Kubernetes; los clientes solo ven el extremo de la puerta de enlace. - Las credenciales ascendentes (por ejemplo, una clave de API que requiere un servidor de modelos)
se almacenan en
Secreta los que hace referencia unBackendSecurityPolicyy se insertan por la puerta de enlace, por lo que las aplicaciones nunca contienen credenciales de backend. - La limitación de frecuencia basada en tokens limita el consumo de la costosa capacidad de GPU por consumidor o por modelo.
- Las cuentas de robot de Harbor y los Secrets de extracción de imágenes de Kubernetes garantizan el acceso seguro a las imágenes de contenedor; el RBAC de la API de Gateway orientado a roles separa las responsabilidades de la plataforma y de la aplicación.
Decisiones de diseño
Se tomaron las siguientes decisiones de diseño clave para esta arquitectura de referencia:
Decisión 1: Implementación de la puerta de enlace de IA: Envoy Agent Router de código abierto en Envoy Gateway frente a distribuciones alternativas
| Contexto | Decisión clave | Razones |
|---|---|---|
| La puerta de enlace de IA es la principal opción de arquitectura con alternativas viables, desde opciones de código abierto autoadministradas hasta ofertas con asistencia comercial: (a) Envoy Agent Router en Envoy Gateway (código abierto), (b) kgateway y agentgateway (implementaciones de la API de Gateway de código abierto que también controlan el tráfico de proveedores de LLM, las herramientas de MCP y la comunicación entre agentes en un plano de datos, opcionalmente con asistencia de proveedores de solo.io), (c) Solo Enterprise para agentgateway como la opción premium con asistencia comercial. | La implementación de referencia usa el Envoy Agent Router de código abierto en Envoy Gateway. Las alternativas siguen siendo opciones válidas detrás de los mismos recursos de la API de Gateway. Se recomienda una distribución con asistencia comercial para los entornos de producción que requieren asistencia dedicada del proveedor. | Ventajas del código abierto: enrutamiento L7 ligero, de alto rendimiento y que cumple con los estándares, sin tarifas de licencia, ideal para evaluar la solución antes de comprometerse con una oferta pagada; Envoy Agent Router es la opción validada en este conjunto de guías. Desventajas del código abierto: El equipo de Soluciones y la comunidad brindan asistencia según el criterio del mejor esfuerzo, lo que puede no satisfacer los entornos de producción principales. Ventajas premium: Acuerdos de asistencia para empresas para el ciclo de vida de la puerta de enlace y, a menudo, capacidades agénticas avanzadas. Desventajas de Premium: acuerdo de asistencia o licencia pagada y una relación adicional con el proveedor. |
Decisión 2: API de Kubernetes Gateway con la extensión de inferencia en comparación con Ingress o una API de puerta de enlace de propiedad exclusiva
| Contexto | Decisión clave | Razones |
|---|---|---|
| Los extremos de inferencia se pueden exponer con la API de Ingress heredada, un formato de configuración específico de la puerta de enlace o la API de Kubernetes Gateway. El balanceo de cargas adaptado al modelo también necesita una forma de describir los grupos de servidores de modelos y sus prioridades. | La solución se estandariza en la API de Gateway de Kubernetes (GatewayClass, Gateway, rutas) implementada por Envoy Gateway y en la extensión de inferencia de la API de Gateway (InferencePool, InferenceObjective, selector de extremos) para el enrutamiento adaptado a modelos. |
La API de Gateway es el estándar de Kubernetes que sucede a Ingress, está orientada a roles (equipos de plataforma frente a equipos de aplicaciones) y es portátil entre implementaciones. La extensión de inferencia es el estándar de la comunidad para el enrutamiento que reconoce el servidor de modelos (profundidad de la cola, caché de KV y prioridades) y es compatible con Envoy Agent Router de forma predeterminada. Las distribuciones de puerta de enlace alternativas implementan las mismas APIs, lo que mantiene la decisión 1 reversible. |
Decisión 3: Enrutamiento basado en el cuerpo en el campo model de las solicitudes compatibles con OpenAI como el extremo unificado
| Contexto | Decisión clave | Razones |
|---|---|---|
Las aplicaciones pueden abordar los modelos a través de un extremo por modelo (basado en el host o en la ruta de acceso), a través de un encabezado personalizado establecido por el cliente o a través del campo model que ya lleva cada solicitud compatible con OpenAI. |
La puerta de enlace expone un extremo compatible con OpenAI y enruta en el campo model: el procesador externo lo extrae en el encabezado x-ai-eg-model y las reglas de AIGatewayRoute coinciden con ese encabezado. |
Los clientes y SDK compatibles con OpenAI existentes funcionan sin cambios y cambian de modelo modificando una cadena; los extremos, las credenciales y la ubicación del modelo pueden cambiar sin tocar las aplicaciones; las mismas reglas pueden asignar un nombre de modelo a varios backends para la división del tráfico, el resguardo o las anulaciones de nombres de modelos. |
Decisión 4: Propagación de artefactos aislados en Harbor en comparación con extracciones a pedido
| Contexto | Decisión clave | Razones |
|---|---|---|
| La instalación upstream extrae imágenes de contenedor de registros públicos y gráficos de Helm como artefactos de OCI según demanda, lo que es imposible en un entorno aislado. | Todas las imágenes de contenedor (proxy de Envoy, Envoy Gateway, controlador de Envoy Agent Router y procesador externo, servicio de límite de frecuencia, Endpoint Picker, Redis) y los gráficos de Helm de Envoy Gateway y Envoy Agent Router se propagan en un proyecto de Harbor con seed_registry.sh (crane), los gráficos se renderizan sin conexión con helm template de Harbor, y el recurso EnvoyProxy y los valores del gráfico fijan el registro de Harbor y el secreto de extracción. |
Un paso de inicialización repetible y auditable por versión; el clúster nunca necesita conectividad externa; la fijación de versiones hace que las actualizaciones sean explícitas y reversibles. |
Decisión 5: Límite de frecuencia opcional basado en tokens con Redis en comparación con los límites basados solo en solicitudes
| Contexto | Decisión clave | Razones |
|---|---|---|
| La capacidad de la GPU se consume por token, no por solicitud. Un límite de recuento de solicitudes no puede proteger un modelo compartido de algunas instrucciones muy grandes o generaciones largas. Límite de frecuencia global en Envoy Gateway necesita un almacén de contadores compartido. | La límite de frecuencia basada en tokens es una función opcional de la arquitectura: el procesador externo registra los tokens de entrada, salida y totales por solicitud (llmRequestCosts), un BackendTrafficPolicy aplica el presupuesto y una instancia de Redis (Redis 8.10, implementada en el clúster o en una instancia existente) almacena los contadores. Las implementaciones sin límite de frecuencia no necesitan Redis. |
El uso se mide en la unidad que refleja el costo, los presupuestos se aplican de manera coherente en todas las réplicas de proxy y la dependencia solo la pagan los clientes que necesitan cuotas. |
Decisión 6: Topología: plano de control y de datos de la puerta de enlace en un espacio de nombres dedicado de un clúster estándar, modelos en espacios de nombres de aplicaciones
| Contexto | Decisión clave | Razones |
|---|---|---|
| La puerta de enlace podría ejecutarse en un clúster dedicado, en cada espacio de nombres de la aplicación o una vez por clúster estándar junto a los modelos que precede. Los modelos de ponderación abierta en GDC aislado se implementan en clústeres estándar (conjunto de guías complementarias). | El plano de control de Envoy Gateway y Envoy Agent Router, y el plano de datos del proxy de Envoy se ejecutan en un espacio de nombres dedicado del clúster estándar que aloja los modelos. AIGatewayRoute, AIServiceBackend, InferencePool y las implementaciones de modelos se encuentran en los espacios de nombres de la aplicación y se hace referencia a ellos en todos los espacios de nombres. |
Las solicitudes permanecen dentro de la red del clúster entre el proxy y los Pod del modelo (latencia más baja, sin balanceadores de cargas adicionales), el administrador de la plataforma es propietario del espacio de nombres de la puerta de enlace, mientras que los equipos de aplicaciones son propietarios de sus rutas y modelos, y el selector de extremos puede extraer los servidores de modelos directamente. Una puerta de enlace de cliente por proyecto que reenvía a una puerta de enlace de servidor central sigue siendo una extensión de esta topología para el consumo de varios proyectos. |
Suposiciones y limitaciones
- El entorno de GDC aislado 1.16.2-hf1 o posterior está disponible con un clúster estándar que ejecuta Kubernetes v1.32.13-gke.400 o una versión posterior.
- Hay suficientes recursos de hardware (en especial, GPU) para los backends de entrega de modelos. Los componentes de la puerta de enlace se ejecutan en nodos de CPU. Los modelos reales necesitan GPUs; los modelos pequeños en Ollama pueden ejecutarse en CPU solo para la evaluación funcional.
- La instancia de Harbor está configurada y es accesible, y hay una estación de trabajo con acceso a Internet y conectividad al entorno de GDC (API de Harbor y Kubernetes) disponible para propagar imágenes y gráficos.
- Los usuarios tienen los permisos necesarios: roles de proyecto de visualizador de instancias de Harbor
y administrador de clústeres estándar, además de un
StandardClusterRoleBindingpara el rolcluster-adminen el clúster estándar para la instalación con alcance de clúster (CRD,GatewayClass, espacios de nombres). Consulta la implementación de referencia. - Los backends de entrega de modelos exponen una API compatible con OpenAI. Los backends
conectados como un
InferencePooltambién exponen las métricas compatibles con vLLM en las que se basa el selector de extremos. - Limitación: La asistencia para los componentes de código abierto (Envoy Gateway, Envoy Agent Router y Gateway API Inference Extension) se brinda según el mejor esfuerzo del equipo de Soluciones. La asistencia dedicada del proveedor requiere una distribución con asistencia comercial (Decisión 1).
- Limitación:
InferenceObjectivees una API alfa (inference.networking.x-k8s.io/v1alpha2) y puede cambiar entre las versiones de la extensión de inferencia. - Limitación: Se requiere una VIP de
LoadBalancerpara laGatewayy unProjectNetworkPolicypara los consumidores fuera del proyecto. Dentro del proyecto, los clientes en el clúster okubectl port-forwardpueden llegar a la puerta de enlaceServicedirectamente. - Limitación: Gemini en GDC, el ajuste de modelos, los modelos de IA generativa que no son LLM y la entrega de modelos de varios nodos están fuera del alcance de esta versión de la solución.
Flujo de usuarios
A continuación, se muestra un flujo de usuarios completo para la puerta de enlace de IA en GDC aislado: primero, la ruta de solicitud en la que se basa un desarrollador de aplicaciones y, luego, la ruta de configuración que sigue el administrador de la plataforma.
1. Ruta de acceso a la solicitud del desarrollador
Una aplicación o un agente solo necesitan el extremo de la puerta de enlace, una credencial de cliente si la puerta de enlace aplica una y el nombre del modelo.
- Envía la solicitud: La aplicación llama a
POST /v1/chat/completionsen el extremo de la puerta de enlace con un cuerpo JSON compatible con OpenAI que nombra el modelo (por ejemplo,"model": "gemma"), exactamente como llamaría a cualquier servicio compatible con OpenAI. - Ingresa a la puerta de enlace: La solicitud llega a la VIP de
LoadBalancerdeGateway; el proxy de Envoy finaliza la TLS y hace coincidir el objeto de escucha y la ruta. - Procesa el cuerpo: El proxy entrega la solicitud al procesador externo del enrutador del agente de Envoy, que analiza el cuerpo, extrae el nombre del modelo en el encabezado
x-ai-eg-modely traduce la carga útil al esquema de backend si difiere. - Selecciona el backend: La regla
AIGatewayRouteque coincide con el nombre del modelo selecciona unAIServiceBackend(por ejemplo, OllamaService) o unInferencePool(por ejemplo, un conjunto de réplicas de vLLM); para unInferencePool, el selector de extremos elige la réplica con la cola más corta y la mejor coincidencia de caché de KV. - Reenvío y respuesta: El proxy inserta credenciales upstream cuando se aplica una
BackendSecurityPolicy, reenvía la solicitud alPodelegido, transmite la respuesta de vuelta y permite que el procesador externo registre el uso de tokens, lo que alimenta las métricas y, cuando se configura, el límite de frecuencia basado en tokens. - Cambia de modelo: Para usar otro modelo, el desarrollador cambia la cadena
model. No se necesita un extremo, una credencial ni una biblioteca cliente nuevos.
2. Ruta de configuración del administrador de la plataforma
- Propaga artefactos en Harbor: Crea las cuentas de robot de Harbor y, luego, copia
las imágenes de contenedor y los gráficos de Helm de Envoy Gateway y Envoy Agent Router
en Harbor con
seed_registry.shdesde una estación de trabajo con acceso a Internet. - Instala Envoy Gateway: Renderiza los gráficos de CRD y del controlador desde Harbor
con
helm templatey aplícalos en el espacio de nombres de la puerta de enlace. Crea el recursoEnvoyProxyque fija la imagen del proxy y el secreto de extracción, y verifica el controlador con unGatewayClass,GatewayyHTTPRoutebásicos. - Instala el Envoy Agent Router: Instala las CRD del Envoy Agent Router y las
CRD de la extensión de inferencia de la API de Gateway, implementa el controlador del Envoy Agent Router
y vuelve a configurar Envoy Gateway para que llame a su servidor de extensiones (puerto
1063) y acepte backends de
InferencePool. De manera opcional, implementa Redis y habilita el servicio de límite de frecuencia global. - Expón la puerta de enlace: Crea el
GatewayClassy elGatewaycon los objetos de escucha HTTP y HTTPS (certificado TLSSecret), espera la VIP deLoadBalancery aplica laProjectNetworkPolicypara los consumidores fuera del proyecto. - Adjunta modelos: Implementa los backends de entrega de modelos con el conjunto de guías complementarias y, luego, crea recursos
AIServiceBackendparaServices compatibles con OpenAI yInferencePool, además de recursos de Endpoint Picker para conjuntos de réplicas compatibles con vLLM, junto con los objetos de espacio de nombresNetworkPolicy. - Publica la ruta: Crea el
AIGatewayRoutecon una regla por nombre de modelo (enrutamiento basado en el cuerpo) y, cuando sea necesario, objetosBackendSecurityPolicyyBackendTrafficPolicypara las credenciales ascendentes y los presupuestos de tokens. - Valida y opera: Llama a
/v1/modelsy/v1/chat/completionsa través de la VIP (o un resguardo dekubectl port-forward), verifica las métricas del proxy, del procesador externo y del selector de extremos, y entrega los nombres del extremo y del modelo a los equipos de la aplicación. Escala las réplicas de proxy y las implementaciones de modelos de forma independiente; actualiza Envoy Gateway, Envoy Agent Router y la Inference Extension juntos.
Los pasos detallados se proporcionan en la implementación de referencia del router del agente de Envoy y en la guía del usuario de enrutamiento basado en el cuerpo con el router del agente de Envoy.
Materiales adicionales
- Implementación de referencia del agente de Envoy Router
- Guía del usuario para el enrutamiento basado en el cuerpo con Envoy Agent Router
- Arquitectura de referencia de LLM de pesos abiertos
- Documentación de Envoy Agent Router
- Envoy Gateway
- API de puerta de enlace de Kubernetes
- Extensión de inferencia de la API de Gateway
- Documentación de Google Distributed Cloud aislado