


Problembeschreibung
Organisationen, die Large Language Models (LLMs) in Air-Gap-Umgebungen ausführen, sammeln schnell Modellendpunkte an: Jedes Open-Weight-Modell, das in Google Distributed Cloud (GDC) mit Air Gap bereitgestellt wird (siehe den begleitenden Leitfaden „Open-Weight-Modelle in GDC mit Air Gap“), stellt einen eigenen Kubernetes-Service, eine eigene Adresse, eigene Anmeldedaten und einen eigenen Betriebslebenszyklus bereit.
Anwendungs- und KI-Agenten-Entwickler arbeiten in isolierten Architekturen, hartcodieren einen Endpunkt pro Modell und schreiben Integrationen bei jeder Modelliteration neu. Diese Fragmentierung führt zu technischen Schulden und verlangsamt die Bereitstellung geschäftskritischer, mehrstufiger agentischer Arbeitslasten.
Standardnetzwerkschichten sind außerdem „KI-blind“: Ein herkömmlicher Load Balancer behandelt Inferenz-Traffic wie generischen HTTP-Traffic und kann das Feld model einer Anfrage nicht lesen, latenzempfindliche Arbeitslasten nicht priorisieren, Tokens anstelle von Anfragen nicht berücksichtigen oder eine Anfrage nicht an das Modell-Server-Replikat weiterleiten, das bereits den relevanten KV-Cache enthält. In teuren GPU-Clustern mit Air Gap führt dies zu einer unzureichenden Hardwareauslastung und einem schlechten Return on Investment. Gemini on GDC bietet zwar verwaltete Frontier-Modelle, aber Kunden, die diese mit selbst gehosteten Open-Weight-Modellen kombinieren, benötigen eine Inferenzebene, die cloudähnliche Agilität bietet, ohne die Datenhoheit zu beeinträchtigen: Keine Anfrage, kein Prompt und keine Modellgewichtung darf die GDC-Grenze verlassen.
Vorgeschlagene Lösung
In diesem Dokument wird die Referenzarchitektur für ein selbstverwaltetes KI-Gateway in GDC mit Air Gap beschrieben: eine sichere, zentrale Inferenzebene, die Anwendungen einen OpenAI-kompatiblen Endpunkt für alle Modelle bietet und jede Anfrage an das richtige Backend weiterleitet. Die Referenzimplementierung basiert auf der Kubernetes Gateway API: Envoy Gateway ist die Gateway API-Implementierung (Steuerungsebene und Envoy-Proxy-Datenebene) und Envoy Agent Router (ehemals Envoy AI Gateway) erweitert sie um KI-spezifische Anfrageverarbeitung: Modellextraktion aus dem Anfragetext, Anfrage- und Antwortübersetzung, Upstream-Authentifizierung, Tokenabrechnung und optional tokenbasierte Ratenbegrenzung. Die Gateway API Inference Extension fügt eine modellserverbasierte Endpunktauswahl (InferencePool und Endpoint Picker) hinzu, damit die GPU-Kapazität effizient genutzt wird. Alle Artefakte werden in der Harbor-Registry der GDC-Organisation bereitgestellt und der gesamte Stack wird in einem Standardcluster ohne externe Verbindung ausgeführt.
Inhalt: Diese Architektur umfasst die Bereitstellung von Envoy Gateway und Envoy Agent Router in einem Standardcluster, die Gateway API-Ressourcen (GatewayClass, Gateway) und Envoy Agent Router-Ressourcen (AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig), die einen einheitlichen OpenAI-kompatiblen Endpunkt bereitstellen, textbasiertes Routing im Feld model, die Gateway API Inference Extension (InferencePool, InferenceObjective, Endpoint Picker) für modellbasiertes Load Balancing, optionale tokenbasierte Ratenbegrenzung mit Redis, TLS-Terminierung am Gateway, Netzwerkrichtlinien (NetworkPolicy / ProjectNetworkPolicy) und die Verwaltung von Artefakten mit Air Gap in Harbor. Die Back-Ends für die Modellbereitstellung hinter dem Gateway (Ollama, vLLM) werden mit dem Begleitset „Open Weight Models on GDC air-gapped“ bereitgestellt.
Nicht enthalten: Diese Architektur deckt kein verwaltetes KI-Gateway-Produkt, die Bereitstellung und Abstimmung der Modelle selbst (Begleitdokumentation), die Feinabstimmung von Modellen, nicht-LLM-GenAI-Modalitäten, den Agent-zu-Tool-Traffic (MCPRoute) oder kommerziell unterstützte Gateway-Distributionen ab. Gemini on GDC ist eine verwaltete Produktfunktion. Die Bereitstellung ist nicht Gegenstand dieses Leitfadens. In dieser Version des Leitfadens wird das Gateway mit selbst gehosteten Open-Weight-Modellen validiert.
Zielgruppe: Die primäre Zielgruppe für dieses Dokument umfasst Plattformadministratoren, die für die Bereitstellung und den Betrieb des Gateways in einem Standardcluster verantwortlich sind, sowie technische Architekten, die KI-Plattformen in der Air-Gap-Umgebung entwerfen. Anwendungsentwickler, die den einheitlichen Endpunkt nutzen, sind eine sekundäre Zielgruppe, die davon profitiert, zu verstehen, wie ihre Anfragen weitergeleitet werden.
Architektur
Die Lösung wird vollständig in einem Standardcluster der GDC mit Air Gap-Organisation ausgeführt. In der Dienstebene standardisiert die Kubernetes Gateway API das Konfigurationsmodell. Die Steuerungsebene des KI-Gateways (der Envoy Gateway-Controller und der Envoy Agent Router-Controller) liest die Gateway API- und Envoy Agent Router-Ressourcen und konfiguriert die Datenebene: einen Envoy-Proxy Deployment, der der Einstiegspunkt für Anfragen ist (über einen Service vom Typ LoadBalancer verfügbar gemacht) und den externen Envoy Agent Router-Prozessor, der als Sidecar im Proxy Pod ausgeführt wird und die KI-spezifische Logik ausführt. In der Anwendungsebene senden Kundenarbeitslasten (Anwendungen und Agents) eine KI-Anfrage an den Proxy (1). Der Proxy übergibt die Anfrage an den externen Prozessor, der den Modellnamen extrahiert, die Anfrage übersetzt und die Tokennutzung aufzeichnet (2). Der Proxy leitet den ausgeglichenen Traffic an die Inferenz-Pods des ausgewählten Modells weiter (3) und das Modell wird auf den GPU-Knoten der Infrastrukturebene ausgeführt (4). Back-Ends für die Modellbereitstellung werden entweder als AIServiceBackend (beliebiger OpenAI-kompatibler Service) oder als InferencePool an das Gateway angehängt, dessen Endpunktauswahl die beste Replik pro Anfrage auswählt. Container-Images und Helm-Diagramme werden aus Harbor abgerufen.
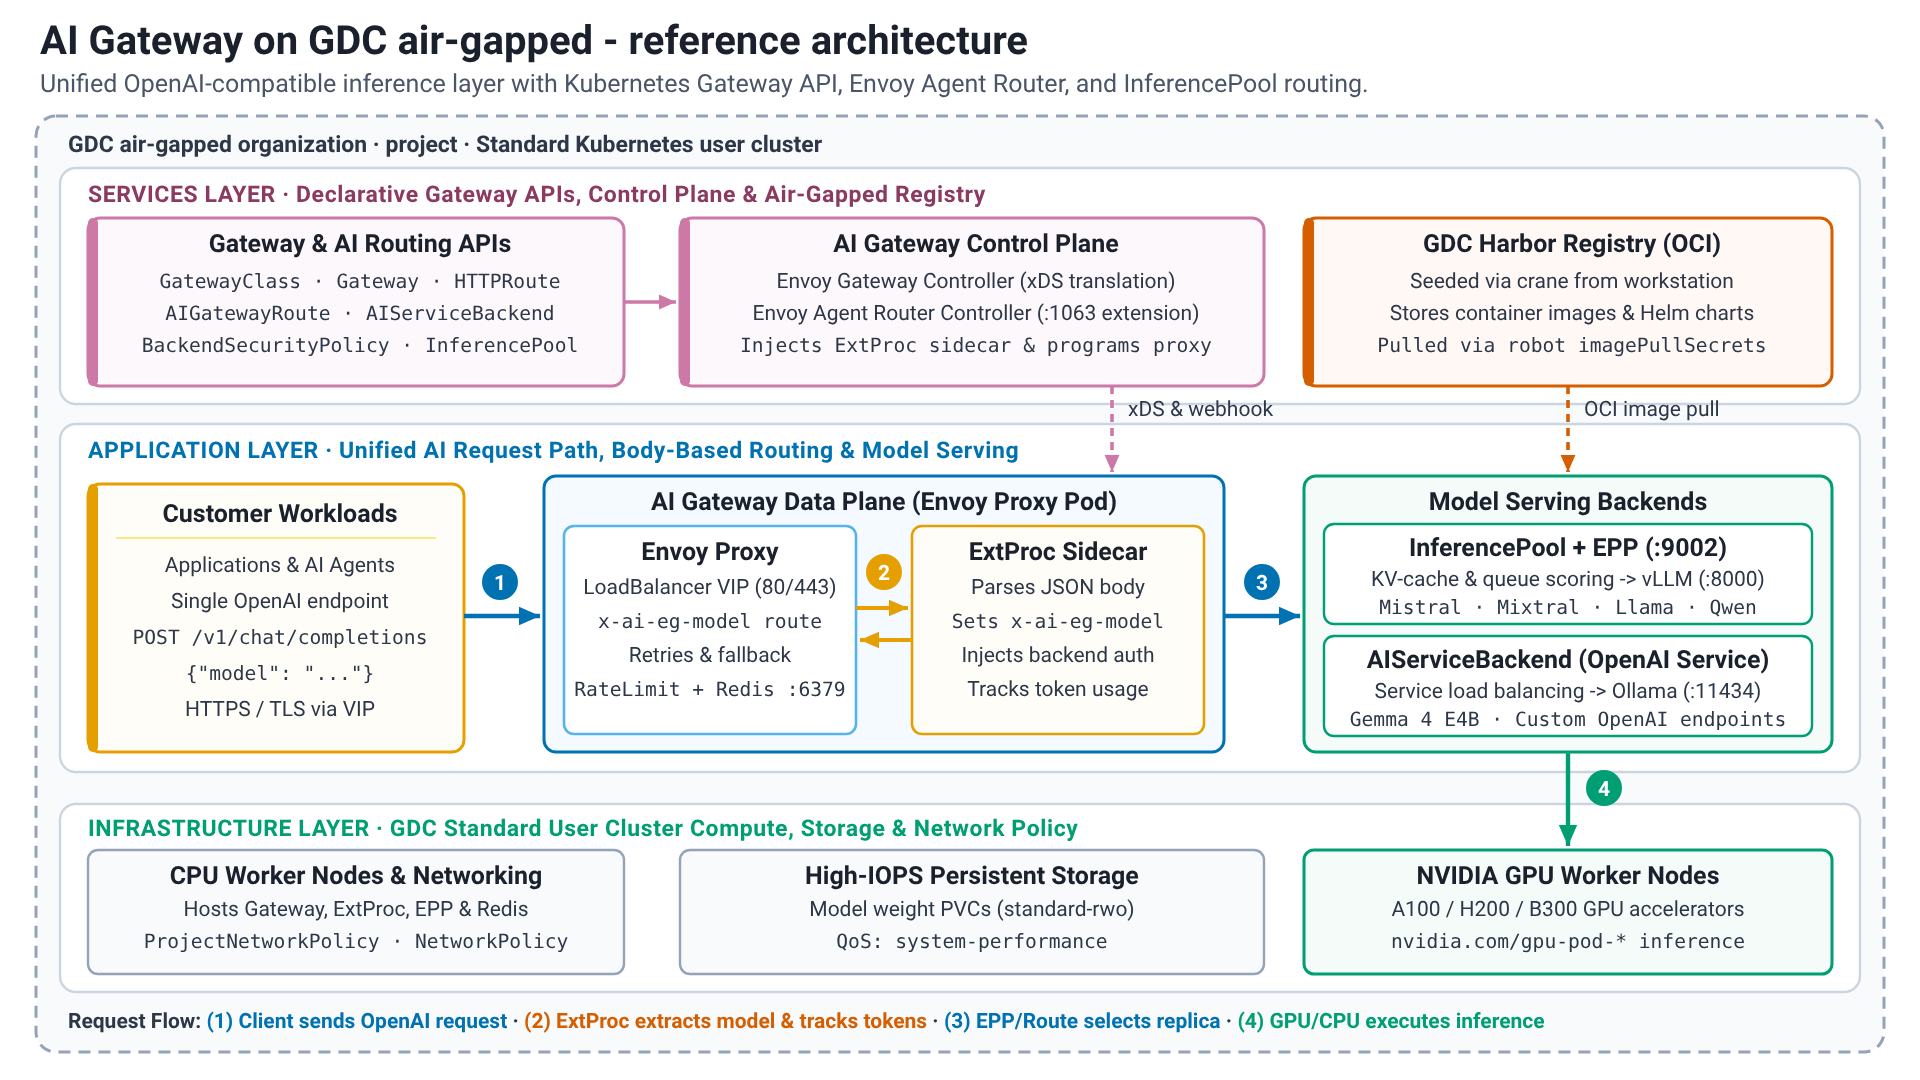
Lösungskomponenten
Die Lösung verwendet die folgenden Komponenten:
| Lösungskomponente | Verantwortlichkeiten | Datenfluss | Schnittstellen |
|---|---|---|---|
| Kubernetes Gateway API | Standardmäßiges, rollenorientiertes Ressourcenmodell für Ingress und Routing: GatewayClass (im Besitz der Plattform), Gateway (Listener, TLS) und Routenressourcen (im Besitz von Anwendungsteams). Nachfolger der Ingress API ohne anbieterspezifische Annotationen. |
Nur deklarative Konfiguration; die Ressourcen werden von den Controllern überwacht und übertragen keinen Anfragetraffic. | Kubernetes API (gateway.networking.k8s.io/v1); die CRDs werden über das Envoy Gateway-CRD-Diagramm installiert. |
| Envoy Gateway-Controller (Steuerungsebene) | Implementiert die Gateway API: stellt einen Envoy-Proxy Deployment und LoadBalancer Service pro Gateway bereit, übersetzt Routen und Richtlinien (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) in die xDS-Konfiguration, führt den globalen Dienst zur Ratenbegrenzung aus, wenn er konfiguriert ist, und ruft den Envoy Agent Router-Erweiterungsserver über seinen Erweiterungsmanager auf, damit InferencePool-Back-Ends der Übersetzung hinzugefügt werden. |
Überwacht die Kubernetes API und überträgt die xDS-Konfiguration an die Proxys; kein Anfragetraffic. | Kubernetes API (watch), xDS gRPC zu den Proxys, gRPC zum Erweiterungsserver (Port 1063). |
| Envoy Agent Router-Controller (Steuerungsebene) | Gleicht die aigateway.envoyproxy.io/v1beta1-Ressourcen, AIGatewayRoute (Routingregeln für den extrahierten Modellnamen), AIServiceBackend (ein Backend mit seinem API-Schema), BackendSecurityPolicy (Upstream-Anmeldedaten) und GatewayConfig (Einstellungen für externe Prozessoren pro Gateway) mit Envoy Gateway-Ressourcen ab, fügt die Sidecar-Datei für den externen Prozessor in die Envoy-Proxy-Pods ein und stellt den von Envoy Gateway verwendeten Erweiterungsserver bereit. |
Nur Konfiguration. | Kubernetes API, gRPC-Erweiterungsserver (Port 1063), mutierender Zulassungs-Webhook für die Sidecar-Injektion. |
| Envoy-Proxy (Datenebene) | Anfrageeinstiegspunkt: Beendet TLS, gleicht Listener und Routen ab, führt Load Balancing über Backend-Endpunkte hinweg durch, erzwingt Ratenbegrenzungen und Zeitlimits, wiederholt Versuche und greift auf alternative Backends zurück und gibt Zugriffslogs und Messwerte aus. | Empfängt Clientanfragen über die LoadBalancer-VIP (80/443), konsultiert den externen Prozessor für jede KI-Anfrage, leitet die Anfrage an den ausgewählten Backend-Endpunkt (Service oder Pod, ausgewählt vom Endpunktauswahltool) weiter und streamt die Antwort zurück an den Client. |
HTTP/HTTPS für Clients (OpenAI-kompatible API), ext_proc gRPC für den Sidecar und den Endpoint Picker, HTTP für die Backends, gRPC für den Dienst zur Ratenbegrenzung. |
| Externer Prozessor (ExtProc) für Envoy Agent Router | Parst den OpenAI-kompatiblen Anfragetext, extrahiert das Feld model in den Routing-Header x-ai-eg-model, wendet Überschreibungen für Modellnamen an, übersetzt Anfrage- und Antwortnutzlasten zwischen dem Client-API-Schema und dem Backend-API-Schema, fügt die von BackendSecurityPolicy definierten Upstream-Anmeldedaten ein und extrahiert die Tokennutzung (Eingabe, Ausgabe, Gesamt) aus der Antwort in dynamische Metadaten, die für tokenbasierte Ratenbegrenzung und Messwerte verwendet werden. |
Sidecar-Container im Envoy-Proxy Pod; verarbeitet Anfrage- und Antworttext, einschließlich gestreamter Antworten. |
Envoy ext_proc gRPC; Prometheus-Messwertendpunkt. |
| Gateway API Inference Extension (InferencePool + Endpoint Picker) | InferencePool (inference.networking.k8s.io/v1) gruppiert die Pods einer Modell-Server-Bereitstellung (Labelauswahl, Zielport, z. B. 8000) und verweist auf den zugehörigen Endpoint Picker (EPP). InferenceObjective (v1alpha2) weist jedem Modell oder Ziel eine Priorität zu. Der EPP liest die Messwerte des Modellservers (Tiefe der Anfrage-Warteschlange, KV-Cache-Nutzung, geladene LoRA-Adapter) aus und wählt den Endpunkt für jede Anfrage aus. |
Der Proxy ruft den EPP (ext_proc, Port 9002) mit den Anfrageheadern auf. Der EPP antwortet mit dem zu verwendenden Endpunkt. Der Proxy leitet die Anfrage an diesen Pod weiter. |
Kubernetes API (CRDs), gRPC ext_proc (9002), Prometheus-Scraping der Modellserver. |
| Redis (optional) | Sicherungsspeicher des Envoy-Dienstes zur Ratenbegrenzung: freigegebene Zähler für anfrage- und tokenbasierte Limits für alle Proxy-Replikate. Nur erforderlich, wenn die globale Ratenbegrenzung konfiguriert ist. | Der Ratenbegrenzungsdienst liest und erhöht die Zähler auf Port 6379 für jede begrenzte Anfrage. | Redis-Protokoll (6379). Redis 8.10 im Cluster bereitgestellt oder eine vorhandene Redis-Instanz. |
| Backends für die Modellbereitstellung (Ollama/vLLM) | Stellen Sie die offenen Gewichtungsmodelle hinter dem Gateway bereit, die mit dem begleitenden Leitfaden „Offene Gewichtungsmodelle in GDC mit Air Gap“ bereitgestellt wurden. Als AIServiceBackend (beliebiger OpenAI-kompatibler Service, z. B. Ollama) oder als InferencePool (Modellserver wie vLLM, die die Messwerte bereitstellen, anhand derer der Endpoint Picker die Bewertung vornimmt). |
Die weitergeleiteten Anfragen vom Proxy empfangen, die Inferenz auf den GPU-Knoten (oder auf der CPU für die funktionale Bewertung mit kleinen Modellen) ausführen und die OpenAI-kompatible Antwort zurückgeben. | OpenAI-kompatible REST API: vLLM auf Port 8000, Ollama auf Port 11434; Prometheus-Messwerte (vLLM) für die Endpunktauswahl. |
| Harbor | Speichert die Container-Images (Envoy-Proxy, Envoy-Gateway, Envoy-Agent-Router-Controller und externer Prozessor, Dienst zur Ratenbegrenzung, Endpoint Picker, Redis) und die Helm-Diagramme (OCI-Artefakte) der Lösung. | Artefakte werden mit seed_registry.sh (crane) von einer Workstation mit Internetzugriff aus den öffentlichen Registries in Harbor kopiert. Der Cluster ruft Images mit einem Robot-Konto über Image-Pull-Secrets ab und die Diagramme werden mit helm template aus Harbor gerendert. |
OCI Distribution API; Harbor-UI und Roboterkonten. |
| Standardcluster und GPU-Knoten | Hostet alle Gateway-Komponenten (CPU-Knoten sind ausreichend) und die Inferenz-Pods (GPU-Knoten mit den von den Knoten erkannten Beschleunigerressourcen). Stellt LoadBalancer VIPs, nichtflüchtigen Speicher für die Modellgewichtungen und die Erzwingung von Netzwerkrichtlinien bereit. |
Grundlegende Plattform; Anfragen werden über die LoadBalancer-VIP des Gateway gesendet und bleiben im Clusternetzwerk. |
Kubernetes API, GDC-Netzwerk-APIs (networking.gdc.goog/v1 ProjectNetworkPolicy), GDC-Konsole und gdcloud für den Plattformadministrator. |
Funktionen
Diese Referenzarchitektur bietet die folgenden Kernfunktionen:
- Einheitlicher OpenAI-kompatibler Endpunkt: Anwendungen rufen für jedes Modell, das hinter dem Gateway bereitgestellt wird, eine Adresse (
/v1/chat/completions,/v1/models, …) auf.- Komponenten:
Gateway,AIGatewayRoute, Envoy-Proxy, externer Prozessor. - Aufgaben: Bereitstellen einer stabilen virtuellen IP-Adresse, Beenden von TLS, Akzeptieren des OpenAI-kompatiblen Anfrageformats und bei Bedarf Übersetzen in das Backend-Schema.
- Schnittstellen: HTTPS REST (JSON, einschließlich vom Server gesendeter Ereignisse für Streaming).
- Komponenten:
- Textkörperbasiertes (modellbewusstes) Routing: Das Gateway liest das Feld
modeldes Anfragetexts und leitet die Anfrage ohne clientseitige Endpunktlogik an das entsprechende Backend weiter.- Komponenten: Externer Prozessor,
AIGatewayRoute-Regeln, die mitx-ai-eg-model,AIServiceBackend,InferencePoolübereinstimmen. - Aufgaben: Modellnamen extrahieren, Routenregeln abgleichen, Modelle umbenennen (
modelNameOverride), Traffic nach Gewichtung aufteilen und bei Bedarf auf alternative Backends nach Priorität zurückgreifen. - Schnittstellen: Kubernetes API (
aigateway.envoyproxy.io/v1beta1).
- Komponenten: Externer Prozessor,
- Modellserverbewusstes Load Balancing: Anfragen an einen
InferencePoolwerden an das Replikat mit der kürzesten Warteschlange und dem nützlichsten KV-Cache gesendet, anstatt Round Robin zu verwenden.- Komponenten: Gateway API Inference Extension (
InferencePool,InferenceObjective, Endpoint Picker). - Aufgaben: Modellserver-Messwerte abrufen, Endpunkte bewerten (Warteschlangenlänge, KV-Cache-Nutzung, Präfix-Cache-Affinität, LoRA-Adapter), Prioritäten pro Ziel unter Last berücksichtigen.
- Schnittstellen: Kubernetes API (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- Komponenten: Gateway API Inference Extension (
- Upstream-Authentifizierungs- und Sicherheitsrichtlinien: Anmeldedaten für Back-Ends, die diese benötigen, werden vom Gateway eingefügt und nie an die Anwendungen verteilt.
- Komponenten:
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, TLS-Listener. - Aufgaben: API-Schlüssel in die Back-Ends einfügen, Client-TLS am
Gatewaybeenden, Clientauthentifizierungs- und Autorisierungsrichtlinien bei Bedarf erzwingen. - Schnittstellen: Kubernetes-
Secrets, auf die die Richtlinien verweisen.
- Komponenten:
- Tokenbasierte Ratenbegrenzung (optional): Die Nutzung wird nicht nur in Anfragen, sondern auch in Tokens gemessen.
- Komponenten: Externer Prozessor (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(globale Ratenbegrenzung), Ratenbegrenzungsdienst, Redis. - Aufgaben: Eingabe-, Ausgabe- und Gesamttokens aus jeder Antwort extrahieren, als Anfragekosten anhängen, Budgets pro Nutzer oder pro Modell über alle Proxy-Replikate hinweg erzwingen.
- Schnittstellen: Kubernetes API, Redis (6379).
- Komponenten: Externer Prozessor (
- Traffic-Verwaltung: Für KI-Traffic gelten die Standardfunktionen der Gateway API.
- Komponenten:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Aufgaben: Host-, pfad- und headerbasierter Abgleich, Zeitlimits für lange Generierungen, Wiederholungsversuche, gewichtete Aufteilung des Traffics und prioritätsbasiertes Fallback zwischen Backends.
- Schnittstellen: Kubernetes API.
- Komponenten:
- Beobachtbarkeit: Für jedes Modell sind Messwerte zu Anfragen, Latenz und Tokens verfügbar.
- Komponenten: Envoy-Proxy-Zugriffslogs und ‑Statistiken, Messwerte für externe Prozessoren (Tokennutzung, Anfragedauer, Zeit bis zum ersten Token), Messwerte für die Endpunktauswahl.
- Verantwortlichkeiten: Bereitstellung von Messwerten im Prometheus-Format und strukturierten Zugriffslogs, die vom GDC-Beobachtbarkeits-Stack oder einem vom Kunden verwalteten Prometheus-System erfasst werden können.
- Schnittstellen: Prometheus-Messwertendpunkte, Standardausgabe-Logs.
- Artefaktverwaltung mit Air Gap: Jedes Image und Diagramm wird vor der Installation in Harbor bereitgestellt.
- Komponenten: Harbor,
seed_registry.sh, Roboterkonten, Image-Pull-Secrets,EnvoyProxy-Ressource (Proxy-Image und Pull-Secret). - Aufgaben: Images und OCI-Helm-Diagramme von einer verbundenen Workstation aus bereitstellen, Versionen anpinnen, Diagramme offline mit
helm templaterendern. - Schnittstellen: OCI Distribution API, Kubernetes API.
- Komponenten: Harbor,
Architekturprinzipien
- Standards First: Das Gateway wird über die Kubernetes Gateway API und die zugehörige Inferenz-Erweiterung konfiguriert und kommuniziert mit Anwendungen über die OpenAI-kompatible API. So bleiben Anwendungen, Routen und Backends über Gateway-Implementierungen hinweg portierbar.
- Sicherheit an erster Stelle: Alle Komponenten und Daten befinden sich innerhalb der GDC mit Air Gap-Grenze. TLS-Terminierung erfolgt am
Gateway, Backend-Anmeldedaten werden vom Gateway eingeschleust und der Netzwerkzugriff wird mitNetworkPolicy- undProjectNetworkPolicy-Objekten eingeschränkt. - Datenhoheit: Prompts, Antworten, Modellgewichtungen und Nutzungsdaten verlassen nie die GDC-Organisation des Kunden. Für den Betrieb ist keine externe Verbindung erforderlich.
- Trennung von Zuständigkeiten: Mit der rollenbasierten Gateway API kann der Plattformadministrator die
GatewayClass,Gateway, TLS- und Netzwerkrichtlinien verwalten, während Anwendungsteams ihreAIGatewayRoute-,AIServiceBackend- undInferencePool-Ressourcen in ihren eigenen Namespaces verwalten. - Entkoppelte Steuerungs- und Datenebene: Controller übersetzen nur die Konfiguration. Der Anfragepfad besteht aus dem Envoy-Proxy, seinem externen Prozessor-Sidecar und dem Endpoint Picker, die weiterhin Traffic verarbeiten, wenn ein Controller neu gestartet wird.
- Offen und flexibel: Die Architektur verwendet durchgängig Open-Source-Software (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM) und dieselben Gateway API-Ressourcen können von alternativen Implementierungen bereitgestellt werden.
- Skalierbarkeit und Leistung: Die Datenebene wird horizontal durch Hinzufügen von Proxy-Replikaten und vertikal durch Anpassen von CPU und Arbeitsspeicher skaliert. Durch das Load Balancing, das den Modellserver berücksichtigt, werden die GPUs ausgelastet, ohne einzelne Replikate zu überlasten.
- Vereinfachte Endnutzererfahrung: Ein Endpunkt, ein API-Format und ein Satz von Anmeldedaten für jedes Modell verkürzen den Weg von der Modellbereitstellung bis zur Nutzung.
- Ausfallsicherheit: Kubernetes-Systemdiagnosen und -Replikation, Envoy-Wiederholungsversuche und prioritätsbasiertes Fallback zwischen Back-Ends sorgen dafür, dass der Endpunkt verfügbar bleibt, wenn einzelne Modellreplikate ausfallen.
Hinweise
- Skalierbarkeit und Leistung:
- Die Gateway-Komponenten sind reine CPU-Arbeitslasten. Der Envoy-Proxy
DeploymenteinesGatewaywird horizontal skaliert, indem die Anzahl der Replikate (EnvoyProxy-Ressource) erhöht wird, und vertikal, indem die CPU- und Arbeitsspeicheranfragen erhöht werden. Die Prüfung des Textes durch den externen Prozessor kostet CPU-Leistung proportional zur Anfrage- und Antwortgröße. Gestreamte Antworten werden inkrementell verarbeitet. - Das Modell-Server-bewusste Load Balancing gilt nur für Backends, die als
InferencePoolangehängt sind. Backends, die alsAIServiceBackendangehängt sind, werden vom Proxy über die Endpunkte ihrerServiceverteilt. - Das Gateway fügt keine GPU-Kapazität hinzu. Durchsatz und Latenz sind durch die Modellserver begrenzt. Dimensionieren Sie die Modellbereitstellungen mit dem Begleitset (vLLM für hohen Durchsatz, Ollama für einfache Nutzung und reine CPU-Bewertung).
- Lange Generierungen erfordern längere Anfrage- und Inaktivitätszeitlimits als typische HTTP-APIs. Konfigurieren Sie diese in den Routen und Richtlinien und nicht auf den Clients.
- Die Gateway-Komponenten sind reine CPU-Arbeitslasten. Der Envoy-Proxy
- Ressourcenverwaltung:
- Alle Gateway-Komponenten werden auf CPU-Knoten ausgeführt und benötigen keinen Beschleuniger. Die folgende Tabelle enthält Richtwerte für die Größe einer funktionalen Bereitstellung. In der Referenzimplementierung werden die genauen Anfragen und Limits festgelegt. Die Produktionswerte hängen von der Anforderungsrate und der Nutzlastgröße ab.
- In der folgenden Porttabelle sind alle Ports aufgeführt, die die Netzwerkrichtlinien zulassen müssen.
- Die GPU-Planung gehört zu den Modellbereitstellungen: Die Namen der Beschleunigerressourcen werden von den Knoten ermittelt, wie im zugehörigen Leitfaden beschrieben.
Richtwerte für die Dimensionierung der Gateway-Komponenten (nur CPU)
| Komponente | Replikate | CPU (Anfrage) | Arbeitsspeicher (Anfrage) | Hinweise |
|---|---|---|---|---|
| Envoy Gateway-Controller | 1 | 100–500 Mio. | 256 Mi–1 Gi | Steuerungsebene; nicht im Anfragepfad |
| Envoy Agent Router-Controller | 1 | 100–500 Mio. | 256 Mi–512 Mi | Steuerungsebene und Erweiterungsserver |
Envoy-Proxy Pod (Proxy + externer Prozessor-Sidecar) |
1–2 pro Gateway |
500 m–2 | 512Mi–2Gi | Skalierung mit Anforderungsrate und Nutzlastgröße |
| Endpunktauswahl | 1 pro InferencePool |
100–500 Mio. | 256 Mi–512 Mi | Ruft die Modellserver-Messwerte ab. |
| Dienst zur Ratenbegrenzung (optional) | 1 | 100–500 Mio. | 256 Mi–512 Mi | Nur mit globaler Ratenbegrenzung |
| Redis (optional) | 1 | 100–500 Mio. | 256 Mi–1 Gi | Nur mit globaler Ratenbegrenzung |
Netzwerkports
| Port | Komponente | Zweck |
|---|---|---|
| 80 / 443 | Envoy-Proxy (Gateway-Listener) |
HTTP-/HTTPS-Einstiegspunkt auf der VIP LoadBalancer |
| 1063 | Envoy-Agent-Router-Controller (Erweiterungsserver) | gRPC-Aufrufe vom Envoy Gateway-Erweiterungsmanager |
| 9002 | Endpunktauswahl | ext_proc-gRPC-Aufrufe vom Envoy-Proxy |
| 6379 | Redis | Zähler für Ratenbegrenzungen |
| 8000 | vLLM | OpenAI-kompatible API und Messwerte des Modellservers |
| 11434 | Ollama | Ollama- und OpenAI-kompatible API des Modellservers |
- Verfügbarkeit und Zuverlässigkeit:
- Der Proxy und der externe Prozessor werden im selben
Podausgeführt. Mehrere Replikate hinter derService-LoadBalancermaskieren einzelnePod-Fehler und die Controller können ohne Unterbrechung des Traffics neu gestartet werden. AIGatewayRoute-Regeln können mehrere Backends mit Prioritäten auflisten, sodass das Gateway auf ein anderes Replikatset oder einen anderen Modell-Server zurückgreift, wenn ein Backend fehlerhaft ist.- Die Endpunktauswahl ist ein
Deploymentpro Pool. Wenn sie nicht verfügbar ist, schlagen Anfragen an diesenInferencePoolfehl, bis sie wieder verfügbar ist. Führen Sie sie mit Ressourcenanfragen und Bereitschaftsprüfungen aus und überwachen Sie sie wie eine Komponente der Datenebene. - Redis enthält nur Zähler für die Ratenbegrenzung. Ein Redis-Ausfall wirkt sich auf die Ratenbegrenzung aus, nicht auf das Routing.
- Der Proxy und der externe Prozessor werden im selben
- Operative Komplexität:
- Versionsabgleich zwischen Envoy Gateway, Envoy Agent Router und der Gateway API Inference Extension: Aktualisieren Sie die drei zusammen mit der getesteten Kombination (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, Gateway API Inference Extension 1.5.0).
- Air-Gap-Lebenszyklus: Jedes Image und Diagramm wird bei jedem Upgrade neu in Harbor eingefügt. Die Ressource
EnvoyProxyund die Diagrammwerte pinnen die Registry und das Pull-Secret an. - Zwei Konfigurationsebenen: Plattform-eigene
GatewayClass/Gateway/EnvoyProxyund Team-eigeneAIGatewayRoute/AIServiceBackend/InferencePool. Das Onboarding eines neuen Modells bedeutet, dass eine Routingregel und ein Backend hinzugefügt werden, nicht ein neues Gateway. - Monitoring: Anforderungsrate, Latenz (einschließlich Zeit bis zum ersten Token), Tokennutzung pro Modell und pro Nutzer, Endpoint Picker-Bewertung und GPU-Auslastung der Modellserver.
InferenceObjectiveist noch eine Alpha-API (v1alpha2). Zwischen den Releases der Inference Extension sind Schemaänderungen zu erwarten.
- Sicherheit und Compliance:
- Die gesamte Lösung wird innerhalb des Sicherheitsperimeters von GDC mit Air Gap ausgeführt.
- Netzwerkrichtlinien sind obligatorisch: Ein Namespace
NetworkPolicylässt Traffic vom Proxy zu den Modell-Server-Ports (8000, 11434) und zum Endpoint Picker (9002) zu. EinProjectNetworkPolicylässt Client-Traffic zurLoadBalancer-VIP zu, wenn sich die Nutzer außerhalb des Projekts befinden. - Die TLS-Terminierung erfolgt am
Gatewaymit einem Zertifikat, das in einem Kubernetes-Secretgespeichert ist. Clients sehen nur den Gateway-Endpunkt. - Upstream-Anmeldedaten (z. B. ein von einem Modellserver erforderlicher API-Schlüssel) werden in
Secrets gespeichert, auf die von einemBackendSecurityPolicyverwiesen wird, und vom Gateway eingefügt, sodass Anwendungen nie Backend-Anmeldedaten enthalten. - Die tokenbasierte Ratenbegrenzung begrenzt den Verbrauch teurer GPU-Kapazität pro Nutzer oder pro Modell.
- Harbor-Roboterkonten und Kubernetes-Image-Pull-Secrets sorgen für sicheren Zugriff auf Container-Images. Die rollenorientierte Gateway API-RBAC trennt die Verantwortlichkeiten für Plattform und Anwendung.
Designentscheidungen
Für diese Referenzarchitektur wurden die folgenden wichtigen Designentscheidungen getroffen:
Entscheidung 1: Implementierung des KI-Gateways: Open-Source-Envoy-Agent-Router auf Envoy Gateway im Vergleich zu alternativen Distributionen
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Das KI-Gateway ist die primäre Architekturoption mit praktikablen Alternativen, von selbstverwalteten Open-Source-Optionen bis hin zu kommerziell unterstützten Angeboten: (a) Envoy Agent Router auf Envoy Gateway (Open Source), (b) kgateway und agentgateway (Open-Source-Gateway-API-Implementierungen, die auch LLM-Anbieter-Traffic, MCP-Tools und die Kommunikation zwischen Agenten in einer Datenebene verarbeiten, optional mit Anbieterunterstützung von solo.io), (c) Solo Enterprise für agentgateway als kommerziell unterstützte Premium-Option. | Die Referenzimplementierung verwendet den Open-Source-Envoy-Agent-Router auf Envoy Gateway. Die Alternativen bleiben gültige Optionen hinter denselben Gateway API-Ressourcen. Für Produktionsumgebungen, die dedizierten Herstellersupport erfordern, wird eine kommerziell unterstützte Distribution empfohlen. | Vorteile von Open Source: schlank und standardkonform, leistungsstarkes L7-Routing, keine Lizenzgebühren, ideal zur Evaluierung der Lösung, bevor Sie sich für ein kostenpflichtiges Angebot entscheiden. Envoy Agent Router ist die in diesem Leitfaden validierte Option. Nachteile von Open Source: Der Support erfolgt auf Best-Effort-Basis durch das Solutions-Team und die Community, was für wichtige Produktionsumgebungen möglicherweise nicht ausreicht. Premium-Vorteile: Enterprise-Supportvereinbarungen für den Gateway-Lebenszyklus und oft erweiterte agentische Funktionen. Nachteile von Premium: kostenpflichtige Lizenzierung oder Supportvereinbarung und eine zusätzliche Anbieterbeziehung. |
Entscheidung 2: Kubernetes Gateway API mit der Inferenz-Erweiterung im Vergleich zu Ingress oder einer proprietären Gateway API
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Inferenzendpunkte können mit der Legacy-Ingress API, einem Gateway-spezifischen Konfigurationsformat oder der Kubernetes Gateway API bereitgestellt werden. Für das modellbasierte Load Balancing ist außerdem eine Möglichkeit erforderlich, Modellserverpools und ihre Prioritäten zu beschreiben. | Die Lösung standardisiert auf der Kubernetes Gateway API (GatewayClass, Gateway, Routen), die von Envoy Gateway implementiert wird, und auf der Gateway API Inference Extension (InferencePool, InferenceObjective, Endpoint Picker) für modellbewusstes Routing. |
Die Gateway API ist der Kubernetes-Standard, der Ingress ablöst. Sie ist rollenorientiert (Plattform- und Anwendungsteams) und kann über Implementierungen hinweg verwendet werden. Die Inference Extension ist der Community-Standard für Modell-Server-bewusstes Routing (Warteschlangentiefe, KV-Cache, Prioritäten) und wird vom Envoy Agent Router standardmäßig unterstützt. Die alternativen Gateway-Distributionen implementieren dieselben APIs, sodass Entscheidung 1 umkehrbar bleibt. |
Entscheidung 3: Textkörperbasiertes Routing im Feld model von OpenAI-kompatiblen Anfragen als einheitlicher Endpunkt
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
Anwendungen können Modelle über einen Endpunkt pro Modell (host- oder pfadbasiert), über einen benutzerdefinierten Header, der vom Client festgelegt wird, oder über das Feld model ansprechen, das jede OpenAI-kompatible Anfrage bereits enthält. |
Das Gateway stellt einen OpenAI-kompatiblen Endpunkt bereit und leitet Anfragen basierend auf dem Feld model weiter: Der externe Prozessor extrahiert es in den Header x-ai-eg-model und die AIGatewayRoute-Regeln werden auf diesen Header angewendet. |
Vorhandene OpenAI-kompatible Clients und SDKs funktionieren unverändert und wechseln Modelle durch Ändern eines Strings. Endpunkte, Anmeldedaten und Modellplatzierung können sich ändern, ohne dass Anwendungen angepasst werden müssen. Mit denselben Regeln kann ein Modellname mehreren Backends für die Aufteilung des Traffics, Fallback oder Modellnamenüberschreibungen zugeordnet werden. |
Entscheidung 4: Air-Gap-Artefakt-Seeding in Harbor im Vergleich zu On-Demand-Abrufen
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Bei der Upstream-Installation werden Container-Images aus öffentlichen Registries und Helm-Diagramme als OCI-Artefakte bei Bedarf abgerufen. Dies ist in einer Umgebung mit Air Gap nicht möglich. | Alle Container-Images (Envoy-Proxy, Envoy Gateway, Envoy Agent Router-Controller und externer Prozessor, Rate Limit-Dienst, Endpoint Picker, Redis) und die Envoy Gateway- und Envoy Agent Router-Helm-Diagramme werden mit seed_registry.sh (crane) in ein Harbor-Projekt eingefügt. Diagramme werden offline mit helm template aus Harbor gerendert und die EnvoyProxy-Ressource und die Diagrammwerte pinnen die Harbor-Registry und das Pull-Secret an. |
Ein wiederholbarer, prüfbarer Seeding-Schritt pro Version; der Cluster benötigt nie eine externe Verbindung; durch das Anpinnen von Versionen werden Upgrades explizit und umkehrbar. |
Entscheidung 5: Optionale tokenbasierte Ratenbegrenzung mit Redis im Vergleich zu nur anfragebasierten Limits
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Die GPU-Kapazität wird pro Token und nicht pro Anfrage verbraucht. Ein Limit für die Anzahl der Anfragen kann ein freigegebenes Modell nicht vor einigen sehr großen Prompts oder langen Generierungen schützen. Für die globale Ratenbegrenzung in Envoy Gateway ist ein freigegebener Zählerspeicher erforderlich. | Die tokenbasierte Ratenbegrenzung ist ein optionales Feature der Architektur: Der externe Prozessor zeichnet Eingabe-, Ausgabe- und Gesamttokens pro Anfrage (llmRequestCosts) auf, ein BackendTrafficPolicy erzwingt das Budget und eine Redis-Instanz (Redis 8.10, im Cluster bereitgestellt oder eine vorhandene Instanz) speichert die Zähler. Für Bereitstellungen ohne Ratenbegrenzung ist Redis nicht erforderlich. |
Die Nutzung wird in der Einheit gemessen, die die Kosten widerspiegelt, Budgets werden für alle Proxy-Replikate einheitlich durchgesetzt und die Abhängigkeit wird nur von Kunden bezahlt, die Kontingente benötigen. |
Entscheidung 6: Topologie: Gateway-Steuerung und Datenebene in einem dedizierten Namespace eines Standardclusters, Modelle in Anwendungs-Namespaces
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Das Gateway kann in einem dedizierten Cluster, in jedem Anwendungs-Namespace oder einmal pro Standardcluster neben den Modellen ausgeführt werden, die es bereitstellt. Offene Gewichtungsmodelle in GDC mit Air Gap werden in Standardclustern bereitgestellt (Begleitleitfaden). | Die Envoy Gateway- und Envoy Agent Router-Steuerungsebene sowie die Envoy-Proxy-Datenebene werden in einem dedizierten Namespace des Standardclusters ausgeführt, der die Modelle hostet. AIGatewayRoute, AIServiceBackend, InferencePool und die Modellbereitstellungen befinden sich in den Anwendungs-Namespaces und werden über Namespaces hinweg referenziert. |
Anfragen bleiben im Clusternetzwerk zwischen dem Proxy und den Pods des Modells (niedrigste Latenz, keine zusätzlichen Load Balancer). Der Plattformadministrator ist Inhaber des Gateway-Namespace, während die Anwendungsteams Inhaber ihrer Routen und Modelle sind. Der Endpoint Picker kann die Modellserver direkt scrapen. Ein projektbezogenes Client-Gateway, das an ein zentrales Server-Gateway weiterleitet, bleibt eine Erweiterung dieser Topologie für die Nutzung in mehreren Projekten. |
Annahmen und Einschränkungen
- Die GDC mit Air Gap-Umgebung ab Version 1.16.2-hf1 ist mit einem Standardcluster verfügbar, auf dem Kubernetes ab Version 1.32.13-gke.400 ausgeführt wird.
- Für die Modellbereitstellungs-Backends sind ausreichende Hardwareressourcen (insbesondere GPUs) vorhanden. Die Gateway-Komponenten selbst werden auf CPU-Knoten ausgeführt. Echte Modelle benötigen GPUs. Kleine Modelle in Ollama können nur zur funktionalen Bewertung auf der CPU ausgeführt werden.
- Die Harbor-Instanz ist eingerichtet und zugänglich. Eine Workstation mit Internetzugriff und Verbindung zur GDC-Umgebung (Harbor- und Kubernetes API) ist für das Seeding von Images und Diagrammen verfügbar.
- Nutzer haben die erforderlichen Berechtigungen: Projekrollen „Harbor Instance Viewer“ und „Standard Cluster Admin“ sowie eine
StandardClusterRoleBindingfür die Rollecluster-adminim Standardcluster für die clusterbezogene Installation (CRDs,GatewayClass, Namespaces). Weitere Informationen finden Sie in der Referenzimplementierung. - Die Backends für die Modellbereitstellung stellen eine OpenAI-kompatible API bereit. Backends, die als
InferencePoolangehängt sind, stellen auch die vLLM-kompatiblen Messwerte bereit, auf die sich die Endpunktauswahl stützt. - Einschränkung: Der Support für die Open-Source-Komponenten (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension) erfolgt nach bestem Wissen und Gewissen durch das Solutions-Team. Für dedizierten Herstellersupport ist eine kommerziell unterstützte Distribution erforderlich (Entscheidung 1).
- Einschränkung:
InferenceObjectiveist eine Alpha-API (inference.networking.x-k8s.io/v1alpha2) und kann sich zwischen den Releases der Inference Extension ändern. - Einschränkung: Für Nutzer außerhalb des Projekts sind eine
LoadBalancer-VIP für dieGatewayund einProjectNetworkPolicyerforderlich. Innerhalb des Projekts können clusterinterne Clients oderkubectl port-forwarddas GatewayServicedirekt erreichen. - Einschränkung: Gemini on GDC, Modellfeinabstimmung, GenAI-Modelle, die keine LLMs sind, und die Modellbereitstellung auf mehreren Knoten werden in dieser Version der Lösung nicht unterstützt.
User-Flow
Im Folgenden finden Sie einen umfassenden User-Flow für das KI-Gateway in GDC mit Air Gap: zuerst den Anfragepfad, den ein Anwendungsentwickler verwendet, und dann den Einrichtungspfad, den der Plattformadministrator verwendet.
1. Anfragepfad für Entwickler
Eine Anwendung oder ein Agent benötigt nur den Gateway-Endpunkt, Clientanmeldedaten, falls das Gateway diese erzwingt, und den Modellnamen.
- Anfrage senden: Die Anwendung ruft
POST /v1/chat/completionsam Gateway-Endpunkt mit einem OpenAI-kompatiblen JSON-Text auf, der das Modell (z. B."model": "gemma") benennt, genau wie sie einen OpenAI-kompatiblen Dienst aufrufen würde. - Gateway aufrufen: Die Anfrage erreicht die
LoadBalancer-VIP desGateway. Der Envoy-Proxy beendet TLS und gleicht den Listener und die Route ab. - Text verarbeiten: Der Proxy übergibt die Anfrage an den externen Prozessor des Envoy Agent Routers. Dieser parst den Text, extrahiert den Modellnamen in den Header
x-ai-eg-modelund übersetzt die Nutzlast in das Backend-Schema, falls es sich unterscheidet. - Backend auswählen: Die
AIGatewayRoute-Regel, die mit dem Modellnamen übereinstimmt, wählt einenAIServiceBackend(z. B. den Ollama-Service) oder einenInferencePool(z. B. ein vLLM-Replikatset) aus. Bei einemInferencePoolwählt die Endpunktauswahl das Replikat mit der kürzesten Warteschlange und der besten KV-Cache-Übereinstimmung aus. - Weiterleiten und antworten: Der Proxy fügt Upstream-Anmeldedaten ein, wenn eine
BackendSecurityPolicygilt, leitet die Anfrage an die ausgewähltePodweiter, streamt die Antwort zurück und lässt den externen Prozessor die Tokennutzung aufzeichnen. Diese Daten fließen in die Messwerte und, falls konfiguriert, in das tokenbasierte Ratenlimit ein. - Modelle wechseln: Um ein anderes Modell zu verwenden, ändert der Entwickler den String
model. Es ist kein neuer Endpunkt, keine neuen Anmeldedaten und keine neue Clientbibliothek erforderlich.
2. Einrichtungspfad für Plattformadministratoren
- Artefakte in Harbor einfügen: Erstellen Sie die Harbor-Robot-Konten und kopieren Sie dann die Container-Images und die Envoy Gateway- und Envoy Agent Router-Helm-Diagramme mit
seed_registry.shvon einer Workstation mit Internetzugriff in Harbor. - Envoy Gateway installieren: Rendern Sie die CRD- und Controller-Diagramme aus Harbor mit
helm templateund wenden Sie sie im Gateway-Namespace an. Erstellen Sie die RessourceEnvoyProxy, die das Proxy-Image und das Pull-Secret anpinnt, und prüfen Sie den Controller mit einer einfachenGatewayClass,GatewayundHTTPRoute. - Envoy Agent Router installieren: Installieren Sie die Envoy Agent Router-CRDs und die Gateway API Inference Extension-CRDs, stellen Sie den Envoy Agent Router-Controller bereit und konfigurieren Sie Envoy Gateway neu, um den Erweiterungsserver (Port 1063) aufzurufen und
InferencePool-Backends zu akzeptieren. Stellen Sie optional Redis bereit und aktivieren Sie den globalen Dienst zur Ratenbegrenzung. - Gateway freigeben: Erstellen Sie die
GatewayClassund dieGatewaymit HTTP- und HTTPS-Listenern (TLS-ZertifikatSecret), warten Sie auf dieLoadBalancer-VIP und wenden Sie dieProjectNetworkPolicyfür Nutzer außerhalb des Projekts an. - Modelle anhängen: Stellen Sie die Modellbereitstellungs-Backends mit dem Begleitset bereit und erstellen Sie dann
AIServiceBackend-Ressourcen für OpenAI-kompatibleServices undInferencePoolsowie Endpoint Picker-Ressourcen für vLLM-kompatible Replikatgruppen zusammen mit den Namespace-NetworkPolicy-Objekten. - Route veröffentlichen: Erstellen Sie die
AIGatewayRoutemit einer Regel pro Modellname (body-basiertes Routing) und, falls erforderlich,BackendSecurityPolicy- undBackendTrafficPolicy-Objekte für Upstream-Anmeldedaten und Tokenbudgets. - Validieren und betreiben: Rufen Sie
/v1/modelsund/v1/chat/completionsüber die VIP (oder einenkubectl port-forward-Fallback) auf, prüfen Sie die Messwerte für Proxy, externen Prozessor und Endpoint Picker und übergeben Sie die Endpunkt- und Modellnamen an die Anwendungsteams. Skalieren Sie Proxy-Replikate und Modellbereitstellungen unabhängig voneinander. Aktualisieren Sie Envoy Gateway, Envoy Agent Router und die Inferenz-Erweiterung gemeinsam.
Eine detaillierte Anleitung finden Sie in der Referenzimplementierung für den Envoy-Agent-Router und im Nutzerhandbuch für textkörperbasiertes Routing mit dem Envoy-Agent-Router.
Zusätzliche Materialien
- Referenzimplementierung für Envoy Agent Router
- Nutzerhandbuch für textkörperbasiertes Routing mit Envoy Agent Router
- Referenzarchitektur für LLMs mit offenen Gewichtungen
- Dokumentation zum Envoy Agent Router
- Envoy Gateway
- Kubernetes Gateway API
- Gateway API Inference Extension
- Dokumentation zu Google Distributed Cloud mit Air Gap