


In diesem Leitfaden wird der konzeptionelle Kontext beschrieben, der für die Bereitstellung einer auf einer virtuellen Maschine (VM) basierenden Arbeitslast in einem GDC-Cluster (Google Distributed Cloud) mit Air Gap auf Bare Metal mithilfe einer VM-Laufzeit erforderlich ist. Die Arbeitslast in diesem Leitfaden ist eine Beispielplattform für ein Ticketsystem, die auf lokaler Hardware verfügbar ist.
Architektur
Ressourcenhierarchie
In GDC stellen Sie die Komponenten, aus denen das Ticketsystem besteht, in einer dedizierten Mandantenorganisation für das Operations-Team bereit, die mit jeder Kundenorganisation identisch ist. Eine Organisation ist eine Sammlung von Clustern, Infrastrukturressourcen und Anwendungsworkloads, die zusammen verwaltet werden. Jede Organisation in einer GDC-Instanz verwendet einen dedizierten Satz von Servern, was eine starke Isolation zwischen Mandanten ermöglicht. Weitere Informationen zur Infrastruktur finden Sie unter Zugriffsgrenzen entwerfen.
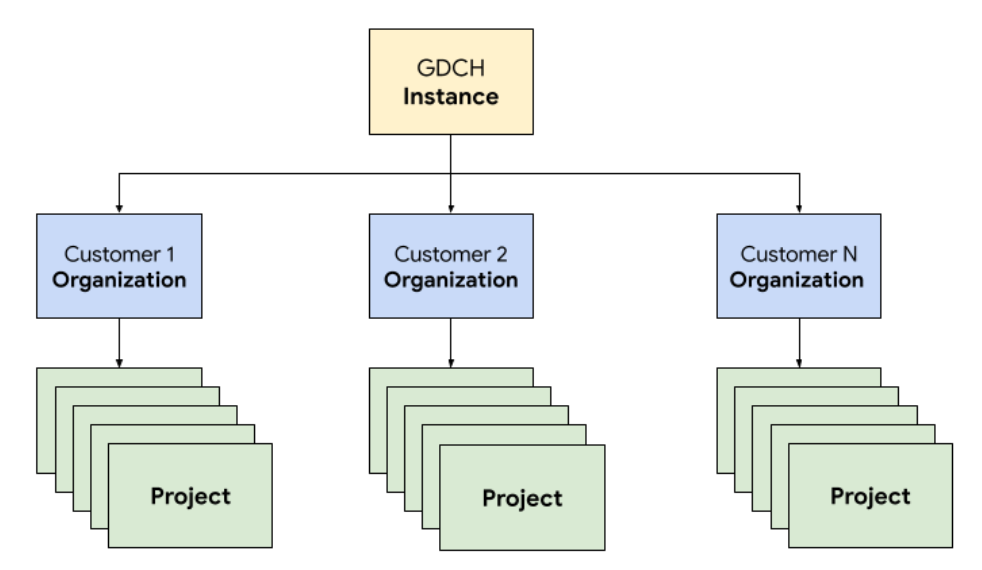
Außerdem stellen Sie die Ressourcen des Ticketsystems gemeinsam in einem Projekt bereit und verwalten sie. Dadurch wird eine logische Isolation innerhalb einer Organisation mithilfe von Softwarerichtlinien und -erzwingung ermöglicht. Ressourcen in einem Projekt sollen Komponenten verbinden, die während ihres Lebenszyklus zusammenbleiben müssen.
Das Ticketsystem basiert auf einer dreistufigen Architektur, bei der ein Load Balancer den Traffic auf Anwendungsserver verteilt, die mit einem Datenbankserver verbunden sind, auf dem persistente Daten gespeichert werden.
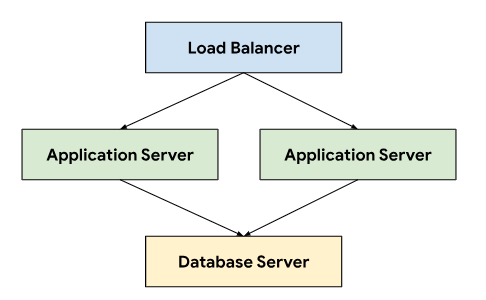
Diese Architektur ermöglicht Skalierbarkeit und Wartbarkeit, da jede Ebene unabhängig entwickelt und gewartet werden kann. Außerdem bietet es eine klare Trennung der Zuständigkeiten, was das Debugging und die Fehlerbehebung vereinfacht. Durch die Kapselung dieser Ebenen in einem GDC-Projekt können Sie Komponenten wie Anwendungs- und Datenbankserver gemeinsam bereitstellen und verwalten.
Netzwerk
Für die Ausführung des Ticketsystems in einer Produktionsumgebung müssen mindestens zwei Anwendungsserver bereitgestellt werden, um im Falle eines Knotenausfalls Hochverfügbarkeit zu erreichen. In Kombination mit einem Load Balancer ermöglicht diese Topologie auch die Verteilung der Last auf mehrere Maschinen, um die Anwendung horizontal zu skalieren. Die Kubernetes-native Plattform von GDC verwendet Cloud Service Mesh, um Traffic sicher an die Anwendungsserver weiterzuleiten, die das Ticketsystem bilden.
Cloud Service Mesh ist eine Implementierung von Google, die auf dem Open-Source-Projekt basiert, mit dem Dienste verwaltet, beobachtet und gesichert werden. Die folgenden Features von Cloud Service Mesh werden zum Hosten des Ticketsystems in GDC verwendet:
- Load Balancing: Cloud Service Mesh entkoppelt den Trafficfluss von der Infrastrukturskalierung und ermöglicht so viele Trafficverwaltungsfunktionen, einschließlich dynamischem Anfrage-Routing. Das Ticketsystem erfordert persistente Clientverbindungen. Daher aktivieren wir Sticky Sessions mit
DestinationRules, um das Traffic-Routing-Verhalten zu konfigurieren.
TLS-Terminierung: Cloud Service Mesh stellt Ingress-Gateways mithilfe von TLS-Zertifikaten bereit und bietet Transportauthentifizierung innerhalb des Clusters über mTLS (Mutual Transport Layer Security), ohne dass Anwendungscode geändert werden muss.
Wiederherstellung nach Fehlern: Cloud Service Mesh bietet einige wichtige Features zur Wiederherstellung nach Fehlern, darunter Zeitüberschreitungen, Unterbrechungen der Netzwerkverbindung, aktive Systemdiagnosen und begrenzte Wiederholungsversuche.
Im Kubernetes-Cluster verwenden wir standardmäßige Service-Objekte als abstrakte Möglichkeit, die Anwendungs- und Datenbankserver im Netzwerk verfügbar zu machen. Dienste bieten eine bequeme Möglichkeit, Zielinstanzen mithilfe eines Selektors anzusprechen und die Namensauflösung innerhalb des Clusters mithilfe eines clusterfähigen DNS-Servers bereitzustellen.
apiVersion: v1
kind: Service
metadata:
  name: http-ingress
spec:
  selector:
    app.kubernetes.io/component: application-server
  ports:
  - name: http
    port: 80
---
apiVersion: v1
kind: Service
metadata:
  name: database-ingress
spec:
  selector:
    app.kubernetes.io/component: database-server
  ports:
  - name: mysql
    port: 3306
Compute
Das Ticketingsystem empfiehlt, entweder Bare-Metal- oder virtuelle Maschinen für das Hosting von lokalen Installationen zu verwenden. Wir haben die GDC Virtual VM-Verwaltung genutzt, um sowohl die Anwendungs- als auch die Datenbankserver als VM-Arbeitslasten bereitzustellen. Durch die Definition von Kubernetes-Ressourcen konnten wir sowohl VirtualMachine als auch VirtualMachineDisk angeben, um Ressourcen an unsere Anforderungen für die verschiedenen Servertypen anzupassen. Mit VirtualMachineExternalAccess können wir die eingehende und ausgehende Datenübertragung für die VM konfigurieren.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineDisk
metadata:
  name: vm1-boot-disk
spec:
  size: 100G
  source:
    image:
      name: ts-ticketing-system-app-server-2023-08-18-203258
      namespace: vm-system
---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachine
metadata:
  labels:
    app.kubernetes.io/component: application-server
  name: vm1
  namespace: support
spec:
  compute:
    vcpus: 8
    memory: 12G
  disks:
  - boot: true
    virtualMachineDiskRef:
      name: vm1-boot-disk

---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineExternalAccess
metadata:
  name: vm1
  namespace: support
spec:
  enabled: true
  ports:
   - name: ssh
     protocol: TCP
     port: 22
Für das Gastbetriebssystem-Image haben wir ein benutzerdefiniertes Image erstellt, das unseren Compliance- und Sicherheitsanforderungen entspricht. Die Verbindung zu laufenden VM-Instanzen ist über SSH mit dem VirtualMachineAccessRequest möglich. Dadurch können wir die Möglichkeit, eine Verbindung zu VMs herzustellen, über Kubernetes RBAC einschränken und die Erstellung lokaler Nutzerkonten in den benutzerdefinierten Images vermeiden. In der Zugriffsanfrage wird auch eine Gültigkeitsdauer (TTL) definiert, die zeitbasierte Zugriffsanfragen zur Verwaltung der VMs ermöglicht, die automatisch ablaufen.
Automatisierung
Als wichtige zu erbringende Leistung für dieses Projekt haben wir einen Ansatz entwickelt, mit dem Instanzen des Ticketsystems wiederholbar installiert werden können. Dies ermöglicht eine umfassende Automatisierung und reduziert Konfigurationsabweichungen zwischen Bereitstellungen.
Release-Pipeline
Zum Anpassen der Anwendungs- und Datenbankserver-Images wird ein Basis-Betriebssystem-Image verwendet. Dieses Basis-Image wird nach Bedarf geändert, um die für jedes Server-Image erforderlichen Abhängigkeiten zu installieren. Wir haben ein Basis-Betriebssystem-Image ausgewählt, das häufig zum Hosten von Ticketsystemen in lokalen Installationen verwendet wird. Dieses Basis-Betriebssystem-Image bietet auch Sicherheitsfunktionen, die für die Einhaltung der Security Technical Implementation Guides (STIGs) erforderlich sind, um ein konformes Image zu liefern, das den NIST-800-53-Kontrollen entspricht.
In unserer CI-Pipeline (Continuous Integration) wurde der folgende Workflow verwendet, um Anwendungs- und Datenbankserver-Images anzupassen:
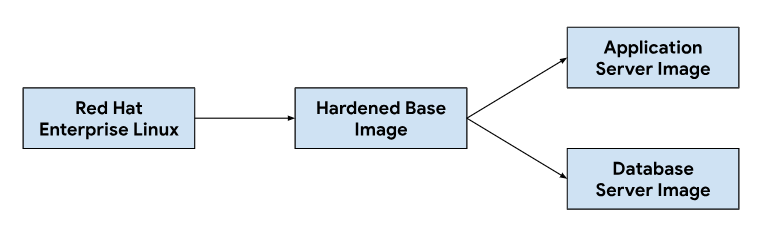
Wenn Entwickler Änderungen an den Anpassungsskripts oder Image-Abhängigkeiten vornehmen, wird in unseren CI-Tools ein automatisierter Workflow ausgelöst, um einen neuen Satz von Images zu generieren, die mit GDC-Releases gebündelt werden. Im Rahmen der Image-Erstellung aktualisieren wir auch die Betriebssystemabhängigkeiten (yum update) und komprimieren das Image, um die Image-Größe zu reduzieren, die für die Übertragung von Images in Kundenumgebungen erforderlich ist.
Software-Entwicklungszyklus
Der Softwareentwicklungs-Lebenszyklus (Software Development Life Cycle, SDLC) ist ein Prozess, der Organisationen bei der Planung, Erstellung, beim Testen und bei der Bereitstellung von Software unterstützt. Durch die Einhaltung eines klar definierten Softwareentwicklungs-Lebenszyklus können Unternehmen sicherstellen, dass Software konsistent und wiederholbar entwickelt wird, und potenzielle Probleme frühzeitig erkennen. Zusätzlich zum Erstellen von Images in unserer CI-Pipeline (Continuous Integration) haben wir Umgebungen definiert, um Vorabversionen des Ticketsystems für Tests und Qualitätssicherung zu entwickeln und bereitzustellen.
Durch die Bereitstellung einer separaten Instanz des Ticketsystems pro GDC-Projekt konnten wir Änderungen isoliert testen, ohne vorhandene Instanzen auf derselben GDC-Instanz zu beeinträchtigen. Wir haben die ResourceManager API verwendet, um Projekte mithilfe von Kubernetes-Ressourcen deklarativ zu erstellen und zu löschen.
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-dev
---
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-qa
---
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-staging
In Kombination mit Diagrammverpackung und der Verwaltung von Infrastruktur wie virtuellen Maschinen als Code können Entwickler schnell Änderungen vornehmen und neue Funktionen neben Produktionsinstanzen testen. Die deklarative API ermöglicht es automatisierten Testausführungs-Frameworks außerdem, regelmäßige Regressionstests durchzuführen und vorhandene Funktionen zu prüfen.
Bedienbarkeit
Die Bedienbarkeit gibt an, wie einfach ein System bedient und gewartet werden kann. Sie ist ein wichtiger Aspekt beim Design jeder Softwareanwendung. Ein effektives Monitoring trägt zur Betriebsfähigkeit bei, da Probleme erkannt und behoben werden können, bevor sie erhebliche Auswirkungen auf das System haben. Monitoring kann auch verwendet werden, um Verbesserungsmöglichkeiten zu identifizieren und eine Baseline für Service Level Objectives (SLOs) festzulegen.
Monitoring
Wir haben das Ticketsystem in die vorhandene GDC-Beobachtbarkeitsinfrastruktur eingebunden, einschließlich Logging und Messwerten. Für Messwerte stellen wir HTTP-Endpunkte von jeder VM bereit, über die die Anwendung Datenpunkte erfassen kann, die von den Anwendungs- und Datenbankservern erzeugt werden. Diese Endpunkte umfassen Systemmesswerte, die mit dem Anwendungsknoten-Exporter erfasst werden, und anwendungsspezifische Messwerte.
Da die Endpunkte in jeder VM verfügbar sind, haben wir das Abrufverhalten der Anwendung mit der benutzerdefinierten Ressource MonitoringTarget konfiguriert, um das Scraping-Intervall zu definieren und die Messwerte zu annotieren.
apiVersion: monitoring.gdc.goog/v1
kind: MonitoringTarget
metadata:
  name: database-monitor
spec:
  podMetricsEndpoints:
    path:
      value: /metrics
    port:
      annotation: application.io/dbMetrics
    scrapeInterval: 60s
Für das Logging haben wir auf jeder VM einen Logging- und Messwertprozessor installiert und konfiguriert, um relevante Logs zu verfolgen und Logdaten an das Logging-Tool zu senden. Dort werden die Daten indexiert und über die Monitoring-Instanz abgefragt. Audit-Logs werden an einen speziellen Endpunkt weitergeleitet, der für die Compliance mit einer erweiterten Aufbewahrung konfiguriert ist. Containerbasierte Anwendungen können die benutzerdefinierte Ressource LoggingTarget und AuditLoggingTarget verwenden, um die Logging-Pipeline anzuweisen, Logs von bestimmten Diensten in Ihrem Projekt zu erfassen.
Basierend auf den in den Logging- und Monitoring-Prozessoren verfügbaren Daten haben wir Benachrichtigungen mit der benutzerdefinierten Ressource MonitoringRule erstellt. So können wir diese Konfiguration als Code in unserem Diagrammpaket verwalten. Wenn wir eine deklarative API verwenden, um Benachrichtigungen und Dashboards zu definieren, können wir diese Konfiguration auch in unserem Code-Repository speichern und dieselben Codeüberprüfungs- und Continuous Integration-Prozesse befolgen, die wir für alle anderen Codeänderungen verwenden.
Fehlermodi
Bei frühen Tests wurden mehrere ressourcenbezogene Fehlermodi aufgedeckt, die uns geholfen haben, zu priorisieren, welche Messwerte und Benachrichtigungen zuerst hinzugefügt werden sollten. Wir haben mit dem Monitoring der hohen Arbeitsspeicher- und Laufwerksnutzung begonnen, da eine Fehlkonfiguration der Datenbank anfangs dazu führte, dass Puffertabellen den gesamten verfügbaren Arbeitsspeicher verbrauchten und übermäßiges Logging das angehängte nichtflüchtige Volume füllte. Nachdem wir die Größe des Speicherpuffers angepasst und eine Strategie für die Logrotation implementiert hatten, haben wir Benachrichtigungen eingeführt, die ausgelöst werden, wenn die VMs eine hohe Arbeitsspeicher- oder Laufwerksnutzung erreichen.
apiVersion: monitoring.gdc.goog/v1
kind: MonitoringRule
metadata:
  name: monitoring-rule
spec:
  interval: 60s
  limit: 0
  alertRules:
  - alert: vm1_disk_usage
    expr:
      (node_filesystem_size_bytes{container_name="compute"} -
      node_filesystem_avail_bytes{container_name="compute"}) * 100 /
      node_filesystem_size_bytes{container_name="compute"} > 90
    labels:
      severity: error
      code: TS-R0001
      resource: vm1
    annotations:
      message: "vm1 disk usage above 90% utilization"
Nachdem wir die Systemstabilität überprüft hatten, haben wir uns auf die Fehlermodi der Anwendung im Ticketsystem konzentriert. Da wir zum Debuggen von Problemen in der Anwendung oft per Secure Shell (SSH) auf jede Anwendungsserver-VM zugreifen mussten, um die Logs des Ticketsystems zu prüfen, haben wir eine Anwendung so konfiguriert, dass diese Logs an das Logging-Tool weitergeleitet werden. So konnten wir den GDC-Beobachtbarkeits-Stack nutzen und alle operativen Logs des Ticketsystems in der Monitoring-Instanz abfragen.
Durch das zentralisierte Logging konnten wir auch Logs von mehreren VMs gleichzeitig abfragen und so die Ansicht der einzelnen Komponenten des Systems konsolidieren.
Sicherungen
Sicherungen sind für die Funktionsfähigkeit eines Softwaresystems wichtig, da sie die Wiederherstellung des Systems im Falle eines Ausfalls ermöglichen.
GDC bietet VM-Sicherung und -Wiederherstellung über Kubernetes-Ressourcen. Wenn Sie eine benutzerdefinierte VirtualMachineBackupRequest-Ressource mit einer benutzerdefinierten VirtualMachineBackupPlanTemplate-Ressource erstellen, können Sie den nichtflüchtigen Speicher, der an jede VM angehängt ist, im Objektspeicher sichern. Dort können die Sicherungen gemäß einer Aufbewahrungsrichtlinie aufbewahrt werden.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineBackupPlanTemplate
metadata:
  name: vm-backup-plan
spec:
  backupRepository: "backup-repository"
---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineBackupRequest
metadata:
  name: "db-vm-backup"
spec:
  virtualMachineBackupPlanTemplate: vm-backup-plan
  virtualMachine: db1
  virtualMachineBackupName: db-vm-backup
Ähnlich verhält es sich beim Wiederherstellen eines VM-Zustands aus einem Backup. Hierbei wird eine benutzerdefinierte VirtualMachineRestoreRequest-Ressource erstellt, um sowohl Anwendungs- als auch Datenbankserver wiederherzustellen, ohne den Code oder die Konfiguration für einen der beiden Dienste zu ändern.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineRestoreRequest
metadata:
  name: vm-restore-1
spec:
  virtualMachineBackup: db-vm-backup
  restoreName: restore1
  restoredResourceName: db1
Upgrades
Um den Softwarelebenszyklus des Ticketsystems und seiner Abhängigkeiten zu unterstützen, haben wir drei Arten von Softwareupgrades identifiziert, die jeweils einzeln behandelt werden, um Ausfallzeiten und Dienstunterbrechungen zu minimieren:
- Betriebssystemupgrades
- Plattformupgrades, z. B. Patch- und Hauptversionen.
- Konfigurationsupdates.
Für Betriebssystemupgrades erstellen und veröffentlichen wir kontinuierlich neue VM-Images für Anwendungs- und Datenbankserver, die mit jedem GDC-Release verteilt werden. Diese Images enthalten Korrekturen für Sicherheitslücken und Updates für das zugrunde liegende Betriebssystem.
Für die Upgrades der Ticketingsystem-Plattform müssen die vorhandenen VM-Images aktualisiert werden. Daher können wir uns nicht auf eine unveränderliche Infrastruktur verlassen, um Patches und Updates für Haupt-Release-Versionen durchzuführen. Bei Plattformupgrades testen und verifizieren wir die Patch- oder Hauptversion in unseren Entwicklungs- und Staging-Umgebungen, bevor wir ein eigenständiges Upgradepaket zusammen mit dem GDC-Release veröffentlichen.
Schließlich werden Konfigurationsupdates ohne Ausfallzeiten über die APIs des Ticketsystems für Update-Sets und andere Nutzerdaten angewendet. Wir entwickeln und testen Konfigurationsupdates in unseren Entwicklungs- und Staging-Umgebungen, bevor wir im Rahmen des GDC-Release-Prozesses mehrere Update-Sets zusammenfassen.
Integrationen
Identitätsanbieter
Damit Kunden eine nahtlose Nutzung ermöglicht wird und Organisationen ihre Nutzer einbinden können, integrieren wir das Ticketsystem in mehrere Identitätsanbieter, die in der GDC verfügbar sind. In der Regel haben Kunden aus Unternehmen und dem öffentlichen Sektor eigene, gut verwaltete Identitätsanbieter, um ihren Mitarbeitern Berechtigungen zu gewähren und zu entziehen. Aufgrund von Compliance-Anforderungen und zur Vereinfachung der Identitäts- und Zugriffsverwaltung möchten diese Kunden ihre vorhandenen Identitätsanbieter als „Source of Truth“ verwenden, um den Zugriff ihrer Mitarbeiter auf das Ticketsystem zu verwalten.
Das Ticketsystem unterstützt sowohl SAML 2.0- als auch OIDC-Anbieter über das Multi-Identity-Provider-Modul, das wir in unserem VM-Image für den Anwendungsserver vorab aktiviert haben. Kunden authentifizieren sich über den Identitätsanbieter ihrer Organisation, der automatisch Nutzer erstellt und Rollen im Ticketsystem zuweist.
Ausgehender Traffic zu Identitätsanbieter-Servern ist über die benutzerdefinierte Ressource ProjectNetworkPolicy zulässig, die einschränkt, ob externe Dienste von einer Organisation in GDC erreichbar sind. Mit diesen Richtlinien können wir deklarativ steuern, auf welche Endpunkte das Ticketsystem im Netzwerk zugreifen kann.
Benachrichtigungsaufnahme
Nutzer können sich nicht nur anmelden, um Supportanfragen manuell zu erstellen, sondern wir erstellen auch Ticketsystemvorfälle als Reaktion auf Systembenachrichtigungen.
Dazu haben wir einen Open-Source-Kubernetes-Webhook angepasst, um Benachrichtigungen von der Anwendung zu empfangen und den Lebenszyklus von Vorfällen über den API-Endpunkt des Ticketsystems zu verwalten, der über Cloud Service Mesh bereitgestellt wird.
API-Schlüssel werden im GDC-Secret-Speicher gespeichert, der durch Kubernetes-Secrets gesichert ist, die über die rollenbasierte Zugriffssteuerung (Role-Based Access Control, RBAC) gesteuert werden. Andere Konfigurationen wie API-Endpunkte und Felder zur Anpassung von Vorfällen werden über den Kubernetes-ConfigMap-Schlüssel/Wert-Speicher verwaltet.
Das Ticketsystem bietet Mailserver-Integrationen, damit Kunden E-Mail-basierten Support erhalten können. Automatisierte Workflows wandeln eingehende Kunden-E‑Mails in Supportanfragen um und senden automatische Antworten mit Links zu den Anfragen an die Kunden. So kann unser Supportteam seinen Posteingang besser verwalten, E‑Mail-Anfragen systematisch verfolgen und lösen und einen besseren Kundenservice bieten.
apiVersion: networking.gdc.goog/v1
kind: ProjectNetworkPolicy
metadata:
  name: allow-ingress-traffic-from-ticketing-system
spec:
  subject:
    subjectType: UserWorkload
  ingress:
  - from:
    - projects:
        matchNames:
        - ticketing-system
Wenn Sie den E-Mail-Server als Kubernetes-Dienst bereitstellen, erhalten Sie auch Service Discovery und Domainnamenauflösung. Außerdem wird das E-Mail-Server-Backend weiter von Clients wie dem Ticketsystem entkoppelt.
Compliance
Audit-Logging
Audit-Logs tragen zum Compliancestatus bei, da sie eine Möglichkeit bieten, die Softwarenutzung zu verfolgen und zu überwachen, und einen Datensatz der Systemaktivität bereitstellen. In Audit-Logs werden Zugriffsversuche von nicht autorisierten Nutzern aufgezeichnet, die API-Nutzung wird verfolgt und potenzielle Sicherheitsrisiken werden identifiziert. Audit-Logs erfüllen Compliance-Anforderungen, z. B. die des Health Insurance Portability and Accountability Act (HIPAA), des Payment Card Industry Data Security Standard (PCI-DSS) und des Sarbanes-Oxley Act (SOX).
GDC bietet ein System zum Aufzeichnen von Administratoraktivitäten und Zugriffen innerhalb der Plattform und zum Speichern dieser Logs für einen konfigurierbaren Zeitraum. Durch die Bereitstellung der benutzerdefinierten Ressource AuditLoggingTarget wird die Logging-Pipeline so konfiguriert, dass Audit-Logs aus unserer Anwendung erfasst werden.
Für das Ticketsystem haben wir Audit-Logging-Ziele für die erfassten System-Audit-Ereignisse und die anwendungsspezifischen Ereignisse konfiguriert, die vom Sicherheits-Audit-Log des Ticketsystems generiert werden. Beide Arten von Logs werden an eine zentrale Loki-Instanz gesendet, in der wir Abfragen schreiben und Dashboards in der Monitoring-Instanz aufrufen können.
Zugriffssteuerung
Bei der Zugriffssteuerung wird der Zugriff auf Ressourcen basierend auf der Identität des Nutzers oder Prozesses, der den Zugriff anfordert, gewährt oder verweigert. So werden die Daten vor unbefugtem Zugriff geschützt und es wird sichergestellt, dass nur autorisierte Nutzer Änderungen am System vornehmen können. In GDC verwenden wir Kubernetes RBAC, um Richtlinien zu deklarieren und die Autorisierung für die Systemressourcen zu erzwingen, die aus der Anwendung des Ticketsystems bestehen.
Wenn Sie in GDC eine ProjectRole definieren, können Sie mithilfe einer voreingestellten Autorisierungsrolle detaillierten Zugriff auf Kubernetes-Ressourcen gewähren.
apiVersion: resourcemanager.gdc.goog/v1
kind: ProjectRole
metadata:
  name: ticketing-system-admin
  labels:
    resourcemanager.gdc.goog/rbac-selector: system
spec:
  rules:
  - apiGroups:
    - ""
    resources:
    - configmaps
    - events
    - pods/log
    - services
    verbs:
    - get
    - list
Notfallwiederherstellung
Datenbankreplikation
Um die Anforderungen an die Notfallwiederherstellung (DR) zu erfüllen, stellen wir das Ticketsystem in einer primär-sekundären Konfiguration über mehrere GDC-Instanzen hinweg bereit. In diesem Modus werden Anfragen an das Ticketsystem normalerweise an den primären Standort weitergeleitet, während der sekundäre Standort das binäre Log der Datenbank kontinuierlich repliziert. Im Falle eines Failovers wird der sekundäre Standort zum neuen primären Standort hochgestuft und Anfragen werden dann an den neuen primären Standort weitergeleitet.
Wir bauen auf den Funktionen zur Datenbankreplikation auf, um sowohl den primären als auch den Replikatdatenbankserver pro GDC-Instanz basierend auf den festgelegten Parametern zu konfigurieren.
Wenn Sie die Replikation für eine vorhandene Instanz aktivieren möchten, die länger als die Aufbewahrungsdauer für das Binärlog ausgeführt wurde, können Sie die Replikatdatenbank mithilfe einer Datenbanksicherung wiederherstellen, um die Replikation von der primären Datenbank zu starten.
Im primären Modus funktionieren die Anwendungsserver und die Datenbank wie heute, aber die primäre Datenbank ist so konfiguriert, dass die Replikation aktiviert ist. Beispiel:
Aktivieren Sie das Binärlog.
Legen Sie die Server-ID fest.
Nutzerkonto für Replikation erstellen
Eine Sicherung erstellen.
Im Replikatmodus deaktivieren die Anwendungsserver den Ticketing-Webdienst, um eine direkte Verbindung zur Replikatdatenbank zu vermeiden. Die Replikatdatenbank muss so konfiguriert sein, dass die Replikation von der primären Datenbank gestartet wird. Beispiel:
Legen Sie die Server-ID fest.
Konfigurieren Sie die Anmeldedaten des Replikationsnutzers und die Details der primären Verbindung, z. B. Host und Port.
Position des binären Logs für die Wiederherstellung aus der Sicherung fortsetzen.
Für die Datenbankreplikation ist eine Netzwerkverbindung erforderlich, damit das Replikat eine Verbindung zur primären Datenbank herstellen und die Replikation starten kann. Um den primären Datenbankendpunkt für die Replikation freizugeben, verwenden wir Cloud Service Mesh, um ein Ingress-Service-Mesh zu erstellen, das die TLS-Terminierung im Service-Mesh unterstützt. Dies ähnelt der Art und Weise, wie wir die HTTPS-Datenübertragung für die Webanwendung des Ticketsystems verarbeiten.