


Google Distributed Cloud(GDC)エアギャップの Vertex AI Translation の用語集を使用すると、ドメイン固有の用語を定義して、言語ペア間で一貫した翻訳を行うことができます。ソースとターゲットの用語ペアを構成することで、商品名、あいまいな単語、借用語などの専門用語の翻訳方法を制御できます。
用語集のエントリは、単一の単語(トークンとも呼ばれます)または短いフレーズ(通常は 5 単語未満)で構成されます。Vertex AI Translation は、翻訳中に一致するエントリを適用しますが、ストップワードに一致するエントリは無視します。
用語集のメソッド
Vertex AI Translation には、GDC で次の用語集メソッドが用意されています。
| メソッド | 説明 |
|---|---|
CreateGlossary |
用語集を作成します。 |
GetGlossary |
保存されている用語集を返します。 |
ListGlossaries |
プロジェクト内の用語集のリストを返します。 |
DeleteGlossary |
不要になった用語集を削除します。 |
始める前に
翻訳用の用語を定義する用語集を作成する前に、translation-glossary-project という名前のプロジェクトが必要です。プロジェクトのカスタム リソースは、次の例のようになります。
  apiVersion: resourcemanager.gdc.goog/v1
  kind: Project
  metadata:
    labels:
      atat.config.google.com/clin-number: CLIN_NUMBER
      atat.config.google.com/task-order-number: TASK_ORDER_NUMBER
    name: translation-glossary-project
    namespace: platform
用語集を使用するために必要な権限を取得するには、プロジェクトの名前空間で次のロールを付与するよう IAM プロジェクト管理者に依頼してください。
- AI Translation デベロッパー: Vertex AI Translation サービスにアクセスするには、AI Translation デベロッパー(
ai-translation-developer)ロールを取得します。 - プロジェクト バケット管理者: プロジェクト バケット管理者(
project-bucket-admin)ロールを取得して、ストレージ バケットとバケット内のオブジェクトを管理します。これにより、ファイルの作成とアップロードが可能になります。
前提条件の詳細については、翻訳プロジェクトを設定するをご覧ください。
用語集ファイルを作成する
ソース言語とターゲット言語の用語を保存する用語集ファイルを作成する必要があります。このセクションでは、用語の定義に使用できる 2 つの異なる用語集レイアウトについて説明します。
次の表に、Distributed Cloud でサポートされている用語集ファイルの上限を示します。
| 説明 | 上限 |
|---|---|
| 最大ファイルサイズ | 1,040 万(10,485,760)UTF-8 バイト |
| 用語集の用語の最大長 | 1,024 UTF-8 バイト |
| 1 プロジェクトに使用できる用語集リソースの最大数 | 10,000 |
用語集ファイルのレイアウトを次のいずれかから選択します。
- 単一方向の用語集: 特定の言語のソース用語とターゲット用語のペアに対して、期待される翻訳を指定します。一方向の用語集は、TSV、CSV、TMX のファイル形式をサポートしています。
- 多言語の用語セットの用語集: 各行に複数の言語で想定される翻訳を指定します。多言語の用語セットの用語集は、CSV ファイル形式をサポートしています。
単一言語ペアの用語集
Vertex AI Translation API は、タブ区切り値(TSV)とカンマ区切り値(CSV)を受け入れます。各行には、これらのファイル形式のタブ(\t)またはカンマ(,)で区切られた用語のペアが含まれています。
Vertex AI Translation API は、Translation Memory eXchange(TMX)形式も受け入れます。これは、翻訳のソースとターゲットの用語ペアを提供する標準の XML 形式です。サポートされている入力ファイルは、TMX バージョン 1.4 に基づく形式です。
次の例は、一方向の用語集の TSV、CSV、TMX ファイル形式に必要な構造を示しています。
TSV と CSV
次の図は、TSV ファイルまたは CSV ファイルの 2 つの列を示しています。最初の列にはソース言語の用語、2 番目の列にはターゲット言語の用語が含まれます。
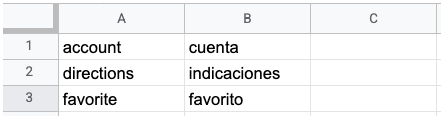
一方向の TSV ファイルまたは CSV ファイルにヘッダー行を含めないでください。最初の行には用語データを含める必要があります。用語集リクエストにより、Vertex AI Translation API でファイルを使用できるようになります。
TMX
次の例は、TMX ファイルで必要な構造を示しています。
<?xml version='1.0' encoding='utf-8'?>
<!DOCTYPE tmx SYSTEM "tmx14.dtd">
<tmx version="1.4">
  <header segtype="sentence" o-tmf="UTF-8" adminlang="en" srclang="en" datatype="PlainText"/>
  <body>
    <tu>
      <tuv xml:lang="en">
        <seg>account</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>cuenta</seg>
      </tuv>
    </tu>
    <tu>
      <tuv xml:lang="en">
        <seg>directions</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>indicaciones</seg>
      </tuv>
    </tu>
  </body>
</tmx>
この例に示されていない XML タグがファイルに含まれている場合、Vertex AI Translation API はそれらのタグを無視します。
Vertex AI Translation API で正常に処理されるように、TMX ファイルに次の要素を含めます。
<header>:srclang属性を使用してソース言語を識別します。<tu>: 同じソース言語とターゲット言語での<tuv>要素のペアを含めます。これらの<tuv>要素は、以下に準拠しています。- 各
<tuv>要素は、xml:lang属性を使用して、含まれるテキストの言語を指定します。ソース言語とターゲット言語の指定には、ISO-639-1 コードを使用します。サポートされている言語とそれぞれの言語コードの一覧をご覧ください。 - 1 つの
<tu>要素に 3 つ以上の<tuv>要素が含まれる場合、Vertex AI Translation API は、ソース言語に一致する最初の<tuv>要素とターゲット言語に一致する最初の<tuv>要素のみを処理します。サービスは、残りの<tuv>要素を無視します。 <tu>要素の中に対応する<tuv>要素のペアがない場合、Vertex AI Translation API はその無効な<tu>要素を無視します。
- 各
<seg>: 一般化されたテキスト文字列を表します。Vertex AI Translation API は、ファイルを処理する前に<seg>要素からマークアップ タグを除外します。1 つの<tuv>要素に複数の<seg>要素が含まれている場合、Vertex AI Translation API はテキスト文字列の間にスペースを挿入して、テキストを 1 つの要素に連結します。
一方向の用語集で用語集の用語を特定したら、ファイルをストレージ バケットにアップロードし、用語集を作成してインポートすることで、Vertex AI Translation API で使用できるようにします。
多言語用語セットの用語集
Vertex AI Translation API は、同義語セットの用語集ファイルを CSV 形式で受け入れます。多言語の用語セットを定義するには、複数列の CSV ファイルを作成します。1 行に 1 つの用語を定義し、各国語の対訳を同じ行に記述します。サポートされている言語とその言語コードの一覧をご覧ください。
次の画像は、複数列の CSV ファイルの例を示しています。各行は用語集の用語を表し、各列は用語の異なる言語への翻訳を表します。
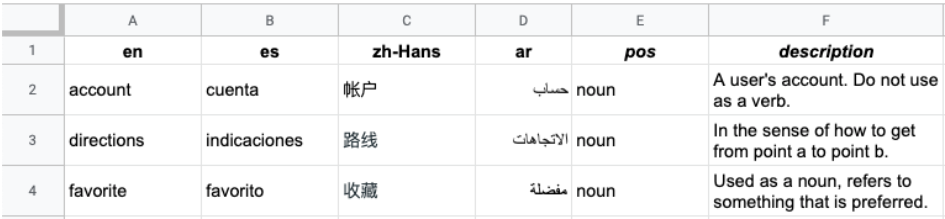
ヘッダーはファイルの最初の行で、各列の言語を識別します。ヘッダー行では、ISO-639-1 または BCP-47 標準の言語コードを使用します。Vertex AI Translation API は品詞(pos)情報を使用せず、特定の位置の値は検証されません。
以降の行では、ヘッダーに指定されている言語の順番で対訳が並びます。すべての言語で用語が利用できない場合は、列を空白のままにできます。
多言語用語セットを準備したら、ファイルをストレージ バケットにアップロードし、用語集を作成してインポートすることで、Vertex AI Translation API で使用できるようにします。
用語集ファイルをストレージ バケットにアップロードする
用語集ファイルをストレージ バケットにアップロードする手順は次のとおりです。
- オブジェクト ストレージ用に gdcloud CLI を構成する。
プロジェクトの名前空間にストレージ バケットを作成します。
Standardストレージ クラスを使用します。ストレージ バケットを作成するには、プロジェクトの名前空間に
Bucketリソースをデプロイします。apiVersion: object.gdc.goog/v1 kind: Bucket metadata: name: glossary-bucket namespace: translation-glossary-project spec: description: bucket for translation glossary storageClass: Standard bucketPolicy: lockingPolicy: defaultObjectRetentionDays: 90Vertex AI Translation サービスで使用されるサービス アカウント(
ai-translation-system-saとg-vai-translation-sie-sa)に、バケットに対するread権限と、プロジェクト名前空間のsecretsに対するget、list、watch権限を付与します。管理 API サーバーでカスタム リソースを使用してロールとロール バインディングを作成する手順は次のとおりです。
secrets権限をすでに持っているユーザーがこれらのリソースを適用する必要があります。そうしないと、リクエストはattempting to grant RBAC permissions not currently heldで失敗します。プロジェクトの名前空間に
Roleリソースをデプロイして、ロールを作成します。apiVersion: rbac.authorization.k8s.io/v1 kind: Role metadata: name: ai-translation-glossary-reader namespace: translation-glossary-project rules: - apiGroups: - object.gdc.goog resources: - buckets verbs: - read-object - apiGroups: - "" resources: - secrets verbs: - get - list - watchプロジェクトの Namespace に
RoleBindingリソースをデプロイして、ロール バインディングを作成します。apiVersion: rbac.authorization.k8s.io/v1 kind: RoleBinding metadata: name: ai-translation-glossary-reader-rolebinding namespace: translation-glossary-project roleRef: apiGroup: rbac.authorization.k8s.io kind: Role name: ai-translation-glossary-reader subjects: - kind: ServiceAccount name: ai-translation-system-sa namespace: g-vai-translation-sie - kind: ServiceAccount name: g-vai-translation-sie-sa namespace: g-vai-translation-sie
作成したストレージ バケットに用語集ファイルをアップロードします。詳細については、プロジェクトでストレージ オブジェクトをアップロードおよびダウンロードするをご覧ください。
用語集を作成する
CreateGlossary メソッドは、用語集を作成し、用語集を生成する長時間実行オペレーションに ID を返します。
用語集を作成するには、リクエスト データを使用する前に、次の値を置き換えます。
ENDPOINT: 組織で使用する Vertex AI Translation エンドポイント。詳細については、サービスのステータスとエンドポイントを表示するをご覧ください。PROJECT_ID: プロジェクト ID。BUCKET_NAME: 用語集ファイルが配置されているストレージ バケットの名前。GLOSSARY_FILENAME: ストレージ バケット内の用語集ファイルの名前。
用語集を作成する HTTP リクエストの構文は次のとおりです。
POST https://ENDPOINT/v3/projects/PROJECT_ID/glossaries
作成した用語集ファイルに応じて、次のいずれかのオプションを選択して用語集を作成します。
単一言語ペア
単一方向の用語集を作成するには、ソース言語(source_language_code)とターゲット言語(target_language_code)を含む言語ペア(language_pair)を指定します。
一方向の用語集を作成する手順は次のとおりです。
次のリクエスト本文を
request.jsonという名前の JSON ファイルに保存します。{ "language_pair": { "source_language_code": "SOURCE_LANGUAGE", "target_language_code": "TARGET_LANGUAGE" }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }次のように置き換えます。
SOURCE_LANGUAGE: 用語集のソース言語の言語コード。サポートされている言語と、それぞれの言語コードの一覧をご覧ください。TARGET_LANGUAGE: 用語集のターゲット言語の言語コード。サポートされている言語と、それぞれの言語コードの一覧をご覧ください。
リクエストを行います。次の例では、REST API メソッドとコマンドラインを使用していますが、クライアント ライブラリを使用して単一言語ペアの用語集を作成することもできます。
curl
curl -X POST \
-H "Authorization: Bearer TOKEN" \
-H "Content-Type: application/json; charset=utf-8" \
-d @request.json \
"https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
TOKEN は、取得した認証トークンに置き換えます。
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }
Invoke-WebRequest
  -Method POST
  -Headers $headers
  -ContentType: "application/json; charset=utf-8"
  -InFile request.json
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
TOKEN は、取得した認証トークンに置き換えます。
Python
作成した Python スクリプトに次のコードを追加します。
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    source_lang_code="SOURCE_LANGUAGE", target_lang_code="TARGET_LANGUAGE"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_pair": {"source_language_code": source_lang_code,
                              "target_language_code": target_lang_code},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
次のように置き換えます。
SOURCE_LANGUAGE: 用語集のソース言語の言語コード。サポートされている言語とそれぞれの言語コードの一覧をご覧ください。TARGET_LANGUAGE: 用語集のターゲット言語の言語コード。サポートされている言語とそれぞれの言語コードの一覧をご覧ください。CERT_NAME: 認証局(CA)証明書ファイルの名前(org-1-trust-bundle-ca.certなど)。詳細については、開発環境で信頼バンドル CA 証明書ファイルを生成するをご覧ください。
Python スクリプトを保存します。
Python スクリプトを実行します。
python SCRIPT_NAMESCRIPT_NAMEは、Python スクリプトに付けた名前(glossary.pyなど)に置き換えます。
projects.glossaries.create メソッドの詳細については、Vertex AI Translation REST API リファレンスをご覧ください。
次のような JSON レスポンスが返されます。
{
"name": "projects/PROJECT_ID/operations/OPERATION_ID",
"metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
レスポンスの説明:
OPERATION_ID: 用語集を作成する長時間実行オペレーションのサーバー割り当て ID。サービスは、レスポンスのnameフィールドにこの ID を返します。または、projects.operations.listを呼び出して確認することもできます。projects/PROJECT_ID/operations/OPERATION_IDをprojects.operations.getに渡して、用語集作成オペレーションのステータスを確認できます。GLOSSARY_ID: サーバーによって割り当てられた用語集の ID(Gの後に数字が続く)。get、translate、delete のリクエストで使用します。
多言語用語セット
多言語の用語セットの用語集を作成するには、用語集の言語コード(language_codes)を使用して言語セット(language_codes_set)を指定します。
同等の用語セットの用語集を作成する手順は次のとおりです。
次のリクエスト本文を
request.jsonという名前の JSON ファイルに保存します。{ "language_codes_set": { "language_codes": ["LANGUAGE_CODE_1", "LANGUAGE_CODE_2", "LANGUAGE_CODE_3" ] }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }LANGUAGE_CODE_1、LANGUAGE_CODE_2、LANGUAGE_CODE_3は、用語集の言語のコードに置き換えます。サポートされている言語とそれぞれの言語コードの一覧をご覧ください。次のリクエストを行います。
curl
curl -X POST \
    -H "Authorization: Bearer TOKEN" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d @request.json \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
TOKEN は、取得した認証トークンに置き換えます。
次のような JSON レスポンスが返されます。
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
レスポンスの説明:
OPERATION_ID: 用語集を作成する長時間実行オペレーションのサーバー割り当て ID。この ID は、レスポンスのnameフィールドで返されます。また、projects.operations.listを呼び出すことで確認することもできます。projects/PROJECT_ID/operations/OPERATION_IDをprojects.operations.getに渡して、用語集作成オペレーションのステータスを確認できます。GLOSSARY_ID: サーバーによって割り当てられた用語集の ID(Gの後に数字が続く)。get、translate、delete リクエストで使用します。
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
  -Method POST `
  -Headers $headers `
  -ContentType: "application/json; charset=utf-8" `
  -InFile request.json `
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
TOKEN は、取得した認証トークンに置き換えます。
次のような JSON レスポンスが返されます。
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
レスポンスの説明:
OPERATION_ID: 用語集を作成する長時間実行オペレーションのサーバー割り当て ID。この ID は、レスポンスのnameフィールドで返されます。また、projects.operations.listを呼び出すことで確認することもできます。projects/PROJECT_ID/operations/OPERATION_IDをprojects.operations.getに渡して、用語集作成オペレーションのステータスを確認できます。GLOSSARY_ID: サーバーによって割り当てられた用語集の ID(Gの後に数字が続く)。get、translate、delete リクエストで使用します。
Python
作成した Python スクリプトに次のコードを追加します。
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    lang_1="LANGUAGE_CODE_1", lang_2="LANGUAGE_CODE_2"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_codes_set": {"language_codes": [lang_1, lang_2]},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
次のように置き換えます。
LANGUAGE_CODE_1とLANGUAGE_CODE_2: 用語集の言語の言語コード。サポートされている言語とそれぞれの言語コードの一覧をご覧ください。CERT_NAME: 認証局(CA)証明書ファイルの名前(org-1-trust-bundle-ca.certなど)。詳細については、開発環境で信頼バンドル CA 証明書ファイルを生成するをご覧ください。
Python スクリプトを保存します。
Python スクリプトを実行します。
python SCRIPT_NAMESCRIPT_NAMEは、Python スクリプトに付けた名前(glossary.pyなど)に置き換えます。
projects.glossaries.create メソッドの詳細については、Vertex AI Translation REST API リファレンスをご覧ください。
用語集ファイルのサイズにもよりますが、用語集の作成は通常 10 分以内に完了します。このオペレーションのステータスを取得して、完了したタイミングを確認できます。
用語集を取得する
GetGlossary メソッドは、保存されている用語集を返します。用語集が存在しない場合、出力は NOT_FOUND 値を返します。GetGlossary メソッドを呼び出すには、プロジェクト ID と用語集 ID を指定します。CreateGlossary メソッドと ListGlossaries メソッドはどちらも、用語集 ID を返します。Vertex AI Translation API は HTTPS リクエストのみを受け入れます。
たとえば、次のリクエストは、プロジェクト内の特定の用語集に関する情報を返します。
curl
curl -X GET \
   -H "Authorization: Bearer TOKEN" \
   "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
TOKEN は、取得した認証トークンに置き換えます。
Python
from google.cloud import translate_v3 as translate
from google.api_core.client_options import ClientOptions

def get_glossary(creds, name="projects/PROJECT_ID/glossaries/GLOSSARY_ID"):
    """Get a glossary by its full name. The service assigns the glossary ID."""
    client = translate.TranslationServiceClient(
        credentials=creds, client_options=ClientOptions(api_endpoint="ENDPOINT:443"))
    response = client.get_glossary(name=name)
    print(f"Glossary name: {response.name}")
テキストを翻訳するに示すように、オーディエンス https://ENDPOINT:443 で構成された Distributed Cloud 認証情報(creds)を渡します。
get_glossary メソッドの詳細については、Python クライアント ライブラリをご覧ください。
用語集の一覧表示
ListGlossaries メソッドは、プロジェクト内の Glossary リソースのリストを返します。各リソースには、完全な name(projects/PROJECT_ID/glossaries/GLOSSARY_ID)が含まれています。プロジェクトに用語集がない場合、出力は {} を返します。プロジェクトが存在しない場合、出力は NOT_FOUND 値を返します。ListGlossaries メソッドを呼び出すには、プロジェクト ID と Vertex AI Translation エンドポイントを指定します。Vertex AI Translation API は HTTPS リクエストのみを受け入れます。
たとえば、次のリクエストはプロジェクト内の用語集を返します。
curl -X GET \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries?page_size=10"
TOKEN は、取得した認証トークンに置き換えます。
用語集を削除する
DeleteGlossary メソッドは、用語集を削除します。用語集が存在しない場合、出力は NOT_FOUND 値を返します。DeleteGlossary メソッドを呼び出すには、プロジェクト ID、用語集 ID、Vertex AI Translation エンドポイントを指定します。CreateGlossary メソッドと ListGlossaries メソッドはどちらも、用語集 ID を返します。Vertex AI Translation API は HTTPS リクエストのみを受け入れます。
たとえば、次のリクエストはプロジェクトから用語集を削除します。
curl -X DELETE \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
TOKEN は、取得した認証トークンに置き換えます。