


Mit Dienstkonten in Managed Service for Apache Spark können Sie Batcharbeitslasten und interaktive Sitzungen authentifizieren, um sicher auf Google Cloud -Ressourcen zuzugreifen. Arbeitslasten werden entweder mit den Anmeldedaten des Endnutzers oder des Dienstkontos ausgeführt. Wenn Dienstkonto-Anmeldedaten verwendet werden, hängt das spezifische Dienstkonto, das zum Ausführen der Arbeitslast zugewiesen ist, von der Batch- oder Sitzungslaufzeitversion ab.
Laufzeitdienstkonten vor Version 3.0
Spark-Laufzeitversionen vor 3.0 mit Dienstkonto-Anmeldedaten verwenden das Compute Engine-Standarddienstkonto oder ein vom Nutzer angegebenes benutzerdefiniertes Dienstkonto, um eine Batcharbeitslast zu senden oder eine interaktive Sitzung zu erstellen.
Laufzeitdienstkonten ab Version 3.0
Spark-Laufzeitversionen ab 3.0 mit Dienstkonto-Anmeldedaten verwenden ein vom Nutzer angegebenes benutzerdefiniertes Dienstkonto, um eine Batcharbeitslast zu senden oder eine interaktive Sitzung zu erstellen.
In Managed Service for Apache Spark 3.0 und höheren Laufzeiten wird das Dienstkonto Dataproc Resource Manager Node Service Agent (service-project-number@gcp-sa-dataprocrmnode.iam.gserviceaccount.com) mit der Rolle Dataproc Resource Manager Node Service Agent in einem Managed Service for Apache Spark-Nutzerprojekt ( Google Cloud ) erstellt. Dieses Dienstkonto führt die folgenden Systemvorgänge für Managed Service for Apache Spark-Ressourcen im Projekt aus, in dem eine Arbeitslast erstellt wird:
- Cloud Logging und Cloud Monitoring
- Grundlegende Vorgänge für Managed Service for Apache Spark Resource Manager-Knoten wie
get,heartbeatundmintOAuthToken
IAM-Dienstkontorollen ansehen und verwalten
So rufen Sie die Rollen auf, die dem Dienstkonto für die Batch-Arbeitslast oder -Sitzung zugewiesen sind, und verwalten sie:
Rufen Sie in der Google Cloud Console die Seite IAM auf.
Klicken Sie auf Von Google bereitgestellte Rollenzuweisungen einschließen.
Sehen Sie sich die Rollen an, die für das Standard- oder benutzerdefinierte Dienstkonto der Batch-Arbeitslast oder -Sitzung aufgeführt sind.
In der folgenden Abbildung ist die erforderliche Rolle Managed Service for Apache Spark Worker für das Compute Engine-Standarddienstkonto
project_number-compute@developer.gserviceaccount.comaufgeführt, das Managed Service for Apache Spark standardmäßig als Arbeitslast- oder Sitzungsdienstkonto verwendet.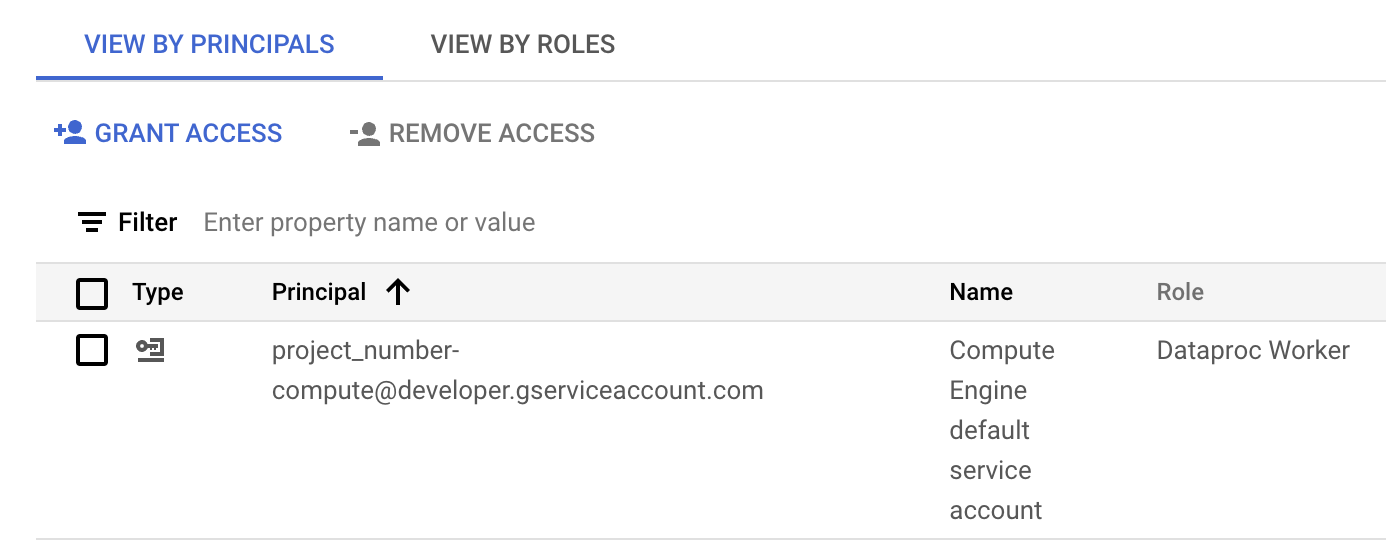
Die Rolle „Managed Service for Apache Spark Worker“, die dem Compute Engine-Standarddienstkonto im IAM-Bereich der Google Cloud -Console zugewiesen ist. Sie können auf das Stiftsymbol in der Zeile des Dienstkontos klicken, um Dienstkontorollen zuzuweisen oder zu entfernen.
Projektübergreifendes Dienstkonto verwenden
Sie können eine Batcharbeitslast einreichen, die ein Dienstkonto aus einem anderen Projekt als dem Batcharbeitslastprojekt (dem Projekt, in dem der Batch eingereicht wird) verwendet. In diesem Abschnitt wird das Projekt, in dem sich das Dienstkonto befindet, als service account project bezeichnet und das Projekt, in dem der Batch gesendet wird, als batch project.
Warum sollte ich ein projektübergreifendes Dienstkonto zum Ausführen einer Batcharbeitslast verwenden? Ein möglicher Grund ist, dass dem Dienstkonto im anderen Projekt IAM-Rollen zugewiesen wurden, die einen detaillierten Zugriff auf die Ressourcen in diesem Projekt ermöglichen.
Einrichtungsschritte
Die Beispiele in diesem Abschnitt gelten für das Senden einer Batcharbeitslast, die mit einer Laufzeitversion vor 3.0 ausgeführt wird.
Im Dienstkontoprojekt:
Ermöglichen, dass Dienstkonten projektübergreifend angehängt werden können
Aktivieren Sie die Managed Service for Apache Spark API, falls sie noch nicht aktiviert ist.
Erforderliche Rollen zum Aktivieren von APIs
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Inhaberrolle (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von RollenWeisen Sie Ihrem E-Mail-Konto (dem Nutzer, der den Cluster erstellt) die Rolle Dienstkontonutzer entweder für das Dienstkontoprojekt oder, für eine genauere Kontrolle, für das Dienstkonto im Dienstkontoprojekt zu.
Weitere Informationen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten, um Rollen auf Projektebene zuzuweisen, und unter Zugriff auf Dienstkonten verwalten, um Rollen auf Dienstkontoebene zuzuweisen.
Beispiele für die gcloud CLI:
Mit dem folgenden Beispielbefehl wird dem Nutzer die Rolle „Dienstkontonutzer“ auf Projektebene zugewiesen:
gcloud projects add-iam-policy-binding SERVICE_ACCOUNT_PROJECT_ID \
    --member=USER_EMAIL \
    --role="roles/iam.serviceAccountUser"
Hinweise:
USER_EMAIL: Geben Sie die E-Mail-Adresse Ihres Nutzerkontos im Formatuser:user-name@example.coman.
Mit dem folgenden Beispielbefehl wird dem Nutzer die Rolle „Dienstkontonutzer“ auf Dienstkontoebene zugewiesen:
gcloud iam service-accounts add-iam-policy-binding VM_SERVICE_ACCOUNT_EMAIL \
    --member=USER_EMAIL \
    --role="roles/iam.serviceAccountUser"
Hinweise:
USER_EMAIL: Geben Sie die E-Mail-Adresse Ihres Nutzerkontos im Formatuser:user-name@example.coman.
Weisen Sie dem Dienstkonto die Rolle Managed Service for Apache Spark Worker für das Batchprojekt zu.
Beispiel für die gcloud CLI:
gcloud projects add-iam-policy-binding BATCH_PROJECT_ID \
    --member=serviceAccount:SERVICE_ACCOUNT_NAME@SERVICE_ACCOUNT_PROJECT_ID.iam.gserviceaccount.com \
    --role="roles/dataproc.worker"
Im Batchprojekt:
Weisen Sie dem Dienstkonto des Dienst-Agents für Managed Service for Apache Spark die Rollen Dienstkontonutzer und Ersteller von Dienstkonto-Tokens entweder für das Dienstkontoprojekt oder, für eine genauere Kontrolle, für das Dienstkonto im Dienstkontoprojekt zu. Dadurch kann das Dienstkonto des Managed Service for Apache Spark-Dienst-Agents im Batchprojekt Tokens für das Dienstkonto im Dienstkontoprojekt erstellen.
Weitere Informationen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten, um Rollen auf Projektebene zuzuweisen, und unter Zugriff auf Dienstkonten verwalten, um Rollen auf Dienstkontoebene zuzuweisen.
Beispiele für die gcloud CLI:
Mit den folgenden Befehlen werden dem Dienstkonto des Managed Service for Apache Spark-Dienst-Agents im Batchprojekt die Rollen „Dienstkontonutzer“ und „Ersteller von Dienstkonto-Tokens“ auf Projektebene zugewiesen:
gcloud projects add-iam-policy-binding SERVICE_ACCOUNT_PROJECT_ID \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@dataproc-accounts.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountUser"
gcloud projects add-iam-policy-binding SERVICE_ACCOUNT_PROJECT_ID \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@dataproc-accounts.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountTokenCreator"
Mit den folgenden Beispielbefehlen werden dem Dienstkonto des Managed Service for Apache Spark-Dienst-Agents im Batchprojekt die Rollen „Dienstkontonutzer“ und „Ersteller von Dienstkonto-Tokens“ auf Dienstkontoebene zugewiesen:
gcloud iam service-accounts add-iam-policy-binding VM_SERVICE_ACCOUNT_EMAIL \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@dataproc-accounts.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountUser"
gcloud iam service-accounts add-iam-policy-binding VM_SERVICE_ACCOUNT_EMAIL \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@dataproc-accounts.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountTokenCreator"
Weisen Sie dem Compute Engine-Dienst-Agent-Dienstkonto im Batchprojekt die Rolle Ersteller von Dienstkonto-Tokens entweder für das Dienstkontoprojekt oder, für eine detailliertere Kontrolle, für das Dienstkonto im Dienstkontoprojekt zu. Dadurch gewähren Sie dem Dienstkonto des Compute-Agent-Dienst-Agents im Batchprojekt die Möglichkeit, Tokens für das Dienstkonto im Dienstkontoprojekt zu erstellen.
Weitere Informationen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten, um Rollen auf Projektebene zuzuweisen, und unter Zugriff auf Dienstkonten verwalten, um Rollen auf Dienstkontoebene zuzuweisen.
Beispiele für die gcloud CLI:
Mit dem folgenden Beispielbefehl wird dem Compute Engine-Dienst-Agent-Dienstkonto im Batchprojekt die Rolle „Ersteller von Dienstkonto-Tokens“ auf Projektebene zugewiesen:
gcloud projects add-iam-policy-binding SERVICE_ACCOUNT_PROJECT_ID \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@compute-system.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountTokenCreator"
Mit dem folgenden Beispielbefehl wird dem Compute Engine-Dienst-Agent-Dienstkonto im Clusterprojekt die Rolle „Ersteller von Dienstkonto-Tokens“ auf Dienstkontoebene zugewiesen:
gcloud iam service-accounts add-iam-policy-binding VM_SERVICE_ACCOUNT_EMAIL \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@compute-system.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountTokenCreator"
Batcharbeitslast senden
Nachdem Sie die Einrichtungsschritte abgeschlossen haben, können Sie eine Batcharbeitslast senden. Geben Sie das Dienstkonto im Dienstkontoprojekt als das Dienstkonto an, das für die Batcharbeitslast verwendet werden soll.
Berechtigungsfehler beheben
Falsche oder unzureichende Berechtigungen für das Dienstkonto, das von Ihrer Batcharbeitslast oder -sitzung verwendet wird, können zu Fehlern bei der Batch- oder Sitzungserstellung führen, die die Fehlermeldung „Driver compute node failed to initialize for batch in 600 seconds“ ausgeben. Dieser Fehler weist darauf hin, dass der Spark-Treiber nicht innerhalb des zugewiesenen Zeitlimits gestartet werden konnte, häufig aufgrund fehlender erforderlicher Zugriffsrechte auf Google Cloud -Ressourcen.
Prüfen Sie zur Behebung dieses Problems, ob Ihr Dienstkonto mindestens die folgenden Rollen oder Berechtigungen hat:
- Rolle Managed Service for Apache Spark Worker (
roles/dataproc.worker): Diese Rolle gewährt die erforderlichen Berechtigungen für Managed Service for Apache Spark, um Spark-Arbeitslasten und -Sitzungen zu verwalten und auszuführen. - Storage-Objekt-Betrachter (
roles/storage.objectViewer), Storage-Objekt-Ersteller (roles/storage.objectCreator) oder Storage-Objekt-Administrator (roles/storage.admin): Wenn Ihre Spark-Anwendung aus Cloud Storage-Buckets liest oder in diese schreibt, benötigt das Dienstkonto die entsprechenden Berechtigungen für den Zugriff auf die Buckets. Wenn sich Ihre Eingabedaten beispielsweise in einem Cloud Storage-Bucket befinden, istStorage Object Viewererforderlich. Wenn Ihre Anwendung Ausgaben in einen Cloud Storage-Bucket schreibt, istStorage Object CreatoroderStorage Object Adminerforderlich. - BigQuery-Dateneditor (
roles/bigquery.dataEditor) oder BigQuery-Datenbetrachter (roles/bigquery.dataViewer): Wenn Ihre Spark-Anwendung mit BigQuery interagiert, prüfen Sie, ob das Dienstkonto die entsprechenden BigQuery-Rollen hat. - Cloud Logging-Berechtigungen: Das Dienstkonto benötigt Berechtigungen zum Schreiben von Logs in Logging, um ein effektives Debugging zu ermöglichen. In der Regel ist die Rolle
Logging Writer(roles/logging.logWriter) ausreichend.
Häufige Fehler im Zusammenhang mit Berechtigungen oder Zugriff
Fehlende Rolle
dataproc.worker: Ohne diese Kernrolle kann die Managed Service for Apache Spark-Infrastruktur den Treiberknoten nicht ordnungsgemäß bereitstellen und verwalten.Unzureichende Cloud Storage-Berechtigungen: Wenn Ihre Spark-Anwendung versucht, Eingabedaten aus einem Cloud Storage-Bucket zu lesen oder Ausgaben in einen Cloud Storage-Bucket zu schreiben, ohne die erforderlichen Dienstkontoberechtigungen zu haben, kann der Treiber nicht initialisiert werden, da er keinen Zugriff auf wichtige Ressourcen hat.
Netzwerk- oder Firewallprobleme: VPC Service Controls oder Firewallregeln können versehentlich den Zugriff von Dienstkonten auf Google Cloud -APIs oder ‑Ressourcen blockieren.
So prüfen und aktualisieren Sie die Dienstkontoberechtigungen:
- Rufen Sie in der Google Cloud Console die Seite IAM & Verwaltung > IAM auf.
- Suchen Sie das Dienstkonto, das für Ihre Batcharbeitslasten oder -sitzungen verwendet wird.
- Prüfen Sie, ob die erforderlichen Rollen zugewiesen sind. Falls nicht, fügen Sie sie hinzu.
Eine Liste der Rollen und Berechtigungen für Managed Service for Apache Spark finden Sie unter Berechtigungen und IAM-Rollen für Managed Service for Apache Spark.