


データリネージを表示して、プロジェクトのリソースとそれらを作成したプロセスの関係を把握します。これらの関係は、テーブルやデータセットなどのデータアセットが、クエリやパイプラインなどのプロセスによってどのように変換されるかを示します。このガイドでは、 Google Cloud コンソールでデータリネージの詳細を表示する方法と、Data Lineage API を使用して取得する方法について説明します。
ロールと権限
Data Lineage API を有効にすると、データリネージはリネージ情報を自動的に追跡します。データアセットのリネージのキャプチャには管理者や編集者のロールは必要ありません。
データリネージを表示するには、特定の Identity and Access Management(IAM)権限が必要です。リネージ情報はプロジェクト間でキャプチャされるため、複数のプロジェクトで権限が必要です。
Knowledge Catalog、BigQuery、または Vertex AI でリネージを表示する場合: リネージを表示するプロジェクトでリネージ情報を表示する権限が必要です。
他のプロジェクトで記録されたリネージを表示する場合: リネージが記録されたプロジェクトでリネージ情報を表示する権限が必要です。
データ リネージを表示するために必要な権限を取得するには、次の IAM ロールを付与するよう管理者に依頼してください。
- リネージが記録されているプロジェクトとリネージが表示されるプロジェクトに対するデータリネージ閲覧者 (
roles/datalineage.viewer) -
BigQuery テーブルの詳細を表示する: テーブルのストレージ プロジェクトに対する BigQuery データ閲覧者 (
roles/bigquery.dataViewer) -
BigQuery ジョブの詳細を表示する: ジョブのコンピューティング プロジェクトに対する BigQuery リソース閲覧者 (
roles/bigquery.resourceViewer) -
カタログに登録された他のアセットの詳細を表示する: カタログ エントリが保存されているプロジェクトに対する Dataplex Catalog 閲覧者 (
roles/dataplex.catalogViewer)
ロールの付与については、プロジェクト、フォルダ、組織へのアクセス権の管理をご覧ください。
これらの事前定義ロールには、データ リネージを表示するために必要な権限が含まれています。必要とされる正確な権限については、「必要な権限」セクションを開いてご確認ください。
必要な権限
データ リネージを表示するには、次の権限が必要です。
-
BigQuery テーブルの詳細を表示する:
bigquery.tables.get- テーブルのストレージ プロジェクト -
BigQuery ジョブの詳細を表示する:
bigquery.jobs.get- ジョブのコンピューティング プロジェクト
カスタムロールや他の事前定義ロールを使用して、これらの権限を取得することもできます。
データリネージ ビューのタイプ
リネージ情報は、 Google Cloud コンソールでインタラクティブなグラフまたは構造化されたリストとして表示できます。
グラフ要素(ノード、エッジ、プロセス アイコン、ラベルなど)とリストビューで使用可能な列の詳細については、Knowledge Catalog のデータ リネージの可視化についてをご覧ください。
データリネージを有効にする
データリネージを有効にして、サポートされているシステムのリネージ情報の自動追跡を開始します。デフォルトでは、API を有効にすると、サポートされているほとんどのサービスでリネージ追跡が有効になります。Managed Service for Apache Spark のリネージの取り込みを制御するには、サービスのリネージの取り込みを制御するをご覧ください。
Data Lineage API は、Knowledge Catalog プレミアム処理 SKU で課金されます。詳細については、Knowledge Catalog の料金をご覧ください。
リネージを表示するプロジェクトと、リネージが記録されているプロジェクトの両方でデータリネージ API を有効にする必要があります。詳細については、プロジェクトのタイプをご覧ください。
- リネージ情報をキャプチャする手順は次のとおりです。
-
Google Cloud コンソールの [プロジェクト セレクタ] ページで、リネージを記録するプロジェクトを選択します。
データリネージ API を有効にします。
- リネージを記録するプロジェクトごとに、上記の手順を繰り返します。
-
リネージを表示するプロジェクトで、データリネージ API と Dataplex API を有効にします。
サービスの系統の取り込みを制御する
プロジェクト、フォルダ、組織のレベルで、特定のサービスの自動リネージ トラッキングを選択的に有効または無効にできます。
これらの構成がリソースツリーを介して階層的に適用される方法については、リネージの取り込みを制御するをご覧ください。
リネージを表示
データが変換され、システム間で移動する様子を追跡するには、 Google Cloud コンソールまたは API を使用してデータリネージを表示します。
コンソール
Google Cloud コンソールでは、さまざまな開始点からデータリネージ情報にアクセスできます。
- Knowledge Catalog: Knowledge Catalog の [検索] ページに移動し、検索モードとして [Knowledge Catalog] を選択して、表示するエントリを検索し、クリックします。詳細については、Knowledge Catalog でリソースを検索するをご覧ください。
- BigQuery: [BigQuery] ページに移動し、データリネージを表示するテーブルを開きます。
- Vertex AI: [データセット] ページまたは [Model Registry] ページに移動し、データリネージを表示するデータセットまたはモデルをクリックします。
リネージグラフを表示する手順は次のとおりです。
[リネージ] タブをクリックします。
デフォルトの [グラフ] ビューが開き、システムとリージョン間のテーブルレベルのリネージが表示されます。詳細については、リネージグラフ ビューをご覧ください。
リネージグラフを手動で探索するには、ノードの横にある [展開] をクリックして、一度に 5 つのノードを読み込みます。
詳細については、リネージグラフを手動で探索するをご覧ください。
[グラフ] ビューでノードをクリックします。
[詳細] パネルが開き、完全修飾名やタイプなど、アセットに関する情報が表示されます。詳細については、ノードの詳細をご覧ください。
[グラフ] ビューで、プロセス アイコン付きのエッジをクリックします。
[クエリ] パネルが開きます。詳細については、変換ロジックを検査すると実行の監査と履歴をご覧ください。
- 変換ロジックを検査するには、[詳細] タブをクリックします。
- 実行の監査と履歴を表示するには、[実行] タブをクリックします。
[リネージ エクスプローラ] パネルで、[方向]、[依存関係のタイプ]、[期間] などのフィルタ条件を選択し、[適用] をクリックします。
これによって、特定のリージョン内のフォーカス ビューが開きます(プレビュー)。このビューでは、グラフが自動的に最大 3 レベルのノードまで展開されます。詳細については、フィルタを適用してリネージビューを絞り込むをご覧ください。
フォーカスした [グラフ] ビューでノードを選択し、ノードの詳細パネルで [Visualize Path] をクリックして、選択したノードからルートエントリまでのリネージパスを可視化します(フォーカスされたビューのみ)。
詳細については、リネージパスの可視化をご覧ください。
列レベルのリネージを表示するには(BigQuery ジョブと Managed Service for Apache Spark ジョブのみ)、次のいずれかを行います。
- フォーカスされた [グラフ] ビューで、表の列アイコンをクリックします。
列アイコン - [リネージ エクスプローラ] パネルで、列名でフィルタして [適用] をクリックします。
詳細については、列レベルのリネージをご覧ください。
- フォーカスされた [グラフ] ビューで、表の列アイコンをクリックします。
[リセット] をクリックします。
この操作を行うと、適用されているすべてのフィルタが削除され、グラフビューの先頭に移動します。
[リスト] をクリックして、リスト表示に切り替えます。
リストビューには、テーブルレベルと列レベルの両方のリネージの簡略化された表形式の表現と詳細な表形式の表現が表示されます。これは、グラフビューと同期されます。デフォルトでは、簡略化されたリストビューが表示されます。個々のソースとターゲットの関係を分析するために、詳細なリストビューに切り替えることが可能です。表示する列を構成し、リネージデータをエクスポートできます。詳細については、リネージのリスト表示をご覧ください。
Java
import com.google.api.gax.rpc.ApiException;
import com.google.cloud.datacatalog.lineage.v1.BatchSearchLinkProcessesRequest;
import com.google.cloud.datacatalog.lineage.v1.EntityReference;
import com.google.cloud.datacatalog.lineage.v1.EventLink;
import com.google.cloud.datacatalog.lineage.v1.LineageClient;
import com.google.cloud.datacatalog.lineage.v1.LineageEvent;
import com.google.cloud.datacatalog.lineage.v1.Link;
import com.google.cloud.datacatalog.lineage.v1.ListLineageEventsRequest;
import com.google.cloud.datacatalog.lineage.v1.ListRunsRequest;
import com.google.cloud.datacatalog.lineage.v1.LocationName;
import com.google.cloud.datacatalog.lineage.v1.ProcessLinks;
import com.google.cloud.datacatalog.lineage.v1.Run;
import com.google.cloud.datacatalog.lineage.v1.SearchLinksRequest;
import java.io.IOException;
import java.util.ArrayList;
import java.util.HashSet;
import java.util.LinkedList;
import java.util.List;
import java.util.Queue;
import java.util.Set;

public class ViewLineageExample {

  public static void main(String[] args) throws IOException {
    // TODO(developer): Replace these variables before running the sample.
    String projectId = "my-project-id";
    String location = "us";
    String targetFullyQualifiedName = "bigquery:my-project-id.my_dataset.my_table";
    int maxDepth = 3;

    viewLineage(projectId, location, targetFullyQualifiedName, maxDepth);
  }

  static class Node {
    String fqn;
    int depth;
    Node(String fqn, int depth) {
      this.fqn = fqn;
      this.depth = depth;
    }
  }

  public static void viewLineage(
      String projectId, String location, String targetFullyQualifiedName, int maxDepth)
      throws IOException {
    // Initialize client that will be used to send requests. This client only needs
    // to be created once, and can be reused for multiple requests.
    try (LineageClient client = LineageClient.create()) {
      String parent = LocationName.of(projectId, location).toString();

      Set<String> visitedNodes = new HashSet<>();
      Queue<Node> queue = new LinkedList<>();

      visitedNodes.add(targetFullyQualifiedName);
      queue.offer(new Node(targetFullyQualifiedName, 0));

      while (!queue.isEmpty()) {
        Node current = queue.poll();
        System.out.printf("\nExploring node (Depth %d): %s\n", current.depth, current.fqn);

        if (current.depth >= maxDepth) {
          continue;
        }

        EntityReference targetEntity =
            EntityReference.newBuilder().setFullyQualifiedName(current.fqn).build();
        SearchLinksRequest searchLinksRequest =
            SearchLinksRequest.newBuilder().setParent(parent).setTarget(targetEntity).build();

        List<String> linkNames = new ArrayList<>();
        try {
          // 1. Search for links related to the target entity
          for (Link link : client.searchLinks(searchLinksRequest).iterateAll()) {
            linkNames.add(link.getName());
          }
        } catch (ApiException e) {
          System.out.printf("  Failed to retrieve links for %s: %s\n", current.fqn, e.getMessage());
          continue;
        }

        if (linkNames.isEmpty()) {
          continue;
        }

        // 2. Batch search for processes in chunks of 100
        for (int i = 0; i < linkNames.size(); i += 100) {
          List<String> batch = linkNames.subList(i, Math.min(linkNames.size(), i + 100));
          BatchSearchLinkProcessesRequest batchSearchRequest =
              BatchSearchLinkProcessesRequest.newBuilder()
                  .setParent(parent)
                  .addAllLinks(batch)
                  .build();

          try {
            for (ProcessLinks processLinks :
                client.batchSearchLinkProcesses(batchSearchRequest).iterateAll()) {
              String processName = processLinks.getProcess();
              System.out.printf("  Process: %s\n", processName);

              // 3. List runs for the process
              ListRunsRequest runsRequest =
                  ListRunsRequest.newBuilder().setParent(processName).build();
              for (Run run : client.listRuns(runsRequest).iterateAll()) {
                System.out.printf("    Run: %s\n", run.getName());

                // 4. List events for the run
                ListLineageEventsRequest eventsRequest =
                    ListLineageEventsRequest.newBuilder().setParent(run.getName()).build();
                for (LineageEvent event : client.listLineageEvents(eventsRequest).iterateAll()) {
                  for (EventLink eventLink : event.getLinksList()) {
                    String sourceFqn = eventLink.getSource().getFullyQualifiedName();
                    // If exploring upstream, queue the source
                    if (!sourceFqn.isEmpty() && !visitedNodes.contains(sourceFqn)) {
                      visitedNodes.add(sourceFqn);
                      queue.offer(new Node(sourceFqn, current.depth + 1));
                    }
                  }
                }
              }
            }
          } catch (ApiException e) {
            System.out.printf("  Failed to retrieve processes/runs: %s\n", e.getMessage());
          }
        }
      }
    }
  }
}
Python
from google.cloud import datacatalog_lineage_v1
from google.api_core.exceptions import GoogleAPICallError

def view_lineage(project_id: str, location: str, target_fully_qualified_name: str, max_depth: int = 3):
    """Retrieves lineage for a given entity using a depth-limited search."""
    client = datacatalog_lineage_v1.LineageClient()
    parent = f"projects/{project_id}/locations/{location}"

    # Store visited nodes to avoid infinite loops in cyclic graphs
    visited_nodes = set([target_fully_qualified_name])
    queue = [(target_fully_qualified_name, 0)]

    while queue:
        current_node, current_depth = queue.pop(0)
        print(f"\nExploring node (Depth {current_depth}): {current_node}")

        if current_depth >= max_depth:
            continue

        target_entity = datacatalog_lineage_v1.EntityReference(
            fully_qualified_name=current_node
        )
        search_links_request = datacatalog_lineage_v1.SearchLinksRequest(
            parent=parent,
            target=target_entity,
        )

        try:
            links = list(client.search_links(request=search_links_request))
        except GoogleAPICallError as e:
            print(f"  Failed to retrieve links for {current_node}: {e.message}")
            continue

        if not links:
            continue

        # Extract link names to query processes in batches
        link_names = [link.name for link in links]

        # Batch max size is 100
        for i in range(0, len(link_names), 100):
            batch = link_names[i:i + 100]
            batch_request = datacatalog_lineage_v1.BatchSearchLinkProcessesRequest(
                parent=parent,
                links=batch
            )

            try:
                for process_links in client.batch_search_link_processes(request=batch_request):
                    process_name = process_links.process
                    print(f"  Process: {process_name}")

                    runs_request = datacatalog_lineage_v1.ListRunsRequest(parent=process_name)
                    for run in client.list_runs(request=runs_request):
                        print(f"    Run: {run.name}")

                        events_request = datacatalog_lineage_v1.ListLineageEventsRequest(parent=run.name)
                        for event in client.list_lineage_events(request=events_request):
                            for event_link in event.links:
                                source_fqn = event_link.source.fully_qualified_name

                                # If exploring upstream, queue the source
                                if source_fqn and source_fqn not in visited_nodes:
                                    visited_nodes.add(source_fqn)
                                    queue.append((source_fqn, current_depth + 1))

            except GoogleAPICallError as e:
                 print(f"  Failed to retrieve processes/runs: {e.message}")
リネージの可視化を絞り込む
リネージの可視化を絞り込むには、リネージ エクスプローラのハイライト表示とフィルタリングのオプションを使用します。
特定のプロジェクト、データセット、エンティティ名を検索するには、[フィルタ] パネルを使用します。
フィルタを適用すると、フィルタ条件に一致するリネージ ノードが一致ノードと見なされます。一致するノードと一致しないノードの表示方法を調整できます。
リネージ グラフで、[フィルタをクリア] ボタンの横にある [その他の操作] アイコンをクリックして、表示オプションを表示します。
次のいずれかまたは両方を選択します。

両方のオプションを同時に選択することもできます。両方のオプションが選択されている場合、フィルタリングされていないノードは非表示になり、一致するノードはフィルタリングされたグラフビューでハイライト表示されます。
データリネージを無効にする
リネージの追跡を停止し、データリネージの料金が発生しないようにするには、有効になっている各プロジェクトで Data Lineage API(datalineage.googleapis.com)を無効にします。
Dataplex API を無効にしても、データリネージはオフにならず、料金も発生し続けます。Data Lineage API を無効にする必要があります。
データ リネージを無効にするには、次のいずれかのタブを選択し、リネージ トラッキングが有効になっている各プロジェクトの手順を完了します。
コンソール
Google Cloud コンソールで、[有効な API とサービス] ページに移動します。
API のリストで、[Data Lineage API] をクリックします。
[API を無効にする] をクリックします。
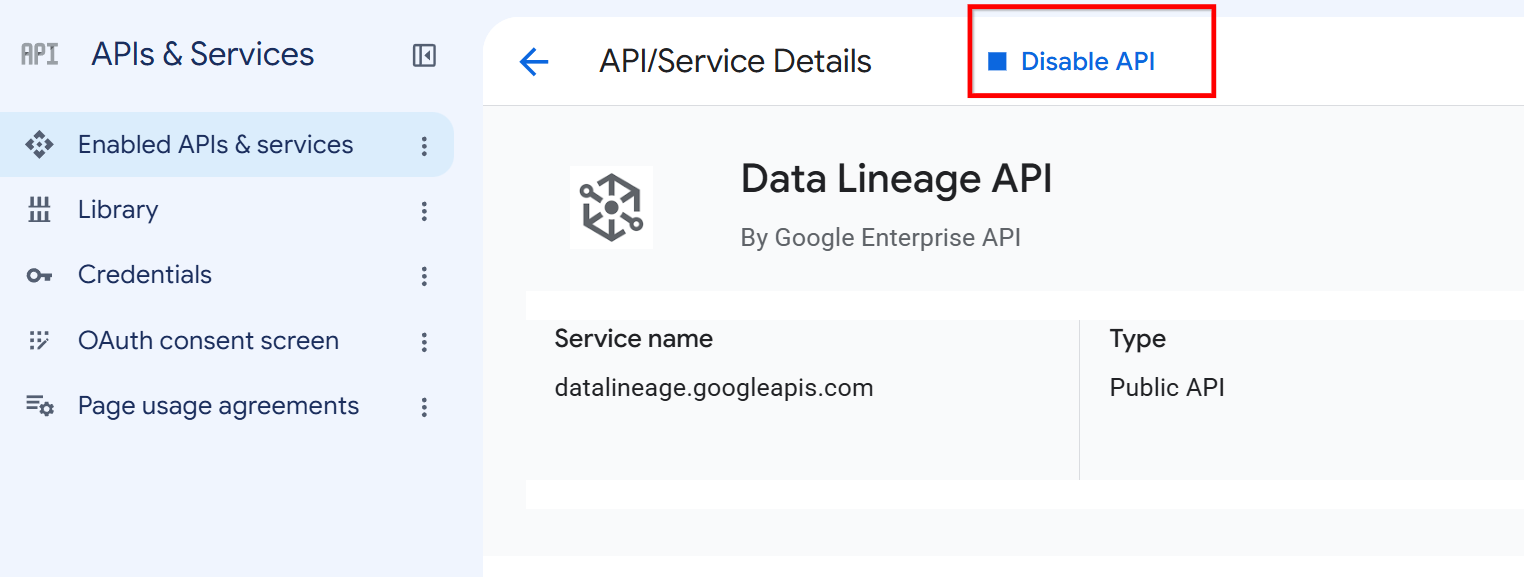
Data Lineage API の詳細ページで [API を無効にする] ボタンを無効にします。 メッセージが表示されたら、[無効にする] をクリックします。
gcloud
Data Lineage API を無効にするには、gcloud services disable コマンドを使用します。
gcloud services disable datalineage.googleapis.com --project=PROJECT_ID
次のように置き換えます。
PROJECT_ID: Google Cloud プロジェクトの ID
API を完全に無効にせずに、特定のサービスのリネージ追跡を停止する場合は、サービスのリネージ取り込みを制御するをご覧ください。
次のステップ
- BigQuery テーブルのコピージョブとクエリジョブのデータリネージを追跡する。
- データリネージ情報モデルについて学習する。
- データリネージに関する考慮事項と制限事項について学習する。
- データリネージの監査ロギングについて学習する。
- データリネージのトラブルシューティングの方法を確認する。
- OpenLineage と統合する方法を確認する。
- Managed Service for Apache Spark でデータリネージを使用する方法を確認する。