


Knowledge Catalog (ehemals Dataplex Universal Catalog) bietet eine einheitliche, strukturierte Plattform zur Metadatenverwaltung für Ihre verteilten Datenbestände. Es erkennt, indexiert und organisiert automatisch technische Strukturen, Geschäftskontext, Messwerte zur Datenqualität und operative Beziehungen.
Durch die Organisation von Metadaten in einem flexiblen, erweiterbaren Metamodell bildet Knowledge Catalog die strukturelle Grundlage des Active Context Graph in der Agentischen Daten-Cloud von Google. Mit diesem Kontextdiagramm können Datenteams Assets erkennen und verwalten und gleichzeitig generative KI-Agents in die Lage versetzen, fundierten, vertrauenswürdigen Geschäftskontext abzurufen.
Knowledge Catalog-Metamodell
Knowledge Catalog organisiert Metadaten über eine modulare Hierarchie von Containern, Assets, Schemas und Beziehungen:
- Container und Assets: Mit Eintragssammlungen werden Einträge organisiert, die einzelne Daten-Assets und ihre Schemaspalten darstellen.
- Strukturierte Anreicherung: Mit Aspekttypen werden Schemas für Aspekte definiert, mit denen Einträgen, Spalten oder Beziehungen strukturierte Metadaten zugewiesen werden.
- Standards und Governance: Mit Eintragstypen werden Vorlagen definiert, mit denen erforderliche Aspekte für Einträge erzwungen werden.
- Beziehungen: Mit Eintragstyp-Links werden Beziehungen (Eintragstyp-Links) definiert, die verknüpfte Einträge und Geschäftsbegriffe verbinden.
In der folgenden Tabelle wird der Unterschied zwischen systemverwalteten Ressourcen (automatisch von Google Cloudbereitgestellt) und benutzerdefinierten Ressourcen zusammengefasst:
| Metamodellelement | Vom System verwaltet (integriert) | Benutzerdefiniert |
|---|---|---|
| Eintragsgruppen | Vordefiniert pro Projekt für Google Cloud -Dienste (z. B. @bigquery, @spanner, @pubsub). |
Von Nutzern erstellt, um benutzerdefinierte Daten-Assets und Berechtigungen zu gruppieren und zu verwalten. |
| Einträge | Wird automatisch aus Google Cloud Quellen (z. B. BigQuery-Tabellen, -Ansichten, -Datasets und -Modellen) ausgefüllt. | Von Nutzern erstellt, um benutzerdefinierte Datenquellen, Dateien oder Datenbanken von Drittanbietern darzustellen. |
| Aspekttypen | Vordefinierte Systemvorlagen (z. B. Schema, Overview, Contacts, DataQuality, Lineage). |
Von Nutzern erstellt, um domainspezifische Metadatenschemas zu definieren (z. B. PII-Klassifizierung oder SLA-Stufen). |
| Aspekte | Sie werden automatisch aus Quellsystemen, Abfragelogs oder automatischen Scans generiert. | Von Nutzern, Pipelines oder KI-Agenten erstellt und an Einträge, Spalten oder Eintragslinks angehängt. |
| Eintragstypen | Vordefinierte Vorlagen, die Google Cloud Ressourcentypen darstellen. | Von Nutzern definiert, um obligatorische und optionale Aspekte für benutzerdefinierte Daten-Assets anzugeben. |
| Eintragslinks | Integrierte Beziehungstypen (z. B. synonym, definition, schema-join, related). |
Instanzen, die zwischen bestimmten Einträgen oder Spalten erstellt werden, um systemübergreifende Verbindungen zu modellieren. |
In den folgenden Abschnitten werden die primären Komponenten des Knowledge Catalog-Metamodells beschrieben.
Eintragsgruppen
Eine Eintragsgruppe (EntryGroup) ist ein regionaler Container für Einträge und Eintragslinks, der als administrative und sicherheitstechnische Grenze für die Verwaltung dieser Ressourcen dient.
Mit Eintragssammlungen können Sie Folgendes konfigurieren:
- IAM-Zugriffssteuerung: Sie können bestimmten Teams Lese- oder Bearbeitungsberechtigungen für eine Eintragsgruppe gewähren, ohne die Berechtigungen für einzelne Einträge zu ändern.
- Standort und Projektzuordnung: Gruppieren Sie Assets nach geografischer Region und Projekteigentümer.
Für Google Cloud -Quellen erstellt Knowledge Catalog automatisch System-Eintragsgruppen pro Projekt (z. B. @bigquery oder @spanner). Für benutzerdefinierte Datenquellen erstellen Sie benutzerdefinierte Eintragsgruppen.
So kann beispielsweise ein Finanzteam eine benutzerdefinierte Eintragsgruppe mit dem Namen production_finance_data erstellen, um die Zugriffsberechtigungen für alle finanzbezogenen benutzerdefinierten Einträge an einem zentralen Ort zu verwalten.
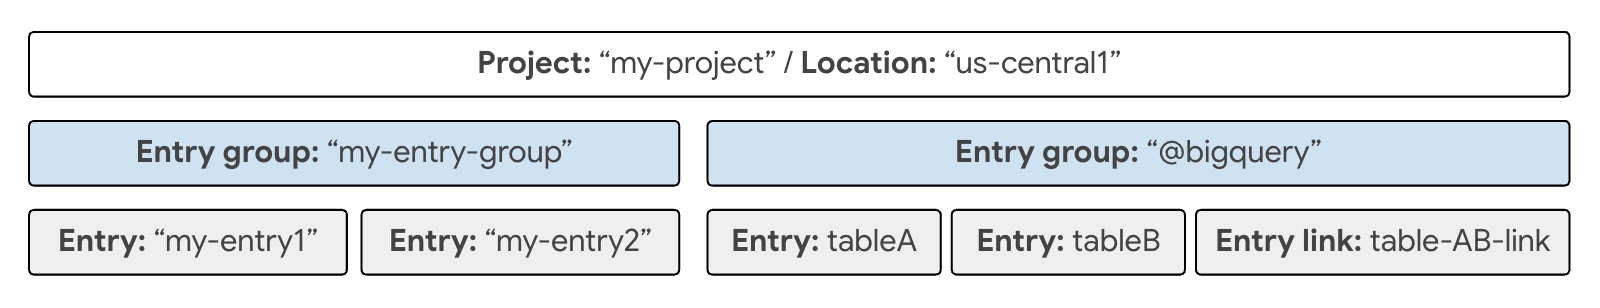
Weitere Informationen finden Sie unter Eintragsgruppen.
Einträge und Schemapfade
Ein Eintrag (Entry) stellt ein einzelnes Daten-Asset dar. Ein Eintrag kann eine strukturierte Datenbanktabelle, ein Analysemodell, eine unstrukturierte Objekttabelle oder ein benutzerdefiniertes externes Dataset darstellen.
Zu den wichtigsten Komponenten eines Eintrags gehören:
- Eintrags-ID: Ein eindeutiger Ressourcenname innerhalb der übergeordneten Eintragsgruppe.
- Eintragstyp: Die Vorlage, die die Struktur des Eintrags und die erforderlichen Aspekte definiert.
- Aspekte: Strukturierte Metadatenattribute, die an den Eintrag angehängt sind.
- Schemapfade (Spalten): Bestimmte Unterabschnitte oder Felder innerhalb des Datenassets, z. B. eine Spalte in einer BigQuery-Tabelle oder ein Feld in einem JSON-Schema.
Mit Spalten können Sie Metadaten an einzelne Felder in einem Asset anhängen. Sie müssen Spalten nicht manuell definieren. Sie werden automatisch ausgefüllt, wenn Sie einem Eintrag einen Aspekt vom Typ schema hinzufügen. Sie können mit Punktnotationspfaden auf verschachtelte Felder verweisen, z. B. customer.address.postal_code.
Eine BigQuery-Tabelle mit dem Namen orders_project.sales.customer_orders wird beispielsweise als Eintrag dargestellt. Um das Feld email_address in dieser Tabelle als vertrauliche Informationen zu beschreiben, hängen Sie einen Klassifizierungsaspekt direkt an den Spaltenpfad email_address an.
Weitere Informationen finden Sie unter Einträge.
Aspekttypen
Ein Aspekttyp (AspectType) ist eine wiederverwendbare Schemavorlage, in der die Felder, Datentypen und Validierungsregeln für einen Aspekt definiert werden. Jeder Aspekt ist eine Instanz eines Aspekttyps.
Aspekttypen können systemdefiniert (von Google Cloudbereitgestellt) oder benutzerdefiniert (von Ihrer Organisation erstellt) sein.
Wenn Sie die metadata_template für einen benutzerdefinierten Aspekttyp definieren, können Sie die folgenden unterstützten Datentypen verwenden:
| Datentyp des Felds | Beschreibung | Anwendungsbeispiel |
|---|---|---|
string |
Textwert (UTF-8). | E‑Mail-Adresse des Inhabers, Label zur Datenklassifizierung, Name der Abteilung. |
integer/number |
Numerische Werte (Ganzzahlen oder Gleitkommazahlen). | Tage der Datenaufbewahrung, SLA-Zielprozentsatz, Prioritätsrang. |
boolean |
Richtig oder falsch? | contains_pii: true, is_certified: false. |
enum |
Eine vordefinierte Liste zulässiger Stringwerte. | Umgebung: ["DEV", "STAGING", "PROD"]. |
datetime/timestamp |
Datum und Uhrzeit im ISO 8601-Format. | Letztes Zertifizierungsdatum, Frist für die Compliance-Überprüfung. |
record |
Ein verschachteltes strukturiertes Objekt mit untergeordneten Feldern. | ContactInfo { name: string, email: string, phone: string }. |
array |
Eine Liste mit wiederholten Werten eines beliebigen primitiven Typs oder Datensatztyps. | Liste der Inhaber sekundärer Daten: ["user1@example.com", "user2@example.com"]. |
map |
Schlüssel/Wert-String-Paare für erweiterbare Attribute. | Benutzerdefinierte Bereitstellungs-Tags: {"cost_center": "1042", "tier": "gold"}. |
Wenn Sie beispielsweise eine wiederverwendbare Vorlage für Kontaktinformationen definieren möchten, können Sie einen Aspekttyp mit dem Namen ContactInfo mit Feldern für owner_name (string), email (string) und support_channel (string) erstellen.
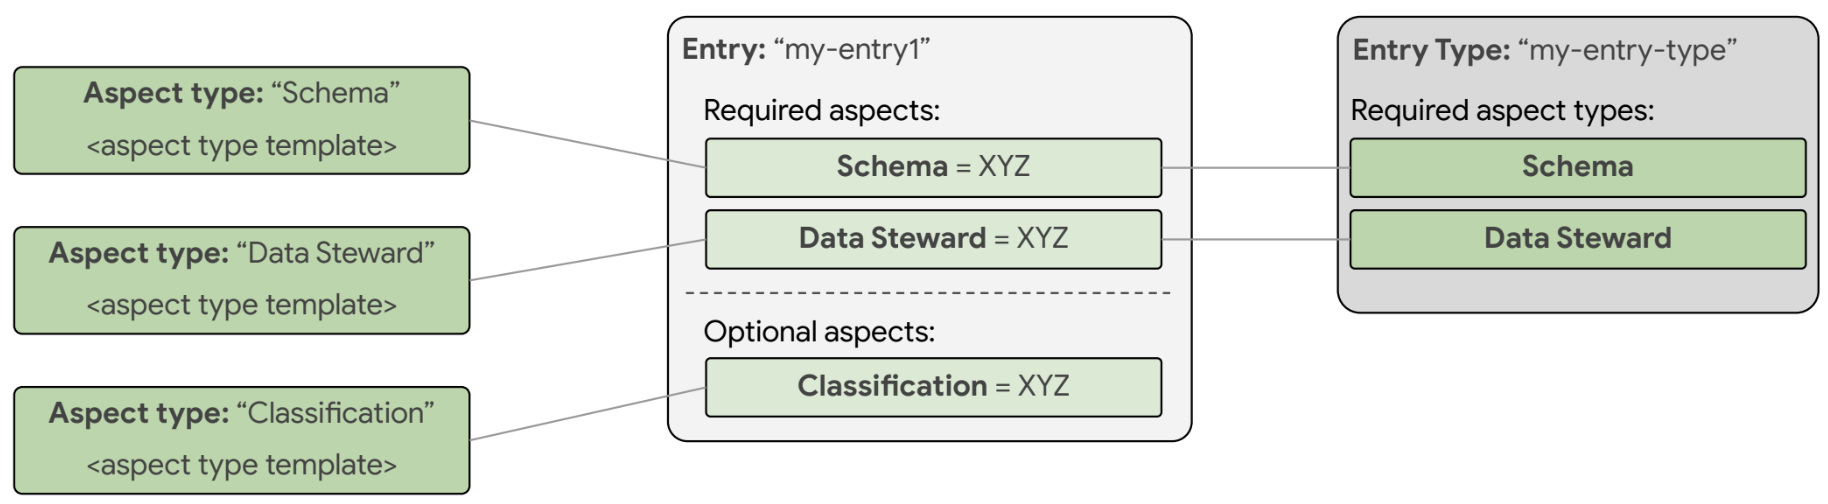
Weitere Informationen finden Sie unter Aspekttypen.
Aspekte
Ein Aspekt (Aspect) ist eine Gruppe von zugehörigen Metadatenfeldern, die einem Aspekttyp entsprechen. Aspekte werden an einen Eintrag, einen Eintragspfad (Spalte) oder einen Eintragslink angehängt, um die Ressource zu beschreiben.
Im Gegensatz zu älteren Tagging-Systemen sind Aspekte im Knowledge Catalog direkt in ihren übergeordneten Einträgen oder Eintragslinks enthalten. So können Sie atomare Lese- und Schreibvorgänge ausführen.
Aspekte werden für mehrere Funktionen verwendet:
- Technische Struktur: Der Aspekt
Schemabeschreibt Tabellenspalten, Datentypen und Beschreibungen. - Geschäftskontext: Benutzerdefinierte Aspekte beschreiben Inhaberschaft, Compliance und Lebenszyklusstatus.
- Operatives Vertrauen: Aspekte der Datenqualität erfassen Ergebnisse automatisierter Regelscans und Validierungsergebnisse.
- Unstrukturierte Entitätsdiagramme: Der Aspekt
GraphProfileerfasst KI-extrahierte Entitäten und Beziehungsränder aus Rohdateien.
Sie können beispielsweise eine Instanz des Aspekttyps ContactInfo mit den Werten {"owner_name": "Alex", "email": "alex@example.com"} erstellen und an den Eintrag customer_orders anhängen.
Weitere Informationen finden Sie unter Aspekte.
Eintragstypen
Ein Eintragstyp (EntryType) ist eine Governance-Vorlage zum Erstellen benutzerdefinierter Einträge. Sie erzwingt die Einhaltung von Metadaten-Qualitätsstandards, indem sie die erforderlichen Aspekttypen festlegt, die einem Eintrag dieses Typs zugeordnet werden müssen.
Wenn Sie einen Eintrag eines bestimmten Eintrags erstellen, prüft Knowledge Catalog, ob alle Aspekttypen, die im Eintragstyp als required markiert sind, vorhanden und gültig sind.
Sie können beispielsweise einen Eintragstyp namens CertifiedDataProduct erstellen, der die Aspekttypen OwnerInfo und DataRetentionPolicy als erforderlich angibt. Jeder neue Eintrag, der mit diesem Eintragstyp erstellt wird, muss diese Aspekte enthalten, bevor Sie ihn speichern können.
Weitere Informationen finden Sie unter Eintragstypen.
Eintragslinks und Eintragslinktypen
Mit einem Eingabelink (EntryLink) wird eine semantische Beziehung zwischen zwei Dateneinträgen oder zwischen bestimmten Spalten innerhalb von Einträgen hergestellt. Jeder Eintragslink ist eine Instanz eines Eintragslinktyps (EntryLinkType).
Eintraglinks können gerichtet oder nicht gerichtet sein:
- Symmetrisch (nicht gerichtet): Beziehungen, in denen beide Seiten gleichberechtigt sind (z. B.
synonym,relatedoderschema-join). - Asymmetrisch (gerichtet): Beziehungen mit einer expliziten Quelle und einem expliziten Ziel (z. B.
definition, mit der ein Begriff aus dem Unternehmensglossar mit einer Tabellenspalte verknüpft wird).
Sie können Aspekte auch direkt an Eintragslinks anhängen (außer an schema-join-Links). So können Sie die Beziehung selbst beschreiben, z. B. indem Sie Vertrauenswerte für den Abgleich von Datensätzen, Transformationsregeln oder Zuordnungsanmerkungen angeben.
Der Knowledge Catalog unterstützt die folgenden integrierten Linktypen für Einträge:
synonym: Verbindet gleichwertige Geschäftskonzepte oder alternative Begriffe.related: Verbindet lose gekoppelte Assets systemübergreifend.definition: Verbindet Definitionen des Unternehmensglossars mit physischen Spalten oder Einträgen.schema-join: Verbindet Tabellen, die über übereinstimmende Fremdschlüssel oder Schemapfade verknüpft werden können.
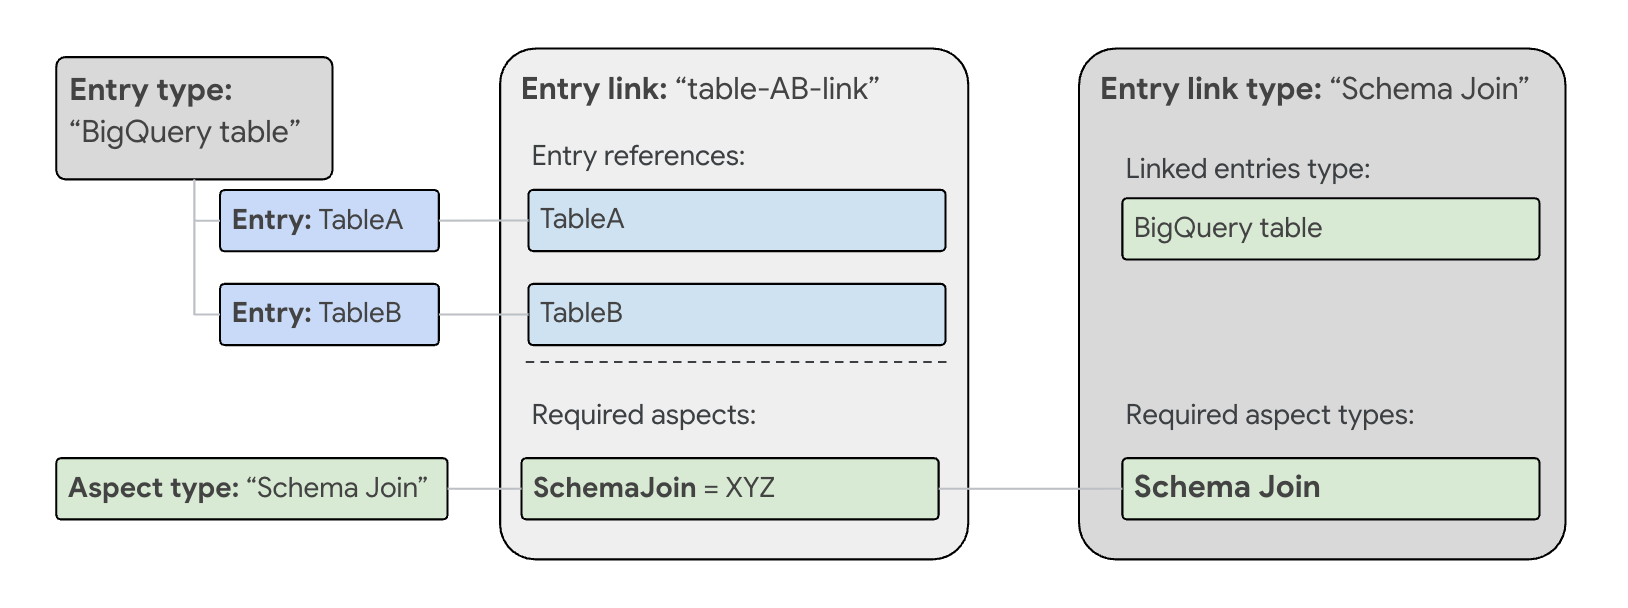
Weitere Informationen finden Sie in der EntryLinks-REST-Referenz.
Unternehmensglossare und ‑begriffe
Mit einem Unternehmensglossar können Sie eine formale Geschäftstaxonomie erstellen, indem Sie Glossare, Kategorien und Geschäftsbegriffe definieren.
Mit Einstiegslinks vom Typ definition oder synonym können Sie Geschäftsbegriffe direkt physischen Einträgen und Spaltenpfaden zuordnen. Wenn Nutzer oder KI-Agents den Katalog in natürlicher Sprache durchsuchen, löst die Suchmaschine diese Geschäftsbegriffe auf, um die richtigen physischen Daten-Assets zu finden.
Weitere Informationen finden Sie unter Geschäftliche Glossare verwalten.
Unterstützte Google Cloud Quellen
Knowledge Catalog nimmt automatisch Metadaten aus den folgendenGoogle Cloud -Quellen auf. Bei einigen Diensten wie AlloyDB for PostgreSQL und Cloud SQL müssen Sie zuerst die Knowledge Catalog-Integration aktivieren, bevor Metadaten aufgenommen werden können:
Analyse und Lakehouse
- BigQuery-Datasets, -Tabellen, -Ansichten, -Modelle, -Routinen, -Verbindungen, -verknüpfte Datasets und Diagramme (Vorschau)
- Datenpools und Einträge in BigQuery Sharing (früher Analytics Hub)
- Dataform-Repositories und Code-Assets
- Dataproc Metastore-Dienste, -Datenbanken und -Tabellen
Iceberg-REST-Katalogtabellen (einschließlich Google Cloud Lakehouse-Laufzeitkatalog, IRC, Databricks Unity IRC, AWS Glue Data Catalog IRC und Snowflake Horizon IRC)
Apache Hive-Tabellen
SAP Business Data Cloud (BDC) Delta Lake-Tabellen
Apache Iceberg-Tabellen, die vom Lakehouse-Laufzeitkatalog verwaltet werden
KI und maschinelles Lernen
- Vertex AI-Modelle, ‑Datasets, ‑Featuregruppen, ‑Featureansichten und ‑Onlinespeicherinstanzen
Business Intelligence
- Looker (Google Cloud Core)-Instanzen, Dashboards, Dashboardelemente, Looks, LookML-Projekte, Modelle, Explores und Ansichten (Vorschau)
Datenbanken
- Bigtable-Instanzen, ‑Cluster und ‑Tabellen (einschließlich Details zur Spaltenfamilie)
- Spanner-Instanzen, ‑Datenbanken, ‑Tabellen und ‑Ansichten
Streaming und Messaging
- Pub/Sub-Themen
Unstrukturierte Daten
Operative Datenbanken
- AlloyDB for PostgreSQL-Cluster, -Instanzen, -Datenbanken, -Schemas, -Tabellen und -Ansichten (Vorabversion). Knowledge Catalog ruft Metadaten nur aus primären AlloyDB-Instanzen, nicht aus Lesereplikaten ab. Weitere Informationen finden Sie unter AlloyDB for PostgreSQL-Ressourcen mit Knowledge Catalog verwalten.
- Cloud SQL-Instanzen, ‑Datenbanken, ‑Schemas, ‑Tabellen und ‑Ansichten. Knowledge Catalog ruft Metadaten nur aus primären Cloud SQL-Instanzen, nicht aus Lesereplikaten ab. Weitere Informationen finden Sie unter Cloud SQL-Ressourcen mit Knowledge Catalog verwalten.
Wenn Sie Metadaten aus einer Drittanbieterquelle in Knowledge Catalog importieren möchten, können Sie Knowledge Catalog-Connectors oder eine Pipeline für verwaltete Verbindungen verwenden. Weitere Informationen finden Sie unter Knowledge Catalog-Connectors und Übersicht über verwaltete Verbindungen.
Projekt- und Standortbeschränkungen
Katalogressourcen in Knowledge Catalog werden in bestimmten Google Cloud -Projekten und geografischen Standorten gespeichert. Es gelten die folgenden Einschränkungen für den Umfang:
| Ressource | Speicherortregel | Projektregel |
|---|---|---|
| Einträge | Der Standort des Eintrags muss mit dem Standort des zugehörigen EntryType übereinstimmen oder das EntryType muss global sein. |
Kann auf globale oder projekteigene Eintragstypen verweisen. |
| Aspekte von Einträgen | Das AspectType des Aspekts muss am selben Ort wie der Eintrag gespeichert werden oder das AspectType muss global sein. |
Kann auf globale oder projektinterne Aspekttypen verweisen. |
| Eintragslinks | Der Speicherort des Einstiegslinks muss mit seinem EntryLinkType übereinstimmen oder das EntryLinkType muss global sein. |
Sie können Einträge verknüpfen, die sich in verschiedenen Projekten innerhalb derselben Organisation befinden. |
| Eintragstypen | Besteht aus Aspekttypen, die am selben Ort wie der Eintragstyp gespeichert sind, oder aus Aspekttypen, die global sind. |
Wenn ein Eintragstyp auf benutzerdefinierte Aspekttypen verweist, müssen sich die Aspekttypen im selben Projekt und am selben Ort befinden. |
Feeds für Metadatenänderungen
Mit Knowledge Catalog können Metadatenänderungsereignisse mithilfe von Metadatenänderungsfeeds in Near-Realtime gestreamt werden.
In einem Feed für Metadatenänderungen werden Benachrichtigungen über das Erstellen, Aktualisieren oder Löschen von Einträgen in einem von Ihnen konfigurierten Pub/Sub-Thema veröffentlicht. Abonnentenclients können diese Ereignisse nutzen, um operative Workflows zu automatisieren, z. B. um Datenqualitätsbewertungen auszulösen, wenn sich ein Schema ändert, oder um nachgelagerte Governance-Dashboards zu aktualisieren.
Weitere Informationen finden Sie unter Metadaten-Änderungsfeeds.
Preise
Knowledge Catalog verwendet die SKU für den Metadatenspeicher, um das gespeicherte Metadatenvolumen in Rechnung zu stellen. Weitere Informationen finden Sie unter Preise für den Knowledge Catalog.
Für Folgendes fallen keine Gebühren an:
- Erstellen und Verwalten von Metamodellressourcen für den Katalog (Eintragstypen, Aspekttypen, Eintragsgruppen, Einträge und Eintragslinks).
- Search API-Aufrufe und Suchanfragen, die in der Google Cloud Console ausgeführt werden.
Nächste Schritte
Einer Tabelle Metadaten hinzufügen
Assets ermitteln und benutzerdefinierte Aspektmetadaten an eine BigQuery-Tabelle anhängen
Benutzerdefinierte Datenquellen aufnehmen
Eintragstypen definieren und benutzerdefinierte Metadaten aus externen Datenbanken und Pipelines aufnehmen
Unternehmensglossare verwalten
Erstellen Sie eine Geschäftstaxonomie und ordnen Sie Begriffe direkt physischen Tabellen und Spalten zu.
Assets suchen und ermitteln
Mit Suchprädikaten können Sie Ressourcen in Google Cloud und benutzerdefinierten Quellen finden.
Kontext für KI-Agents abrufen
LLM-kompatible Metadaten und Active Context abrufen, um generative KI-Agents zu fundieren.
Von Data Catalog umstellen
Migrieren Sie Tag-Vorlagen, benutzerdefinierte Einträge und Workflows zu Knowledge Catalog.