


O Knowledge Catalog (antigo Dataplex Universal Catalog) oferece uma plataforma unificada e estruturada de gerenciamento de metadados em todo o patrimônio de dados distribuídos. Ele descobre, indexa e organiza automaticamente estruturas técnicas, contexto comercial, métricas de qualidade de dados e relações operacionais.
Ao organizar os metadados em um metamodelo flexível e extensível, o Knowledge Catalog estabelece a base estrutural do Active Context Graph na Agentic Data Cloud do Google. Esse gráfico de contexto permite que as equipes de dados descubram e governem recursos, além de capacitar os agentes de IA generativa a recuperar contexto comercial fundamentado e confiável.
Metamodelo do Knowledge Catalog
O Knowledge Catalog organiza os metadados em uma hierarquia modular de contêineres, recursos, esquemas e relacionamentos:
- Contêineres e recursos: os grupos de entradas organizam entradas, que representam recursos de dados individuais e as colunas de esquema deles.
- Enriquecimento estruturado: os tipos de aspectos definem esquemas para aspectos, que anexam metadados estruturados a entradas, colunas ou relacionamentos.
- Padrões e governança: os tipos de entrada definem modelos que aplicam aspectos obrigatórios às entradas.
- Relacionamentos: os tipos de links de entrada definem relacionamentos (links de entrada) que conectam entradas e termos comerciais relacionados.
A tabela a seguir resume a distinção entre recursos gerenciados pelo sistema (fornecidos automaticamente pelo Google Cloud) e recursos personalizados definidos pelo usuário:
| Elemento de metamodelo | Gerenciada pelo sistema (integrada) | Definido pelo usuário (personalizado) |
|---|---|---|
| Grupos de entradas | Predefinido por projeto para serviços do Google Cloud (por exemplo,
@bigquery, @spanner, @pubsub). |
Criados por usuários para agrupar e gerenciar permissões e recursos de dados personalizados. |
| Entradas | Preenchido automaticamente com base em fontes do Google Cloud (como tabelas, visualizações, conjuntos de dados e modelos do BigQuery). | Criadas pelos usuários para representar fontes de dados, arquivos ou bancos de dados de terceiros personalizados. |
| Tipos de aspecto | Modelos de sistema predefinidos (por exemplo, Schema,
Overview, Contacts, DataQuality,
Lineage). |
Criados por usuários para definir esquemas de metadados específicos do domínio, como classificação de PII ou níveis de SLA. |
| Aspectos | Preenchidos automaticamente com base em sistemas de origem, registros de consultas ou verificações automatizadas. | Criados por usuários, pipelines ou agentes e anexados a entradas, colunas ou links de entrada. |
| Tipos de entrada | Modelos predefinidos que representam tipos de recursos Google Cloud . | Definido pelos usuários para especificar aspectos obrigatórios e opcionais dos recursos de dados personalizados. |
| Links de entrada | Tipos de relacionamento integrados (como synonym,
definition, schema-join,
related). |
Instâncias criadas entre entradas ou colunas específicas para modelar conexões entre sistemas. |
As seções a seguir descrevem os principais componentes que formam o metamodelo do Knowledge Catalog.
Grupos de entradas
Um grupo de entradas (EntryGroup) é um contêiner regional para entradas e links de entrada que funciona como o limite administrativo e de segurança para gerenciar esses recursos.
Use grupos de entradas para configurar o seguinte:
- Controle de acesso do gerenciamento de identidade e acesso: conceda permissões de visualização ou edição a equipes específicas em um grupo de entradas sem modificar as permissões individuais.
- Atribuição de local e projeto: agrupe os recursos por região geográfica e propriedade do projeto.
Para fontes do Google Cloud , o Knowledge Catalog cria automaticamente grupos de entradas do sistema por projeto, como @bigquery ou @spanner. Para fontes de dados personalizadas, você cria grupos de entradas personalizados.
Por exemplo, uma equipe financeira pode criar um grupo de entradas personalizadas chamado
production_finance_data para gerenciar permissões de acesso a todas as entradas personalizadas
relacionadas a finanças em um único local.
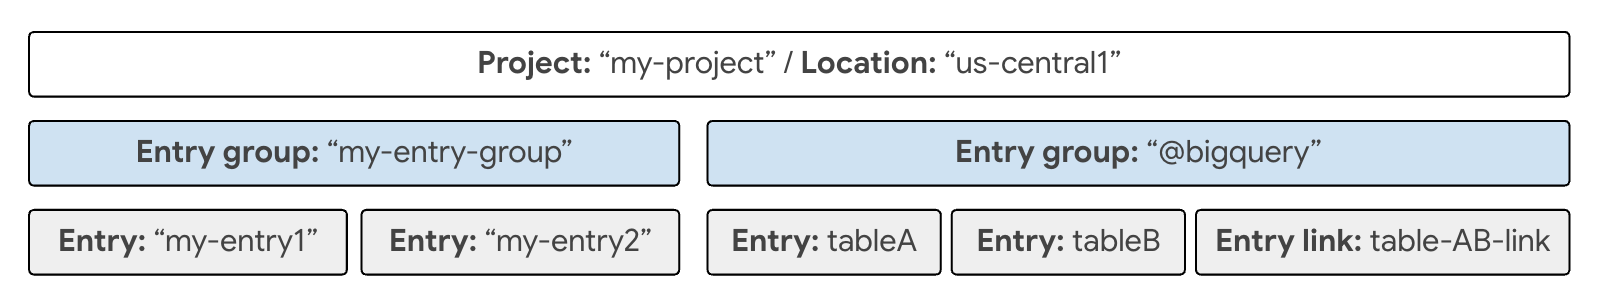
Para mais informações, consulte Grupos de entradas.
Entradas e caminhos de esquema
Uma entrada (Entry) representa um único recurso de dados. Uma entrada pode representar uma tabela de banco de dados estruturada, um modelo analítico, uma tabela de objetos não estruturada ou um conjunto de dados externo personalizado.
Os principais componentes de uma entrada incluem:
- Identificador da entrada: um nome de recurso exclusivo no grupo de entradas principal.
- Tipo de entrada: o modelo que define a estrutura da entrada e os aspectos obrigatórios.
- Aspectos: atributos de metadados estruturados anexados à entrada.
- Caminhos de esquema (colunas): subseções ou campos específicos no recurso de dados, como uma coluna em uma tabela do BigQuery ou um campo em um esquema JSON.
Com as colunas, é possível anexar metadados a campos individuais em um recurso. Você não define colunas manualmente. Elas são preenchidas quando você anexa um aspecto do tipo schema a uma entrada. É possível fazer referência a campos aninhados usando caminhos de notação por pontos (por exemplo, customer.address.postal_code).
Por exemplo, uma tabela do BigQuery chamada
orders_project.sales.customer_orders é representada como uma entrada. Para descrever o campo email_address na tabela como contendo informações sensíveis, anexe um aspecto de classificação diretamente ao caminho da coluna email_address.
Para mais informações, consulte Entradas.
Tipos de aspecto
Um tipo de aspecto (AspectType) é um modelo de esquema reutilizável que define os campos, os tipos de dados e as regras de validação de um aspecto. Todo aspecto é uma instância de um tipo de aspecto.
Os tipos de aspecto podem ser definidos pelo sistema (fornecidos por Google Cloud) ou personalizados (criados pela sua organização).
Ao definir o metadata_template para um tipo de aspecto personalizado, você pode usar os seguintes tipos de dados compatíveis:
| Tipo de dados do campo | Descrição | Exemplo de caso de uso: |
|---|---|---|
string |
Valor do texto (UTF-8). | E-mail do proprietário, rótulo de classificação de dados, nome do departamento. |
integer / number |
Valores numéricos (inteiros ou de ponto flutuante). | Dias de retenção de dados, porcentagem da meta de SLA, classificação de prioridade. |
boolean |
Flag booleana. | contains_pii: true, is_certified: false. |
enum |
Uma lista predefinida de valores de string permitidos. | Ambiente: ["DEV", "STAGING", "PROD"]. |
datetime / timestamp |
Data e hora formatadas no padrão ISO 8601. | Data da última certificação, prazo da análise de compliance. |
record |
Um objeto estruturado aninhado que contém campos filhos. | ContactInfo { name: string, email: string, phone: string }. |
array |
Uma lista de valores repetidos de qualquer tipo primitivo ou de registro. | Lista de proprietários de dados secundários: ["user1@example.com", "user2@example.com"]. |
map |
Pares de string de chave-valor para atributos extensíveis. | Tags de implantação personalizadas: {"cost_center": "1042", "tier": "gold"}. |
Por exemplo, para definir um modelo reutilizável de dados de contato, crie um tipo de aspecto chamado ContactInfo com campos para owner_name (string), email (string) e support_channel (string).

Para mais informações, consulte Tipos de aspectos.
Aspectos
Um aspecto (Aspect) é um conjunto de campos de metadados relacionados que estão de acordo com um tipo de aspecto. Os aspectos são anexados a uma entrada, um caminho de entrada (coluna) ou um link de entrada para descrever esse recurso.
Ao contrário dos sistemas de inclusão de tags legados, os aspectos no Knowledge Catalog são encapsulados diretamente nas entradas principais ou nos links de entrada, o que permite realizar operações atômicas de leitura e gravação.
Os aspectos são usados em várias funções:
- Estrutura técnica: o aspecto
Schemadescreve colunas de tabelas, tipos de dados e descrições. - Contexto comercial: aspectos personalizados descrevem propriedade, compliance e status do ciclo de vida.
- Confiança operacional: os aspectos de qualidade de dados registram resultados de verificação de regras automatizadas e pontuações de validação.
- Grafos de entidades não estruturados: o aspecto
GraphProfilecaptura entidades e arestas de relacionamento extraídas por IA de arquivos brutos.
Por exemplo, é possível criar uma instância do tipo de aspecto ContactInfo com os valores {"owner_name": "Alex", "email": "alex@example.com"} e anexá-la à entrada customer_orders.
Para mais informações, consulte Aspectos.
Tipos de entrada
Um tipo de entrada (EntryType) é um modelo de governança para criar entradas personalizadas. Ele aplica padrões de qualidade de metadados ao estabelecer os tipos de aspectos obrigatórios que precisam ser anexados a uma entrada desse tipo.
Ao criar uma entrada de um tipo específico, o Knowledge Catalog valida se todos os tipos de aspectos marcados como required no tipo de entrada estão presentes e são válidos.
Por exemplo, é possível criar um tipo de entrada chamado CertifiedDataProduct
que especifica os tipos de aspectos OwnerInfo e DataRetentionPolicy como
obrigatórios. Qualquer nova entrada criada com esse tipo precisa incluir esses aspectos antes de ser salva.
Para mais informações, consulte Tipos de entradas.
Links e tipos de link de entrada
Um link de entrada (EntryLink) estabelece uma relação semântica entre duas entradas de dados ou entre colunas específicas dentro das entradas. Cada link de entrada é uma instância de um tipo de link de entrada (EntryLinkType).
Os links de entrada podem ser direcionais ou não direcionais:
- Simétricas (não direcionais): relacionamentos em que os dois lados são iguais (por exemplo,
synonym,relatedouschema-join). - Assimétricas (direcionais): relações com uma origem e um destino explícitos (por exemplo,
definition, vinculando um termo de glossário empresarial a uma coluna de tabela).
Você também pode anexar aspectos diretamente aos links de entrada, exceto os links schema-join. Isso permite descrever a relação em si, como registrar pontuações de confiança de junção, regras de transformação ou notas de mapeamento.
O Knowledge Catalog é compatível com os seguintes tipos de links de entrada integrados:
synonym: conecta conceitos de negócios equivalentes ou termos alternativos.related: conecta recursos acoplado com flexibilidade em vários sistemas.definition: conecta definições do glossário empresarial a colunas físicas ou entradas.schema-join: conecta tabelas que podem ser unidas ao longo de chave externa ou caminhos de esquema correspondentes.

Para mais informações, consulte a
referência REST de EntryLinks.
Glossários e termos comerciais
Com um glossário empresarial, é possível estabelecer uma taxonomia formal definindo glossários, categorias e termos comerciais.
Usando links de entrada do tipo definition ou synonym, é possível mapear termos comerciais diretamente para entradas físicas e caminhos de coluna. Quando os usuários ou agentes de IA pesquisam
o catálogo usando linguagem natural, o mecanismo de pesquisa resolve esses termos
comerciais para localizar os recursos de dados físicos corretos.
Para mais informações, consulte Gerenciar glossários comerciais.
Fontes Google Cloud compatíveis
O Knowledge Catalog ingere automaticamente metadados das seguintes fontes do Google Cloud . Para alguns serviços, como o AlloyDB para PostgreSQL e o Cloud SQL, é necessário ativar a integração do Knowledge Catalog antes que os metadados possam ser ingeridos:
Analytics e lakehouse
- Conjuntos de dados, tabelas, visualizações, modelos, rotinas, conexões, conjuntos de dados vinculados e gráficos do BigQuery (prévia)
- Trocas e listagens do BigQuery Sharing (antigo Analytics Hub)
- Repositórios do Dataform e recursos de código
- Serviços, bancos de dados e tabelas do Dataproc Metastore
Tabelas do catálogo REST do Iceberg (incluindo Google Cloud o catálogo de ambientes de execução do Lakehouse IRC, o IRC do Databricks Unity, o IRC do Data Catalog do AWS Glue e o IRC do Snowflake Horizon)
Tabelas do Apache Hive
Tabelas do Delta Lake do SAP Business Data Cloud (BDC)
Tabelas do Apache Iceberg gerenciadas pelo catálogo do ambiente de execução do Lakehouse
IA e machine learning
- Modelos, conjuntos de dados, grupos de recursos, visualizações de recursos e instâncias de loja on-line da Vertex AI
Business intelligence
- Instâncias, painéis, elementos de painel, Looks, projetos, modelos, Análises e visualizações do Looker (Google Cloud Core) (prévia)
Bancos de dados
- Instâncias, clusters e tabelas do Bigtable (incluindo detalhes do grupo de colunas)
- Instâncias, bancos de dados, tabelas e visualizações do Spanner
Streaming e mensagens
- Tópicos do Pub/Sub
Dados não estruturados
Bancos de dados operacionais
- Clusters, instâncias, bancos de dados, esquemas, tabelas e visualizações do AlloyDB para PostgreSQL (pré-lançamento). O Knowledge Catalog recupera metadados somente das instâncias principais do AlloyDB e não de réplicas de leitura. Para mais informações, consulte Gerenciar recursos do AlloyDB para PostgreSQL usando o Knowledge Catalog.
- Instâncias, bancos de dados, esquemas, tabelas e visualizações do Cloud SQL. O Knowledge Catalog recupera metadados somente das instâncias principais do Cloud SQL e não de réplicas de leitura. Para mais informações, consulte Gerenciar recursos do Cloud SQL usando o Knowledge Catalog.
Para importar metadados de uma fonte terceirizada para o Knowledge Catalog, use os conectores do Knowledge Catalog ou um pipeline de conectividade gerenciada. Para mais informações, consulte Sobre os conectores do Knowledge Catalog e Visão geral da conectividade gerenciada.
Restrições de projeto e local
Os recursos do Knowledge Catalog estão localizados em projetos Google Cloud e regiões geográficas específicas. As seguintes restrições de escopo são aplicáveis:
| Recurso | Regra de local | Regra do projeto |
|---|---|---|
| Entradas | O local da entrada precisa corresponder ao local do EntryType ou o EntryType precisa ser global. |
Pode referenciar tipos de entrada globais ou do mesmo projeto. |
| Aspectos das entradas | O AspectType do aspecto precisa ser armazenado no mesmo local
que a entrada, ou o AspectType precisa ser global. |
Pode referenciar tipos de aspectos globais ou do mesmo projeto. |
| Links de entrada | O local do link de entrada precisa corresponder ao EntryLinkType ou
o EntryLinkType precisa ser global. |
É possível vincular entradas que residem em diferentes projetos na mesma organização. |
| Tipos de entrada | Composto por tipos de aspecto armazenados no mesmo local do tipo de entrada ou tipos de aspecto que são global. |
Se um tipo de entrada fizer referência a tipos personalizados de aspecto, eles precisarão estar no mesmo projeto e local. |
Feeds de mudanças de metadados
O Knowledge Catalog pode transmitir eventos de mudança de metadados em quase tempo real usando feeds de mudança de metadados.
Um feed de mudanças de metadados publica notificações sobre criação, atualizações ou exclusão de entradas em um tópico do Pub/Sub que você configura. Os clientes assinantes podem consumir esses eventos para automatizar fluxos de trabalho operacionais, como acionar avaliações de qualidade de dados quando um esquema muda ou atualizar dashboards de governança downstream.
Para mais informações, consulte Sobre feeds de mudanças de metadados.
Preços
O Knowledge Catalog usa a SKU de armazenamento de metadados para cobrar pelo volume de metadados armazenados. Para mais informações, consulte Preços do Knowledge Catalog.
Não há cobranças pelos seguintes itens:
- Criar e gerenciar recursos do metamodelo do catálogo (tipos de entrada, tipos de aspecto, grupos de entrada, entradas e links de entrada).
- Chamadas de API de pesquisa e consultas de pesquisa realizadas no console Google Cloud .
A seguir
Adicionar metadados a uma tabela
Descubra recursos e anexe metadados de aspecto personalizados a uma tabela do BigQuery.
Ingerir fontes de dados personalizadas
Definir tipos de entrada e ingerir metadados personalizados de bancos de dados e pipelines externos.
Gerenciar glossários de negócios
Crie uma taxonomia de negócios e mapeie termos diretamente para tabelas e colunas físicas.
Pesquisar e descobrir recursos
Descubra recursos no Google Cloud e em fontes personalizadas usando predicados de pesquisa.
Recuperar contexto para agentes de IA
Recupere metadados prontos para LLM e contexto ativo para embasar agentes de IA generativa.
Fazer a transição do Data Catalog
Migre modelos de tags, entradas personalizadas e fluxos de trabalho para o Knowledge Catalog.