


Knowledge Catalog (in precedenza Dataplex Universal Catalog) fornisce una piattaforma di gestione dei metadati unificata e strutturata in tutta la tua proprietà di dati distribuita. Rileva, indicizza e organizza automaticamente strutture tecniche, contesto aziendale, metriche sulla qualità dei dati e relazioni operative.
Organizzando i metadati in un metamodello flessibile ed estensibile, Knowledge Catalog stabilisce la base strutturale dell'Active Context Graph all'interno dell'Agentic Data Cloud di Google. Questo grafico contestuale consente ai team di dati di scoprire e gestire gli asset, consentendo al contempo agli agenti AI generativi di recuperare un contesto aziendale fondato e affidabile.
Metamodello di Knowledge Catalog
Knowledge Catalog organizza i metadati tramite una gerarchia modulare di contenitori, asset, schemi e relazioni:
- Contenitori e asset: i gruppi di voci organizzano le voci, che rappresentano singoli asset di dati e le relative colonne dello schema.
- Arricchimento strutturato: i tipi di aspetto definiscono gli schemi per gli aspetti, che collegano metadati strutturati a voci, colonne o relazioni.
- Standard e governance: i tipi di voce definiscono modelli che applicano gli aspetti obbligatori alle voci.
- Relazioni: i tipi di link delle voci definiscono le relazioni (link delle voci) che collegano le voci correlate e i termini commerciali.
La seguente tabella riassume la distinzione tra le risorse gestite dal sistema (fornite automaticamente da Google Cloud) e le risorse personalizzate definite dall'utente:
| Elemento metamodello | Gestito dal sistema (integrato) | Definito dall'utente (personalizzato) |
|---|---|---|
| Gruppi di voci | Predefinito per progetto per i servizi Google Cloud (ad esempio,
@bigquery, @spanner, @pubsub). |
Creati dagli utenti per raggruppare e gestire asset di dati personalizzati e autorizzazioni. |
| Voci | Compilato automaticamente dalle origini Google Cloud (ad esempio tabelle, viste, set di dati e modelli BigQuery). | Creati dagli utenti per rappresentare origini dati, file o database di terze parti personalizzati. |
| Tipi di aspetto | Modelli di sistema predefiniti (ad esempio, Schema,
Overview, Contacts, DataQuality,
Lineage). |
Creati dagli utenti per definire schemi di metadati specifici del dominio (ad esempio classificazione delle PII o livelli SLA). |
| Aspetti | Compilati automaticamente da sistemi di origine, log delle query o scansioni automatiche. | Creati da utenti, pipeline o agenti e allegati a voci, colonne o link alle voci. |
| Tipi di voci | Modelli predefiniti che rappresentano Google Cloud i tipi di risorse. | Definiti dagli utenti per specificare gli aspetti obbligatori e facoltativi per gli asset di dati personalizzati. |
| Entry links | Tipi di relazione integrati (ad es. synonym,
definition, schema-join,
related). |
Istanze create tra voci o colonne specifiche per modellare le connessioni tra sistemi. |
Le sezioni seguenti descrivono i componenti principali che costituiscono il metamodello del Knowledge Catalog.
Gruppi di voci
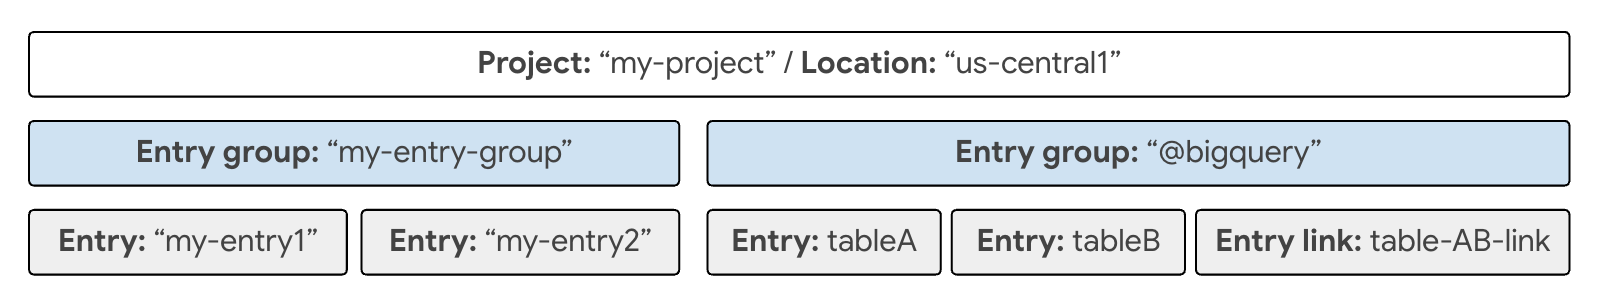
Un gruppo di voci (EntryGroup) è un container regionale per le voci e i relativi link che funge da limite amministrativo e di sicurezza per la gestione di queste risorse.
Utilizza i gruppi di voci per configurare quanto segue:
- Controllo dell'accesso di Identity and Access Management: concedi le autorizzazioni di visualizzazione o modifica a team specifici di un gruppo di voci senza modificare le autorizzazioni delle singole voci.
- Attribuzione di posizione e progetto: raggruppa gli asset in base alla regione geografica e alla proprietà del progetto.
Per le origini Google Cloud , Knowledge Catalog crea
automaticamente gruppi di voci di sistema per progetto (ad esempio @bigquery o
@spanner). Per le origini dati personalizzate, crei gruppi di voci personalizzati.
Ad esempio, un team finanziario può creare un gruppo di voci personalizzate denominato
production_finance_data per gestire le autorizzazioni di accesso per tutte le voci personalizzate
relative alla finanza in un'unica posizione.
Per saperne di più, consulta Gruppi di voci.
Voci e percorsi dello schema
Una voce (Entry) rappresenta una singola risorsa di dati. Una voce può rappresentare una
tabella di database strutturata, un modello analitico, una tabella di oggetti non strutturati o
un set di dati esterno personalizzato.
I componenti chiave di una voce includono quanto segue:
- Identificatore della voce: un nome di risorsa univoco all'interno del gruppo di voci principale.
- Tipo di voce: il modello che definisce la struttura della voce e gli aspetti obbligatori.
- Aspetti: attributi dei metadati strutturati collegati alla voce.
- Percorsi dello schema (colonne): sezioni o campi specifici all'interno dell'asset di dati, ad esempio una colonna in una tabella BigQuery o un campo in uno schema JSON.
Le colonne consentono di collegare i metadati a singoli campi all'interno di un asset. Non
definisci manualmente le colonne, che vengono compilate quando colleghi un aspetto di tipo
schema a una voce. Puoi fare riferimento ai campi nidificati utilizzando i percorsi di notazione con il punto
(ad esempio, customer.address.postal_code).
Ad esempio, una tabella BigQuery denominata
orders_project.sales.customer_orders è rappresentata come una voce. Per descrivere
il campo email_address all'interno di quella tabella come contenente informazioni sensibili, devi collegare un aspetto di classificazione direttamente al percorso della colonna email_address.
Per ulteriori informazioni, consulta la sezione Voci.
Tipi di aspetto
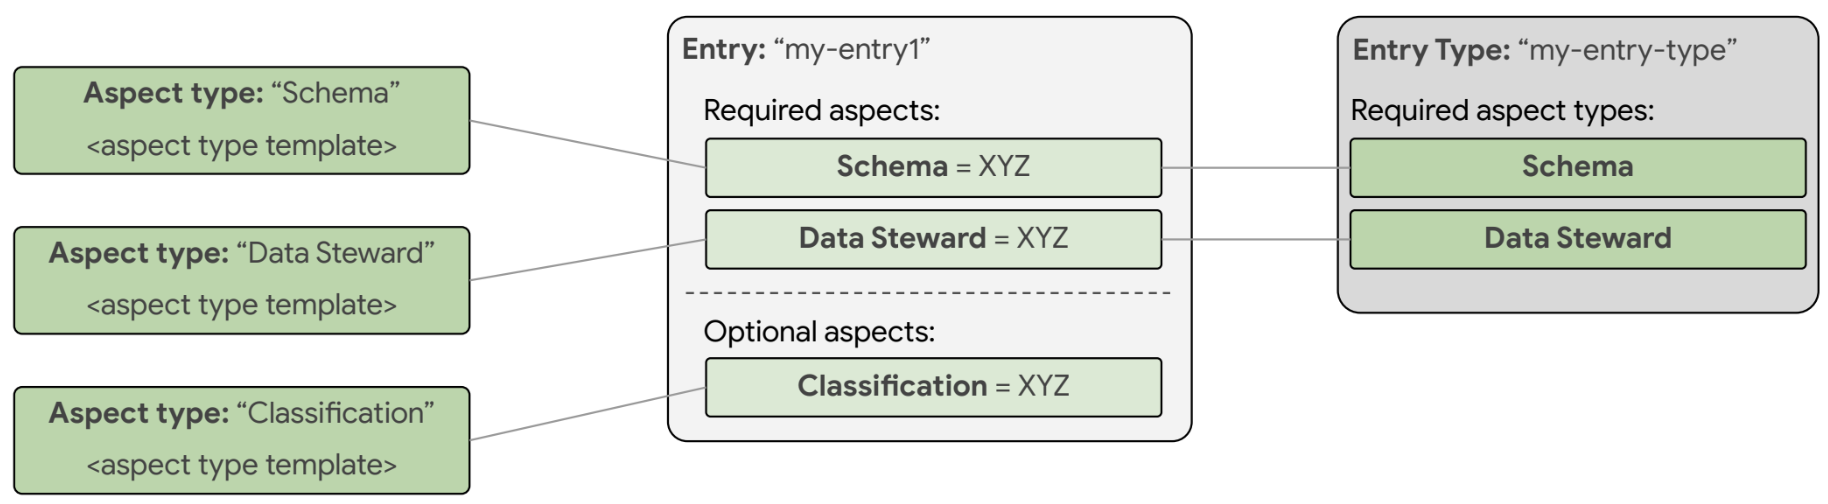
Un tipo di aspetto (AspectType) è un modello di schema riutilizzabile che definisce i campi, i tipi di dati e le regole di convalida per un aspetto. Ogni aspetto è un'istanza di un tipo di aspetto.
I tipi di aspetto possono essere definiti dal sistema (forniti da Google Cloud) o personalizzati (creati dalla tua organizzazione).
Quando definisci metadata_template per un tipo di aspetto personalizzato, puoi utilizzare
i seguenti tipi di dati supportati:
| Tipo di dati del campo | Descrizione | Caso d'uso di esempio |
|---|---|---|
string |
Valore di testo (UTF-8). | Email del proprietario, etichetta di classificazione dei dati, nome del reparto. |
integer/number |
Valori numerici (numeri interi o in rappresentazione in virgola mobile). | Giorni di conservazione dei dati, percentuale target del contratto di servizio, ranking di priorità. |
boolean |
Vero o falso. | contains_pii: true, is_certified: false. |
enum |
Un elenco predefinito di valori stringa consentiti. | Ambiente: ["DEV", "STAGING", "PROD"]. |
datetime/timestamp |
Data e ora nel formato ISO 8601. | Ultima data di certificazione, scadenza della revisione della conformità. |
record |
Un oggetto strutturato nidificato contenente campi secondari. | ContactInfo { name: string, email: string, phone: string }. |
array |
Un elenco di valori ripetuti di qualsiasi tipo primitivo o record. | Elenco dei proprietari dei dati secondari: ["user1@example.com", "user2@example.com"]. |
map |
Coppie di stringhe chiave-valore per gli attributi estensibili. | Tag di deployment personalizzati: {"cost_center": "1042", "tier": "gold"}. |
Ad esempio, per definire un modello riutilizzabile per i dati di contatto, puoi
creare un tipo di aspetto denominato ContactInfo con campi per owner_name
(string), email (string) e support_channel (string).
Per saperne di più, vedi Tipi di asset.
Aspetti
Un aspetto (Aspect) è un insieme di campi di metadati correlati conformi a un
tipo di aspetto. Gli aspetti sono collegati a una voce, a un percorso di voce (colonna) o a un
link di voce per descrivere la risorsa.
A differenza dei sistemi di tagging legacy, gli aspetti del catalogo della conoscenza sono incapsulati direttamente all'interno delle voci principali o dei link alle voci, il che ti consente di eseguire operazioni di lettura e scrittura atomiche.
Gli aspetti vengono utilizzati in più funzioni:
- Struttura tecnica: l'aspetto
Schemadescrive le colonne della tabella, i tipi di dati e le descrizioni. - Contesto aziendale: gli aspetti personalizzati descrivono la proprietà, la conformità e lo stato del ciclo di vita.
- Affidabilità operativa: gli aspetti della qualità dei dati registrano i risultati della scansione delle regole automatizzate e i punteggi di convalida.
- Grafici di entità non strutturati: l'aspetto
GraphProfileacquisisce entità e bordi di relazione estratti con l'AI dai file non elaborati.
Ad esempio, puoi creare un'istanza del tipo di aspetto ContactInfo con i valori {"owner_name": "Alex", "email": "alex@example.com"} e collegarla alla voce customer_orders.
Per saperne di più, consulta Aspetti.
Tipi di voci
Un tipo di voce (EntryType) è un modello di governance per la creazione di voci personalizzate. Applica gli standard di qualità dei metadati stabilendo i tipi di aspetto obbligatori che devono essere allegati a una voce di quel tipo.
Quando crei una voce di un tipo specifico,
Knowledge Catalog verifica che tutti i tipi di aspetto
contrassegnati come required nel tipo di voce siano presenti e validi.
Ad esempio, puoi creare un tipo di voce denominato CertifiedDataProduct
che specifica i tipi di aspetto OwnerInfo e DataRetentionPolicy come
obbligatori. Qualsiasi nuova voce creata con questo tipo di voce deve includere questi aspetti
prima di poterla salvare.
Per saperne di più, consulta Tipi di voci.
Link delle voci e tipi di link delle voci
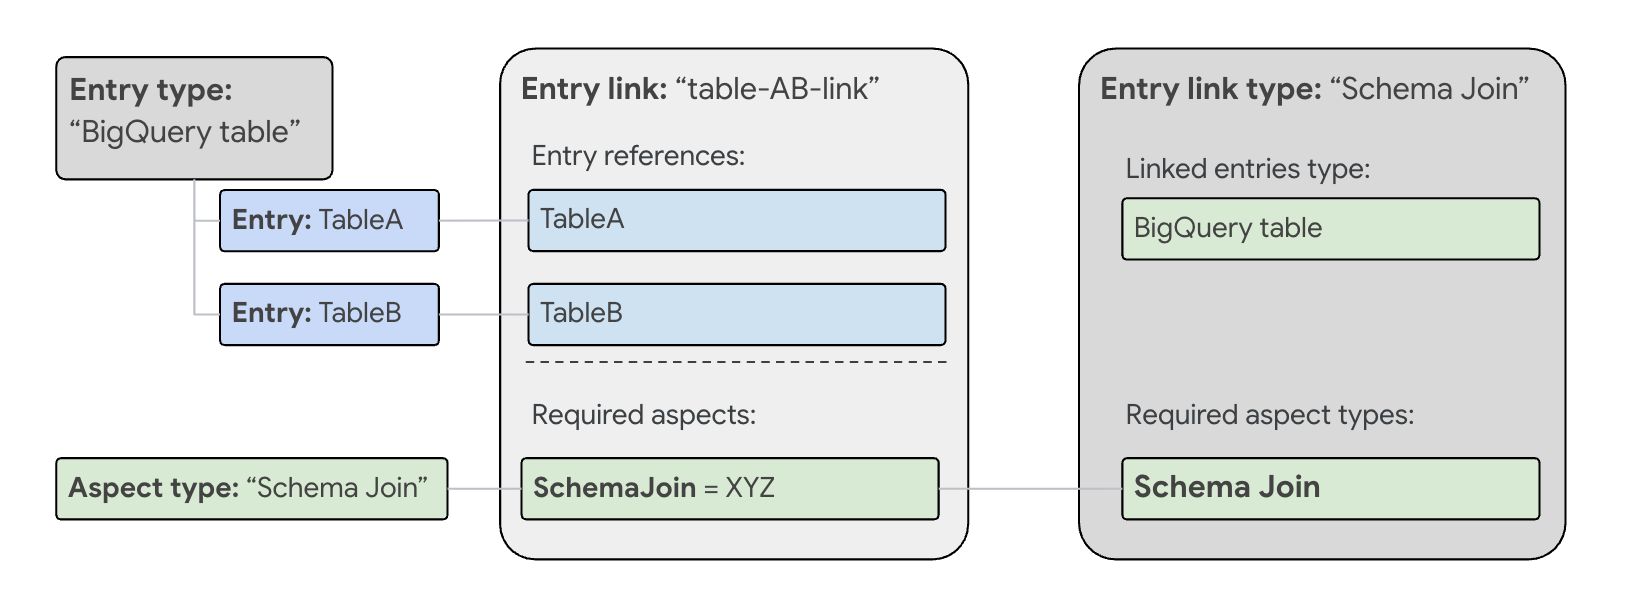
Un link di voce (EntryLink) stabilisce una relazione semantica tra due voci di dati o tra colonne specifiche all'interno delle voci. Ogni link della voce è un'istanza di un tipo di link della voce (EntryLinkType).
I link di ingresso possono essere direzionali o non direzionali:
- Simmetriche (non direzionali): relazioni in cui entrambe le parti sono peer
(ad esempio
synonym,relatedoschema-join). - Asimmetriche (direzionali): relazioni con un'origine e una destinazione esplicite (ad esempio,
definition, che collega un termine del glossario aziendale a una colonna della tabella).
Puoi anche allegare aspetti direttamente ai link delle voci (ad eccezione dei link schema-join). Ciò ti consente di descrivere la relazione stessa, ad esempio registrando i punteggi di confidenza dell'unione, le regole di trasformazione o le note di mappatura.
Knowledge Catalog supporta i seguenti tipi di link di voci integrati:
synonym: collega concetti aziendali equivalenti o termini alternativi.related: collega risorse con a basso accoppiamento tra i sistemi.definition: Collega le definizioni del glossario aziendale a colonne o voci fisiche.schema-join: Collega le tabelle che possono essere unite lungo percorsi di chiave esterna o schemi corrispondenti.
Per saperne di più, consulta il riferimento REST EntryLinks.
Glossari e termini aziendali
Un glossario aziendale ti consente di stabilire una tassonomia aziendale formale definendo glossari, categorie e termini aziendali.
Utilizzando i link di accesso di tipo definition o synonym, puoi mappare i termini aziendali
direttamente alle voci fisiche e ai percorsi delle colonne. Quando gli utenti o gli agenti di AI cercano
nel catalogo utilizzando il linguaggio naturale, il motore di ricerca risolve questi termini
aziendali per individuare gli asset di dati fisici corretti.
Per saperne di più, consulta Gestire i glossari aziendali.
Origini Google Cloud supportate
Knowledge Catalog acquisisce automaticamente i metadati dalle seguenti Google Cloud origini. Per alcuni servizi, come AlloyDB per PostgreSQL e Cloud SQL, devi prima attivare l'integrazione di Knowledge Catalog prima che i metadati possano essere importati:
Analytics e lakehouse
- Set di dati, tabelle, viste, modelli, routine, connessioni, set di dati collegati e grafici di BigQuery (anteprima)
- Scambi e schede BigQuery sharing (in precedenza Analytics Hub)
- Repository Dataform e asset di codice
- Servizi, database e tabelle Dataproc Metastore
Tabelle del catalogo REST Iceberg (incluso Google Cloud il catalogo runtime Lakehouse, IRC, Databricks Unity IRC, AWS Glue Data Catalog IRC e Snowflake Horizon IRC)
Tabelle Apache Hive
Tabelle Delta Lake di SAP Business Data Cloud (BDC)
Tabelle Apache Iceberg gestite dal catalogo runtime Lakehouse
AI e machine learning
- Modelli, set di dati, gruppi di funzionalità, visualizzazioni delle funzionalità e istanze dello store online di Vertex AI
Business intelligence
- Istanze, dashboard, elementi delle dashboard, Look, progetti LookML, modelli, Explore e visualizzazioni di Looker (Google Cloud core) (anteprima)
Database
- Istanze, cluster e tabelle Bigtable (inclusi i dettagli delle famiglie di colonne)
- Istanze, database, tabelle e viste Spanner
Streaming e messaggistica
- Argomenti Pub/Sub
Dati non strutturati
Database operativi
- Cluster, istanze, database, schemi, tabelle e viste AlloyDB per PostgreSQL (anteprima). Knowledge Catalog recupera i metadati solo dalle istanze principali AlloyDB e non dalle repliche di lettura. Per maggiori informazioni, consulta Gestire le risorse AlloyDB per PostgreSQL utilizzando Knowledge Catalog.
- Istanze, database, schemi, tabelle e viste Cloud SQL. Knowledge Catalog recupera i metadati solo dalle istanze principali di Cloud SQL e non dalle repliche di lettura. Per saperne di più, consulta Gestire le risorse Cloud SQL utilizzando Knowledge Catalog.
Per importare metadati da un'origine di terze parti in Knowledge Catalog, puoi utilizzare i connettori Knowledge Catalog o una pipeline di connettività gestita. Per saperne di più, consulta Informazioni sui connettori di Knowledge Catalog e Panoramica della connettività gestita.
Vincoli di progetto e località
Le risorse del catalogo in Knowledge Catalog sono ospitate in progetti e località geografiche Google Cloud specifici. Si applicano i seguenti vincoli di ambito:
| Risorsa | Regola per le località | Regola di progetto |
|---|---|---|
| Voci | La località della voce deve corrispondere a quella del relativo EntryType oppure EntryType deve essere global. |
Può fare riferimento a tipi di voci globali o dello stesso progetto. |
| Aspetti delle voci | L'AspectType dell'aspetto deve essere memorizzato nella stessa posizione
dell'elemento o l'AspectType deve essere global. |
Può fare riferimento a tipi di aspetti globali o dello stesso progetto. |
| Entry links | La località del link di accesso deve corrispondere al relativo EntryLinkType oppure
il EntryLinkType deve essere global. |
Possono collegare voci che si trovano in progetti diversi all'interno della stessa organizzazione. |
| Tipi di voci | Composto da tipi di aspetto archiviati nella stessa posizione del tipo di voce
o da tipi di aspetto global. |
Se un tipo di voce fa riferimento a tipi di aspetto personalizzato, questi devono trovarsi nello stesso progetto e nella stessa posizione. |
Feed di modifica dei metadati
Knowledge Catalog può trasmettere flussi di eventi di modifica dei metadati in quasi in tempo reale utilizzando i feed di modifica dei metadati.
Un feed di modifiche ai metadati pubblica notifiche relative alla creazione, agli aggiornamenti o all'eliminazione di voci in un argomento Pub/Sub che configuri. I client abbonati possono utilizzare questi eventi per automatizzare i workflow operativi, ad esempio attivare valutazioni della qualità dei dati quando uno schema cambia o aggiornare le dashboard di governance downstream.
Per saperne di più, consulta Informazioni sui feed di modifica dei metadati.
Prezzi
Knowledge Catalog utilizza lo SKU di archiviazione dei metadati per addebitare il volume dei metadati archiviati. Per saperne di più, consulta la sezione Prezzi del Knowledge Catalog.
Non sono previsti addebiti per quanto segue:
- Creazione e gestione delle risorse del metamodello del catalogo (tipi di voci, tipi di aspetto, gruppi di voci, voci e collegamenti di voci).
- Chiamate API di ricerca e query di ricerca eseguite nella console Google Cloud .
Passaggi successivi
Aggiungere metadati a una tabella
Scopri gli asset e collega i metadati personalizzati degli aspetti a una tabella BigQuery.
Importa origini dati personalizzate
Definisci i tipi di voci e importa metadati personalizzati da database e pipeline esterni.
Gestisci i glossari aziendali
Crea una tassonomia aziendale e mappa i termini direttamente su tabelle e colonne fisiche.
Cercare e scoprire asset
Scopri le risorse in Google Cloud e le origini personalizzate utilizzando i predicati di ricerca.
Recuperare il contesto per gli agenti AI
Recupera i metadati pronti per l'LLM e il contesto attivo per basare gli agenti di AI generativa.
Transizione da Data Catalog
Esegui la migrazione di modelli di tag, voci personalizzate e workflow a Knowledge Catalog.