


Knowledge Catalog (anciennement Dataplex Universal Catalog) fournit une plate-forme unifiée et structurée de gestion des métadonnées pour l'ensemble de votre patrimoine de données distribuées. Il découvre, indexe et organise automatiquement les structures techniques, le contexte métier, les métriques de qualité des données et les relations opérationnelles.
En organisant les métadonnées dans un métamodèle flexible et extensible, Knowledge Catalog établit la base structurelle du graphe de contexte actif dans le cloud de données agentique de Google. Ce graphique contextuel permet aux équipes de données de découvrir et de gérer les composants tout en permettant aux agents d'IA générative de récupérer un contexte métier ancré et fiable.
Métamodèle Knowledge Catalog
Knowledge Catalog organise les métadonnées à l'aide d'une hiérarchie modulaire de conteneurs, d'éléments, de schémas et de relations :
- Conteneurs et composants : les groupes d'entrées organisent les entrées, qui représentent des composants de données individuels et leurs colonnes de schéma.
- Enrichissement structuré : les types d'aspects définissent des schémas pour les aspects, qui associent des métadonnées structurées à des entrées, des colonnes ou des relations.
- Normes et gouvernance : les types d'entrées définissent des modèles qui appliquent les aspects requis aux entrées.
- Relations : les types de liens d'entrée définissent les relations (liens d'entrée) qui relient les entrées et les termes commerciaux associés.
Le tableau suivant récapitule la distinction entre les ressources gérées par le système (fournies automatiquement par Google Cloud) et les ressources personnalisées définies par l'utilisateur :
| Élément de métamodèle | Gérée par le système (intégrée) | Définie par l'utilisateur (personnalisée) |
|---|---|---|
| Groupes d'entrées | Prédéfini par projet pour les services Google Cloud (par exemple,@bigquery, @spanner, @pubsub). |
Créés par les utilisateurs pour regrouper et gérer les composants de données personnalisés et les autorisations. |
| Entrées | Renseignés automatiquement à partir de sources Google Cloud (telles que les tables, vues, ensembles de données et modèles BigQuery). | Créées par les utilisateurs pour représenter des sources de données, des fichiers ou des bases de données tierces personnalisés. |
| Types d'aspects | Modèles système prédéfinis (par exemple, Schema, Overview, Contacts, DataQuality, Lineage). |
Créés par les utilisateurs pour définir des schémas de métadonnées spécifiques à un domaine (comme la classification des informations permettant d'identifier personnellement l'utilisateur ou les niveaux de SLA). |
| Aspects | Rempli automatiquement à partir des systèmes sources, des journaux de requêtes ou des analyses automatisées. | Créées par des utilisateurs, des pipelines ou des agents, et associées à des entrées, des colonnes ou des liens d'entrée. |
| Types d'entrées | Modèles prédéfinis représentant les types de ressources Google Cloud . | Définis par les utilisateurs pour spécifier les aspects obligatoires et facultatifs des composants de données personnalisés. |
| Liens d'entrée | Types de relations intégrés (tels que synonym, definition, schema-join, related). |
Instances créées entre des entrées ou des colonnes spécifiques pour modéliser les connexions multisystèmes. |
Les sections suivantes décrivent les principaux composants du métamodèle du catalogue de connaissances.
Groupes d'entrées
Un groupe d'entrées (EntryGroup) est un conteneur régional pour les entrées et les liens d'entrée. Il sert de limite administrative et de sécurité pour la gestion de ces ressources.
Utilisez des groupes d'entrées pour configurer les éléments suivants :
- Contrôle des accès Identity and Access Management : accordez des autorisations d'affichage ou de modification à des équipes spécifiques sur un groupe d'entrées sans modifier les autorisations individuelles des entrées.
- Attribution de l'emplacement et du projet : regroupez les composants par région géographique et par propriétaire du projet.
Pour les sources Google Cloud , Knowledge Catalog crée automatiquement des groupes d'entrées système par projet (tels que @bigquery ou @spanner). Pour les sources de données personnalisées, vous créez des groupes d'entrées personnalisés.
Par exemple, une équipe financière peut créer un groupe d'entrées personnalisées nommé production_finance_data pour gérer les autorisations d'accès à toutes les entrées personnalisées liées aux finances à un seul endroit.
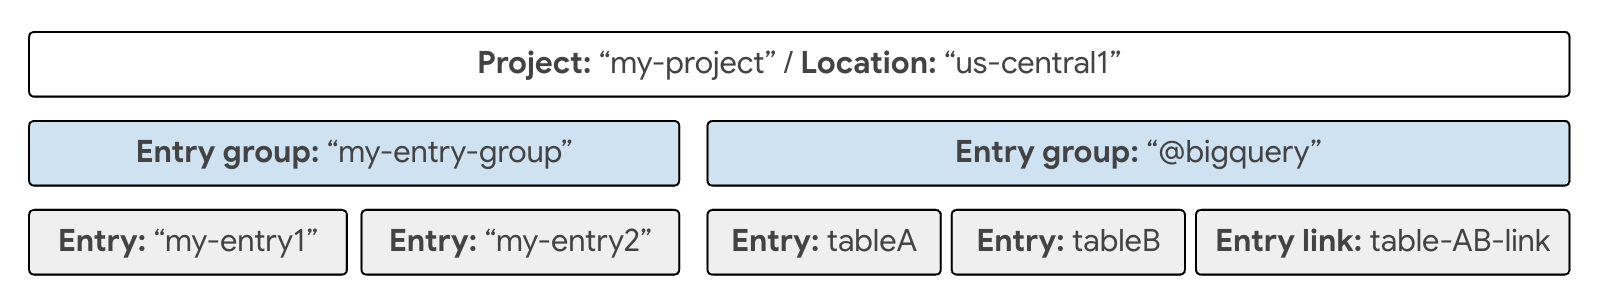
Pour en savoir plus, consultez Groupes d'entrées.
Entrées et chemins de schéma
Une entrée (Entry) représente un seul élément de données. Une entrée peut représenter une table de base de données structurée, un modèle analytique, une table d'objets non structurée ou un ensemble de données externes personnalisé.
Voici les principaux composants d'une entrée :
- Identifiant de l'entrée : nom de ressource unique dans son groupe d'entrées parent.
- Type d'entrée : modèle qui définit la structure de l'entrée et les aspects requis.
- Aspects : attributs de métadonnées structurées associés à l'entrée.
- Chemins de schéma (colonnes) : sous-sections ou champs spécifiques de l'élément de données, comme une colonne dans une table BigQuery ou un champ dans un schéma JSON.
Les colonnes vous permettent d'associer des métadonnées à des champs individuels d'un composant. Vous ne définissez pas manuellement les colonnes. Elles sont renseignées lorsque vous associez un aspect de type schema à une entrée. Vous pouvez référencer des champs imbriqués à l'aide de chemins de notation par points (par exemple, customer.address.postal_code).
Par exemple, une table BigQuery nommée orders_project.sales.customer_orders est représentée sous forme d'entrée. Pour décrire le champ email_address de cette table comme contenant des informations sensibles, vous associez un aspect de classification directement au chemin d'accès de la colonne email_address.
Pour en savoir plus, consultez Entrées.
Types d'aspects
Un type d'aspect (AspectType) est un modèle de schéma réutilisable qui définit les champs, les types de données et les règles de validation d'un aspect. Chaque aspect est une instance d'un type d'aspect.
Les types d'aspects peuvent être définis par le système (fournis par Google Cloud) ou personnalisés (créés par votre organisation).
Lorsque vous définissez le metadata_template pour un type d'aspect personnalisé, vous pouvez utiliser les types de données compatibles suivants :
| Type de données du champ | Description | Exemple d'utilisation |
|---|---|---|
string |
Valeur textuelle (UTF-8). | Adresse e-mail du propriétaire, libellé de classification des données, nom du service. |
integer/number |
Valeurs numériques (nombres entiers ou à virgule flottante). | Nombre de jours de conservation des données, pourcentage cible du SLA, niveau de priorité. |
boolean |
Indicateur vrai ou faux. | contains_pii: true, is_certified: false. |
enum |
Liste prédéfinie de valeurs de chaîne autorisées. | Environnement : ["DEV", "STAGING", "PROD"]. |
datetime/timestamp |
Date et heure au format ISO 8601. | Date de la dernière certification, date limite de l'examen de conformité. |
record |
Objet structuré imbriqué contenant des champs enfants. | ContactInfo { name: string, email: string, phone: string }. |
array |
Liste de valeurs répétées de n'importe quel type primitif ou enregistrement. | Liste des propriétaires de données secondaires : ["user1@example.com", "user2@example.com"]. |
map |
Paires clé/valeur de chaînes pour les attributs extensibles. | Balises de déploiement personnalisées : {"cost_center": "1042", "tier": "gold"}. |
Par exemple, pour définir un modèle réutilisable pour les informations de contact, vous pouvez créer un type d'aspect nommé ContactInfo avec des champs pour owner_name (string), email (string) et support_channel (string).
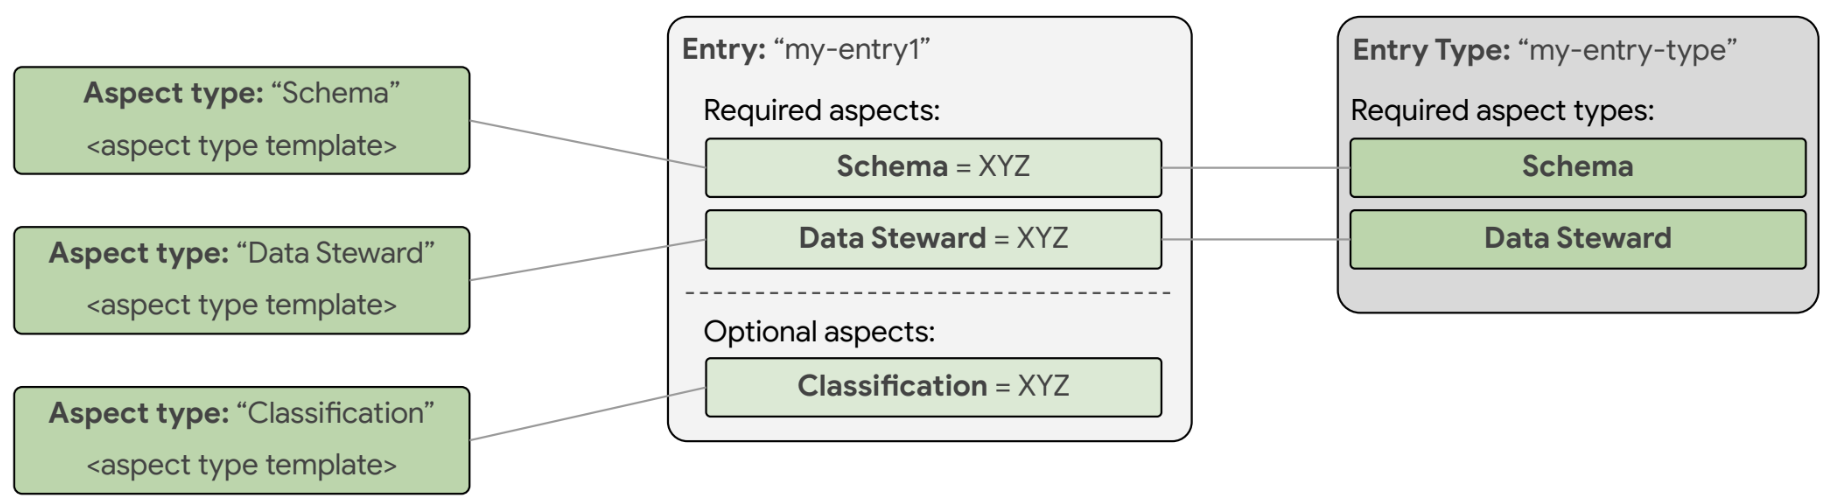
Pour en savoir plus, consultez Types d'aspects.
Aspects
Un aspect (Aspect) est un ensemble de champs de métadonnées associés qui sont conformes à un type d'aspect. Les aspects sont associés à une entrée, à un chemin d'entrée (colonne) ou à un lien d'entrée pour décrire cette ressource.
Contrairement aux anciens systèmes de taggage, les aspects du catalogue de connaissances sont encapsulés directement dans leurs entrées parentes ou leurs liens d'entrée, ce qui vous permet d'effectuer des opérations de lecture et d'écriture atomiques.
Les aspects sont utilisés dans plusieurs fonctions :
- Structure technique : l'aspect
Schemadécrit les colonnes, les types de données et les descriptions des tables. - Contexte de l'entreprise : les aspects personnalisés décrivent la propriété, la conformité et l'état du cycle de vie.
- Confiance opérationnelle : les aspects liés à la qualité des données enregistrent les résultats des analyses de règles automatisées et les scores de validation.
- Graphiques d'entités non structurés : l'aspect
GraphProfilecapture les entités et les relations extraites par l'IA à partir de fichiers bruts.
Par exemple, vous pouvez créer une instance du type d'aspect ContactInfo avec les valeurs {"owner_name": "Alex", "email": "alex@example.com"} et l'associer à l'entrée customer_orders.
Pour en savoir plus, consultez Aspects.
Types d'entrées
Un type d'entrée (EntryType) est un modèle de gouvernance permettant de créer des entrées personnalisées. Il applique les normes de qualité des métadonnées en établissant les types d'aspects requis qui doivent être associés à une entrée de ce type.
Lorsque vous créez une entrée d'un type spécifique, Knowledge Catalog vérifie que tous les types d'aspects marqués comme required dans le type d'entrée sont présents et valides.
Par exemple, vous pouvez créer un type d'entrée nommé CertifiedDataProduct qui spécifie les types d'aspect OwnerInfo et DataRetentionPolicy comme obligatoires. Toute nouvelle entrée créée avec ce type d'entrée doit inclure ces aspects avant de pouvoir être enregistrée.
Pour en savoir plus, consultez Types d'entrées.
Liens d'entrée et types de liens d'entrée
Un lien d'entrée (EntryLink) établit une relation sémantique entre deux entrées de données ou entre des colonnes spécifiques dans les entrées. Chaque lien d'entrée est une instance d'un type de lien d'entrée (EntryLinkType).
Les liens d'entrée peuvent être directionnels ou non directionnels :
- Symétrique (non directionnel) : relations dans lesquelles les deux côtés sont des pairs (par exemple,
synonym,relatedouschema-join). - Asymétriques (directionnelles) : relations avec une source et une cible explicites (par exemple,
definition, qui associe un terme du glossaire d'entreprise à une colonne de tableau).
Vous pouvez également associer des aspects directement aux liens d'entrée (à l'exception des liens schema-join). Cela vous permet de décrire la relation elle-même, par exemple en enregistrant les scores de confiance de la jointure, les règles de transformation ou les notes de mappage.
Knowledge Catalog est compatible avec les types de liens d'entrée intégrés suivants :
synonym: relie des concepts commerciaux équivalents ou des termes alternatifs.related: connecte les composants faiblement couplés entre les systèmes.definition: associe les définitions du glossaire d'entreprise à des colonnes ou des entrées physiques.schema-join: connecte les tables qui peuvent être jointes le long des chemins d'accès correspondants aux clés étrangères ou aux schémas.
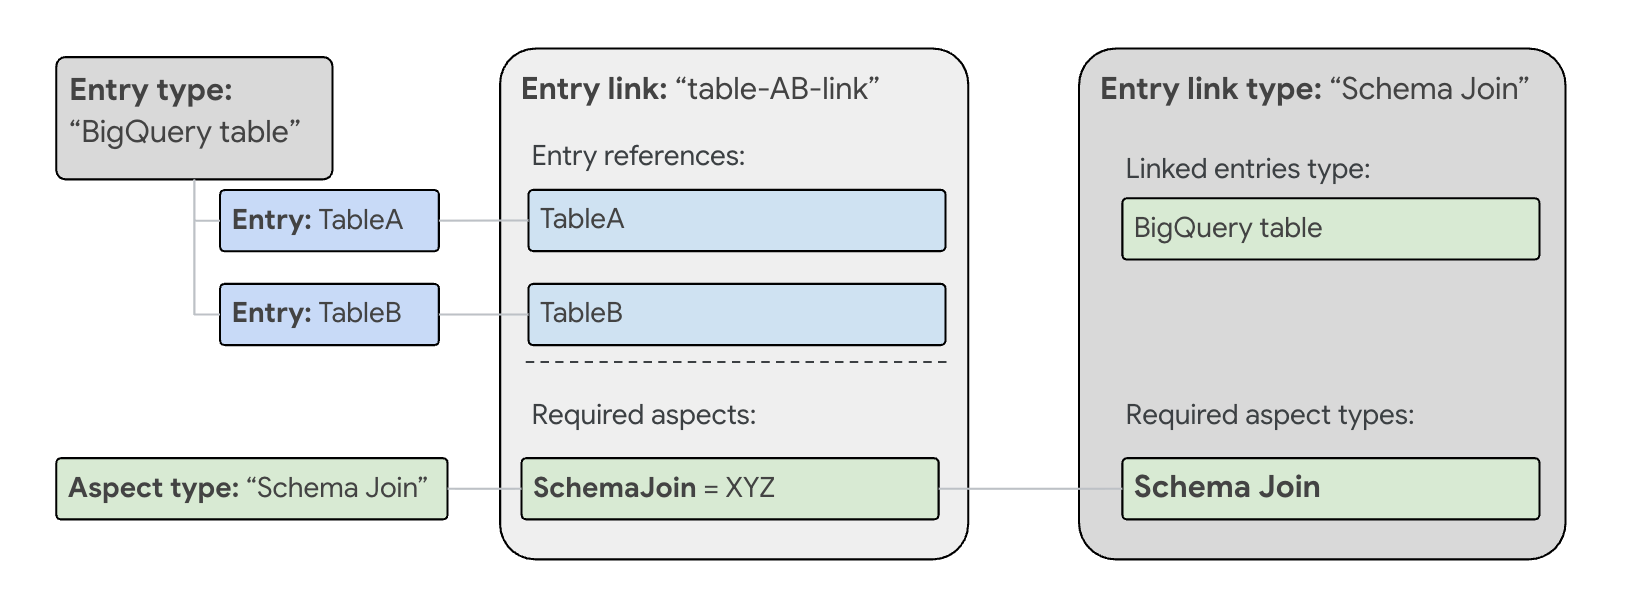
Pour en savoir plus, consultez la documentation de référence REST sur EntryLinks.
Glossaires et termes d'entreprise
Un glossaire d'entreprise vous permet d'établir une taxonomie métier formelle en définissant des glossaires, des catégories et des termes métier.
En utilisant des liens d'entrée de type definition ou synonym, vous pouvez mapper des termes commerciaux directement sur des entrées physiques et des chemins de colonne. Lorsque des utilisateurs ou des agents d'IA recherchent le catalogue en langage naturel, le moteur de recherche résout ces termes commerciaux pour localiser les bons assets de données physiques.
Pour en savoir plus, consultez Gérer les glossaires d'entreprise.
Sources Google Cloud acceptées
Knowledge Catalog ingère automatiquement les métadonnées des sourcesGoogle Cloud suivantes. Pour certains services, tels qu'AlloyDB pour PostgreSQL et Cloud SQL, vous devez d'abord activer l'intégration de Knowledge Catalog avant de pouvoir ingérer des métadonnées :
Analytics et lakehouse
- Ensembles de données, tables, vues, modèles, routines, connexions, ensembles de données associés et graphiques BigQuery (aperçu)
- Échanges et fiches BigQuery Sharing (anciennement Analytics Hub)
- Dépôts Dataform et éléments de code
- Services, bases de données et tables Dataproc Metastore
Tables du catalogue REST Iceberg (y compris Google Cloud le catalogue d'environnements d'exécution Lakehouse , IRC Databricks Unity, IRC AWS Glue Data Catalog et IRC Snowflake Horizon)
Tables Apache Hive
Tables Delta Lake SAP Business Data Cloud (BDC)
Tables Apache Iceberg gérées par le catalogue d'exécution Lakehouse
IA et machine learning
- Modèles, ensembles de données, groupes de caractéristiques, vues de caractéristiques et instances de boutique en ligne Vertex AI
Informatique décisionnelle
- Instances, tableaux de bord, éléments de tableau de bord, Looks, projets LookML, modèles, Explorations et vues Looker (Google Cloud Core) (Aperçu)
Bases de données
- Instances, clusters et tables Bigtable (y compris les détails des familles de colonnes)
- Instances, bases de données, tables et vues Spanner
Streaming et messagerie
- Sujets Pub/Sub
Données non structurées
Bases de données opérationnelles
- Clusters, instances, bases de données, schémas, tables et vues AlloyDB pour PostgreSQL (aperçu). Knowledge Catalog récupère les métadonnées uniquement à partir des instances AlloyDB principales, et non des instances répliquées avec accès en lecture. Pour en savoir plus, consultez Gérer vos ressources AlloyDB pour PostgreSQL à l'aide du catalogue de connaissances.
- Instances, bases de données, schémas, tables et vues Cloud SQL. Knowledge Catalog ne récupère les métadonnées qu'à partir des instances Cloud SQL principales, et non des instances répliquées avec accès en lecture. Pour en savoir plus, consultez Gérer vos ressources Cloud SQL à l'aide de Knowledge Catalog.
Pour importer des métadonnées depuis une source tierce dans Knowledge Catalog, vous pouvez utiliser des connecteurs Knowledge Catalog ou un pipeline de connectivité gérée. Pour en savoir plus, consultez À propos des connecteurs du Knowledge Catalog et Présentation de la connectivité gérée.
Contraintes liées au projet et à l'emplacement
Les ressources de catalogue dans Knowledge Catalog sont hébergées dans des projets Google Cloud et des zones géographiques spécifiques. Les contraintes de portée suivantes s'appliquent :
| Ressource | Règle d'emplacement | Règle de projet |
|---|---|---|
| Entrées | L'emplacement de l'entrée doit correspondre à celui de son EntryType, ou le EntryType doit être global. |
Peut faire référence à des types d'entrée globaux ou du même projet. |
| Aspects sur les entrées | Le AspectType de l'aspect doit être stocké au même emplacement que l'entrée, ou le AspectType doit être global. |
Peut faire référence à des types d'aspects globaux ou du même projet. |
| Liens d'entrée | L'emplacement du lien d'entrée doit correspondre à son EntryLinkType, ou le EntryLinkType doit être global. |
Peut associer des entrées résidant dans différents projets d'une même organisation. |
| Types d'entrées | Composé de types d'aspect stockés au même emplacement que le type d'entrée, ou de types d'aspect global. |
Si un type d'entrée fait référence à des types d'aspect personnalisés, ces types d'aspect doivent se trouver dans le même projet et au même emplacement. |
Flux de modifications des métadonnées
Knowledge Catalog peut diffuser des événements de modification de métadonnées en temps quasi réel à l'aide de flux de modification de métadonnées.
Un flux de modifications de métadonnées publie des notifications concernant la création, la mise à jour ou la suppression d'entrées dans un sujet Pub/Sub que vous configurez. Les clients abonnés peuvent consommer ces événements pour automatiser les workflows opérationnels, par exemple en déclenchant des évaluations de la qualité des données lorsqu'un schéma change ou en mettant à jour les tableaux de bord de gouvernance en aval.
Pour en savoir plus, consultez À propos des flux de modifications des métadonnées.
Tarifs
Knowledge Catalog utilise le SKU de stockage de métadonnées pour facturer le volume de métadonnées stockées. Pour en savoir plus, consultez les tarifs de Knowledge Catalog.
Les éléments suivants ne sont pas facturés :
- Créer et gérer des ressources de métamodèle de catalogue (types d'entrées, types d'aspects, groupes d'entrées, entrées et liens d'entrée)
- Appels d'API de recherche et requêtes de recherche effectuées dans la console Google Cloud .
Étapes suivantes
Ajouter des métadonnées à une table
Découvrez des composants et associez des métadonnées d'aspect personnalisées à une table BigQuery.
Ingérer des sources de données personnalisées
Définissez des types d'entrées et ingérez des métadonnées personnalisées à partir de bases de données et de pipelines externes.
Gérer les glossaires d'entreprise
Créez une taxonomie d'entreprise et mappez les termes directement aux tables et colonnes physiques.
Rechercher et découvrir des composants
Découvrez des ressources dans Google Cloud et des sources personnalisées à l'aide de prédicats de recherche.
Récupérer le contexte pour les agents IA
Récupérez des métadonnées et un contexte actif prêts pour les LLM afin d'ancrer les agents d'IA générative.
Passer de Data Catalog
Migrez les modèles de tags, les entrées personnalisées et les workflows vers Knowledge Catalog.