


O Knowledge Catalog é uma camada de contexto com tecnologia do Gemini que oferece contexto comercial universal e recursos de embasamento ativos em todo o seu patrimônio de dados. Ao criar um gráfico de contexto dinâmico com dados estruturados e não estruturados, ele ajuda as equipes de dados e os desenvolvedores a descobrir recursos, verificar a qualidade de dados e fundamentar com segurança os aplicativos de IA generativa para reduzir alucinações.
Para um tutorial detalhado do Knowledge Catalog, assista ao seguinte vídeo:
Público e pré-requisitos
Esta visão geral é destinada a engenheiros de dados e contexto, cientistas de dados, administradores de dados e desenvolvedores de IA. Antes de usar o Knowledge Catalog, você precisa ter:
Familiaridade com sistemas de banco de dados e armazenamento, como BigQuery ou Cloud Storage.
Noções básicas sobre conceitos de IA generativa, como geração aumentada por recuperação (RAG) ou Protocolo de Contexto de Modelo (MCP).
Resolver a complexidade de dados específicos do setor
Nas empresas modernas, os dados são complexos, altamente distribuídos e existem em formatos estruturados e não estruturados. As solicitações comerciais raramente são mapeadas para um único esquema de banco de dados ou repositório de documentos. Alinhar esses silos com segurança e fornecer respostas imediatas e confiáveis a perguntas de vários domínios é um grande desafio operacional.
O Knowledge Catalog atua como a base semântica que preenche essa lacuna, permitindo que agentes de IA e ferramentas de análise recuperem contexto fundamentado e relevante.
Funções principais do usuário
Engenheiros de contexto (engenheiros de dados). Automatize a agregação de metadados em bancos de dados e no Cloud Storage, rastreie transformações com linhagem e crie fluxos de trabalho de enriquecimento e avaliação.
Administradores de dados (equipes de governança). Supervisione a qualidade dos metadados fornecendo revisões humanas das descrições geradas por IA, padronizando vocabulários de negócios com glossários e definindo aspectos personalizados para anexar contexto específico do domínio às entradas do catálogo.
Desenvolvedores de IA. Fundamentar LLMs e aplicativos de IA com esquemas de dados corporativos confiáveis usando servidores MCP ou APIs de recuperação de contexto.
Casos de uso do setor
A tabela a seguir ilustra as questões complexas que surgem na prática, como elas cruzam fronteiras técnicas e como o Catálogo de dados ajuda as organizações a lidar com elas:
| Setor | Desafios operacionais e de dados | Problema de negócios a ser resolvido | Como o Knowledge Catalog resolve isso |
|---|---|---|---|
| E-commerce |
|
"Encontre produtos eletrônicos com altas taxas de devolução e fotos de clientes mostrando sinais de danos na chegada." | Fundamentação semântica em formatos de dados:descobre automaticamente metadados de bancos de dados transacionais e os vincula a imagens não estruturadas em buckets de armazenamento do Cloud Storage, permitindo que as ferramentas de IA resolvam a consulta em diferentes sistemas de armazenamento. |
| Manufatura |
|
"Gere resumos de todos os relatórios de inspeção relacionados a máquinas na região Oeste que não passaram nas verificações de segurança no último trimestre." | Rastreamento regional e não estruturado:rastreia e cataloga relatórios de inspeção em PDF não estruturados junto com metadados de recursos, permitindo que agentes de IA generativa localizem, compilem e resumam relatórios por região. |
| Saúde |
|
"Quais pacientes têm o maior risco de serem readmitidos em 30 dias considerando os sinais vitais recentes e a frequência de consultas?" | Qualidade de dados e linhagem: calcula o perfil de qualidade de dados no nível da linha e mapeia a linhagem em feeds de histórico de saúde eletrônicos. Isso ajuda a garantir que os modelos preditivos clínicos dependam apenas de sinais vitais verificados e de alta qualidade dos pacientes. |
| Serviços financeiros |
|
"Quais dos 10 principais clientes em receita reclamaram de 'problemas de performance' e como isso afeta as projeções do terceiro trimestre?" | Gráfico de contexto unificado:unifica registros de clientes, feedback de suporte e tabelas financeiras, permitindo que consultas em linguagem natural combinem estatísticas de receita do cliente com arquivos de feedback não estruturados para prever o impacto financeiro. |
Para resolver esses desafios operacionais, o Knowledge Catalog oferece recursos importantes que ajudam engenheiros e cientistas de dados e desenvolvedores de IA a criar sistemas de dados governados:
Fundamentar agentes de IA com o Protocolo de Contexto de Modelo (MCP). Exponha metadados, esquemas, linhagem e regras de negócios diretamente aos agentes de IA usando servidores MCP locais ou remotos. Esses servidores permitem que os modelos verifiquem as expectativas operacionais antes de propor ações.
Acelere a descoberta para IA e análises. Encontre recursos de dados relevantes usando a pesquisa semântica com linguagem natural. Os resumos e as recomendações generativas ajudam os usuários a localizar dados sem esperar por revisões manuais de documentação.
Extrair contexto de dados não estruturados. Analisar automaticamente arquivos não estruturados, como PDFs no Cloud Storage, para extrair entidades e relacionamentos, convertendo-os em recursos consultáveis no BigQuery para oferecer suporte a agentes de conversa.
Governar produtos de dados em grande escala. Agrupe coleções de recursos com contratos de nível de serviço (SLAs), contratos, detalhes de propriedade e observações de uso em unidades únicas e controladas para pesquisa e assinatura.
Como o Knowledge Catalog funciona
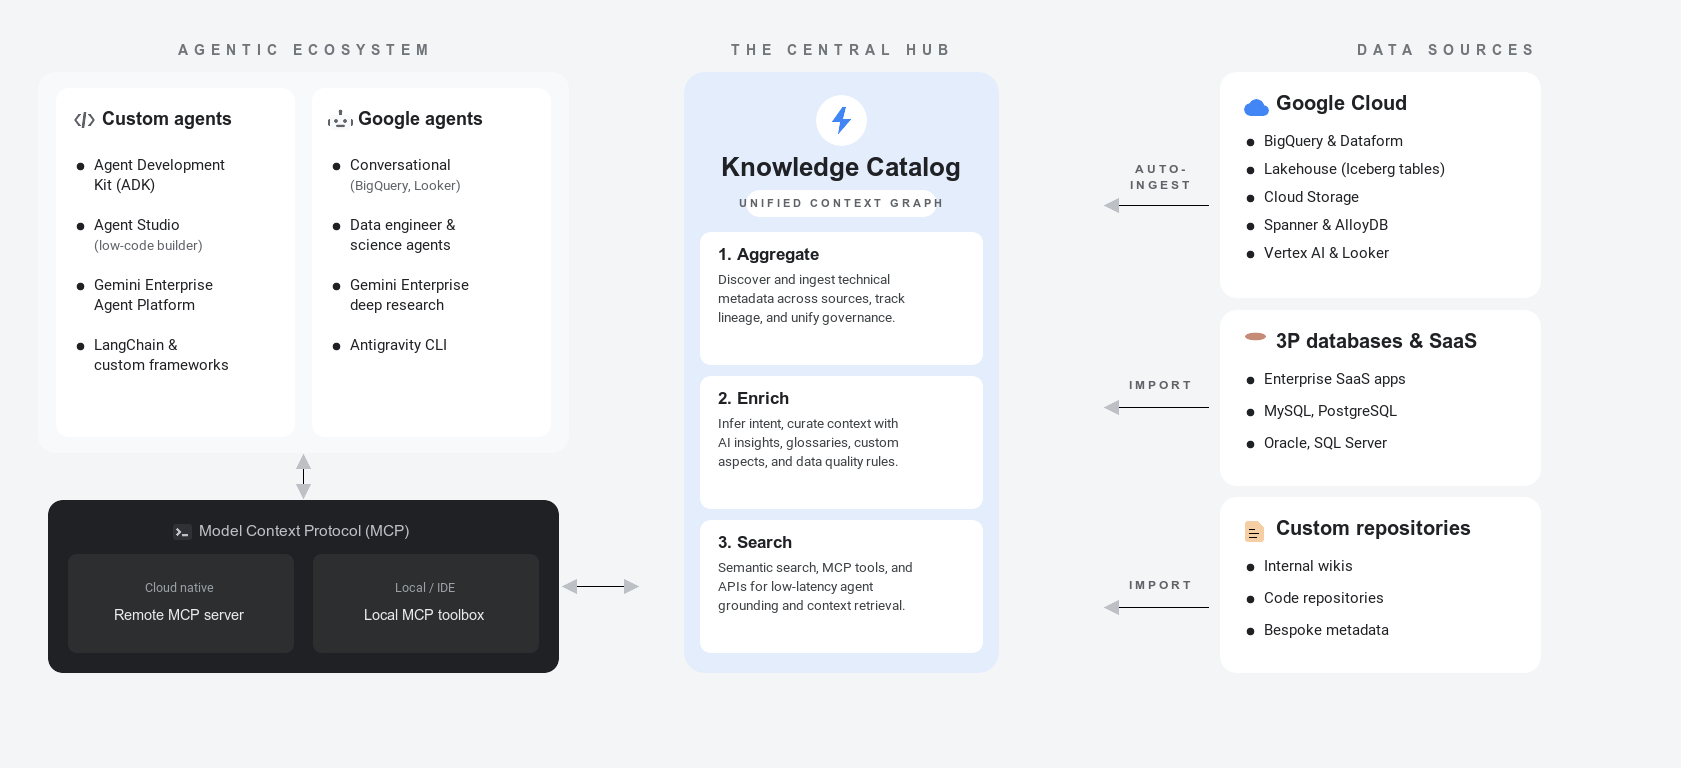
O Knowledge Catalog unifica o gerenciamento de dados e o contexto em um ciclo de vida de três pilares. O diagrama a seguir ilustra como o serviço mapeia recursos de dados físicos para semântica de negócios para embasamento de agentes de IA:
Para mais informações sobre esses conceitos de metadados, consulte Sobre metadados.
As seções a seguir descrevem os três pilares do ciclo de vida dos metadados e ilustram como uma empresa de varejo os aplica a tabelas de banco de dados, arquivos e entradas de catálogo externo:
Agregação (descoberta e ingestão). O Knowledge Catalog rastreia e indexa automaticamente metadados técnicos em todo o patrimônio de dados sem mover os dados subjacentes:
- Bancos de dados integrados. A catalogação automatizada captura esquemas e atributos em plataformas como BigQuery, AlloyDB para PostgreSQL e Spanner.
- Conectividade gerenciada. Ingira definições de sistemas externos, como Oracle ou PostgreSQL, ou registros de parceiros, como Collibra, sem escrever pipelines personalizados.
- Linhagem de dados: Rastreie transformações no nível da coluna em todos os pipelines para saber de onde seus dados vêm e como eles mudaram.
- Exemplo:uma empresa de varejo ingere automaticamente metadados de banco de dados transacionais, como as tabelas
orderseorder_items, e indexa arquivos de produtos não estruturados armazenados em buckets do Cloud Storage. Eles vinculam bancos de dados externos para estabelecer um índice de metadados unificado em um diretório detectável.
Para saber mais sobre agregação de metadados e ingestão de dados, clique para expandir
- Fontes de dados compatíveis: lista todas as fontes Google Cloud e externas compatíveis para ingestão automatizada.
- Visão geral da conectividade gerenciada: explica como ingerir esquemas técnicos de sistemas externos.
- Rastrear a linhagem de dados: descreve como visualizar transformações de pipeline no nível da coluna e fluxo de dados.
Enriquecimento (organizar o contexto e verificar a confiança). O Knowledge Catalog atribui significado comercial a estruturas técnicas e estabelece indicadores de confiança:
- Insights gerados com IA. O Gemini analisa os registros de consultas para gerar descrições de colunas, resumos de tabelas e junções recomendadas.
- Indexação não estruturada. Rastrear diretórios de arquivos para extrair entidades e conexões de recursos não estruturados, como PDFs ou imagens.
- Glossários e aspectos. Mapeie nomes de métricas internas para um vocabulário compartilhado usando termos comerciais e modelos lógicos.
- Qualidade de dados e detecção de anomalias. Aplique diretrizes de limpeza e execute verificações de aprendizado de máquina para detectar outliers estatísticos ou problemas de atualização de dados, gerando indicadores de confiança importantes.
- Análises de governança. Gerencie o risco usando processos de revisão de fluxo de trabalho para verificar atualizações de metadados antes da publicação.
- Exemplo:a equipe de varejo enriquece os recursos acionando insights de dados para recomendar descrições de colunas e executar regras de qualidade de dados. Eles mapeiam definições comerciais para pedidos ativos criando glossários e aspectos.
Para saber mais sobre o enriquecimento de metadados e a verificação de confiança, clique para abrir
- Configurar insights de dados: explica como gerar descrições e resumos automatizados de conjuntos de dados.
- Gerenciar glossários de negócios: descreve como personalizar termos padrão e vocabulários de negócios.
- Enriquecer metadados com aspectos: mostra como anexar propriedades de metadados estruturados a recursos lógicos.
- Reutilizar regras de qualidade de dados: mostra como estabelecer e reutilizar regras de validação de banco de dados.
- Visão geral da criação de perfil de dados: descreve como configurar verificações para anomalias de esquema e deriva estatística.
Pesquisa e recuperação (acesso e embasamento). Os aplicativos de IA e os usuários empresariais consultam o gráfico de contexto unificado para acessar dados com segurança:
- Agentes de embasamento. Conecte seus apps e agentes baseados em LLM ao catálogo.
- API Context. Faça solicitações de payload de embasamento de baixa latência.
- Pesquisa semântica. Encontre os recursos certos usando consultas de linguagem natural.
- Agrupamento de dados. Agrupe coleções de tabelas, detalhes de licenciamento e SLAs em pacotes de dados seguros de autoatendimento.
- Exemplo:os analistas fazem pesquisas semânticas em linguagem natural para localizar recursos. Os aplicativos de IA consomem esse índice com segurança usando servidores MCP ou a API de recuperação de contexto, e os recursos de alta qualidade são agrupados em uma visualização segura.
Para saber mais sobre a recuperação de contexto e o embasamento do agente (clique para abrir)
- Visão geral do Protocolo de Contexto de Modelo (MCP): explica como conectar agentes de IA generativa e camadas de aplicativos ao contexto do Knowledge Catalog.
- Recuperar contexto usando LookupContext: mostra como extrair payloads operacionais importantes para o comando do agente.
- Pesquisar recursos: descreve os recursos de pesquisa de recursos usando a sintaxe de consulta semântica de linguagem natural.
Knowledge Catalog no Google Cloud e no ecossistema de IA
É essencial entender como o Knowledge Catalog se integra aos serviços relacionados ao criar uma base de dados.
Google Cloud bancos de dados e modelos
- BigQuery: O Knowledge Catalog rastreia e indexa automaticamente conjuntos de dados, tabelas e visualizações do BigQuery. Ele aciona insights de dados com tecnologia do Gemini para analisar históricos de consultas, publicar descrições e sugerir exemplos de consultas verificadas.
- Looker (Google Cloud Core). O Knowledge Catalog ingere painéis, Looks e estruturas do LookML do Looker, como visualizações, análises, dimensões e métricas. Essa ingestão cria mapeamentos de linhagem para rastrear como os valores operacionais são mapeados para a semântica de negócios.
- Catálogo de ambientes de execução do Lighthouse. O Knowledge Catalog se integra ao Lighthouse, o metastore de tempo de execução para cargas de trabalho do Iceberg de código aberto. Ele indexa automaticamente metadados técnicos em cima das cargas de trabalho do Lighthouse para fornecer um contexto ativo unificado.
Plataformas e assistentes de agentes de IA
- Análise conversacional. As interfaces de análise usam termos do catálogo e ferramentas de pesquisa para permitir que os usuários consultem métricas de negócios em linguagem natural com embasamento verificado.
- Gemini para agentes de IA. Os agentes assistentes de alta precisão usam metadados do catálogo para executar pesquisas no banco de dados, reduzindo as alucinações.
- Gemini Enterprise Agent Platform. O Knowledge Catalog serve como o padrão central de governança de dados em ambientes de plataforma segmentada. Ele faz cross-linking com a Gemini Enterprise Agent Platform para fornecer ferramentas e contexto ao Agent Registry da plataforma.
Google Cloud Integração de serviços de banco de dados e IA
O Knowledge Catalog funciona com outros produtos doGoogle Cloud para formar sua base de dados. A tabela a seguir destaca como o Knowledge Catalog se integra e complementa serviços relacionados:
| Serviço | Função principal | Como ele se integra ao Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | Governança e contexto agêntico | Serve como o gráfico de contexto semântico unificado, executando verificações de qualidade de dados e expondo esquemas fundamentados a modelos e aplicativos de IA. |
| BigQuery | Armazenamento em data warehouse empresarial | Armazena, consulta e processa conjuntos de dados; rastreia, indexa e enriquece automaticamente essas tabelas com aspectos de classificação de negócios. |
| Vertex AI | Desenvolvimento de modelos de IA | Cria, implanta e hospeda modelos de base. Os agentes personalizados recuperam o contexto de metadados para fundamentar o raciocínio lógico. |
| Cloud Storage | Armazenamento de arquivos não estruturados | Armazena arquivos brutos e não estruturados e executa automaticamente verificações de descoberta não estruturada para analisar PDFs e imagens e criar mapas de relacionamento. |
Semântica e formatos de dados
Para instruir e fundamentar sistemas de agentes de maneira eficaz, é preciso distinguir entre estrutura de dados física e significado semântico:
- Semântica. O significado, a intenção e os relacionamentos comerciais associados aos seus dados. Embora os esquemas técnicos definam especificações de armazenamento estrutural, como um tipo de banco de dados, comprimento de caracteres ou restrição de números inteiros, a semântica descreve o que o conjunto de dados realmente representa. Por exemplo, é possível mapear uma coluna chamada
txn_qtypara a definição comercial de "quantidade comprada". - Dados estruturados. Informações armazenadas em esquemas definidos e formatos relacionais. Exemplos incluem tabelas do BigQuery, bancos de dados do Spanner e tabelas operacionais do Postgres. O Knowledge Catalog rastreia automaticamente esses metadados e registra colunas e restrições.
- Dados não estruturados. Informações não formatadas que contêm texto bruto ou arquivos de mídia sem um esquema estrutural. Por exemplo, planilhas de dados em PDF, e-mails de suporte ao cliente e imagens armazenadas no Cloud Storage. O Knowledge Catalog executa verificações de descoberta usando insights de dados não estruturados para extrair relações de entidades subjacentes e registrá-las em um perfil de grafo, que é um aspecto especializado que contém nós e arestas de relacionamento de entidades extraídos por IA.
Orquestração de contexto da Data Cloud agêntica
No framework da Agentic Data Cloud do Google, o Knowledge Catalog serve como o plano de orquestração semântica. Em vez de exigir que os desenvolvedores codifiquem manualmente esquemas e regras de banco de dados em comandos, o mecanismo de contexto oferece dinamicamente o contexto semântico preciso de que um agente precisa para tomar decisões inteligentes.
A figura a seguir mostra como o Knowledge Catalog orquestra e entrega o contexto de dados:
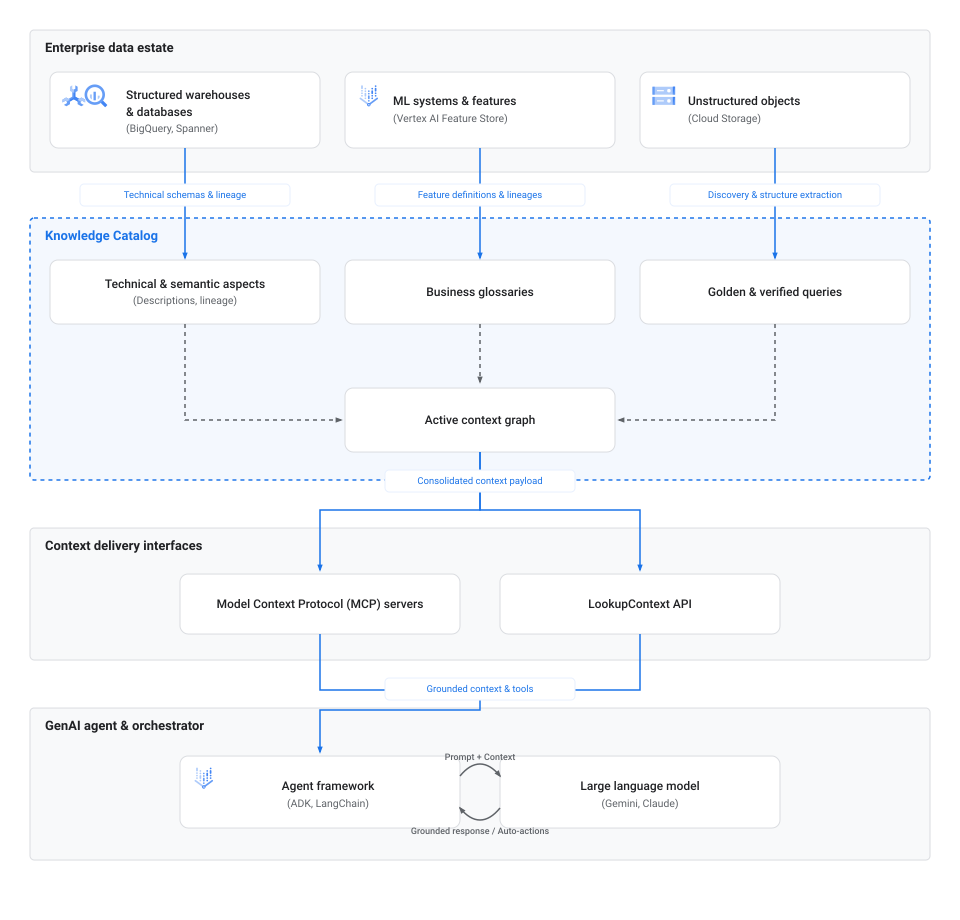
O fluxo de trabalho de orquestração de contexto consiste nas seguintes fases:
- Ingestão e descoberta. Bancos de dados operacionais, data warehouses como o Spanner e o BigQuery, repositórios de objetos não estruturados como o Cloud Storage e metastores de tempo de execução como o Lighthouse alimentam esquemas técnicos, mapas de linhagem e definições de metadados diretamente no Knowledge Catalog.
- Mapeamento de contexto. No Knowledge Catalog, essas propriedades de metadados são vinculadas a elementos semânticos, incluindo aspectos técnicos, glossários de negócios e consultas verificadas, para montar o gráfico de contexto ativo.
- Interfaces de exibição. Os aplicativos e orquestradores de IA recuperam esse gráfico de contexto consolidado de maneira programática usando conectores padrão, como o MCP ou endpoints diretos da API
LookupContext. - Embasamento do agente. Frameworks de orquestração, como o Kit de Desenvolvimento de Agente (ADK) ou o LangChain, injetam esse contexto de metadados diretamente em comandos do LLM. Essa injeção fundamenta o raciocínio do agente em regras organizacionais verificadas, permitindo que ele consulte bancos de dados ou execute ações automatizadas sem alucinações.
Perfis de agentes de IA
Dependendo dos fluxos de trabalho que você quer automatizar, é possível criar diferentes classes de agentes com tecnologia do Knowledge Catalog:
- Agentes de descoberta de dados. Esses assistentes ajudam os usuários a pesquisar e navegar pelo patrimônio de dados. Em vez de usar a correspondência de palavras-chave, eles analisam a intenção e as restrições de formato longo em linguagem natural para recuperar os recursos físicos mais relevantes.
- Agentes de enriquecimento de metadados. Esses agentes em segundo plano ingerem texto não estruturado de wikis, arquivos README ou registros de chat, analisam o texto em metadados formais e gravam os metadados como aspectos no Knowledge Catalog para manter os metadados atualizados.
- Qualidade de dados e agentes de pipeline. Esses agentes autônomos avaliam regras de qualidade, detectam desvios de esquema e criam ou corrigem pipelines de transformação de dados consultando a linhagem de dados e as estatísticas de perfil.
Ferramentas de orquestração
Para criar e integrar esses agentes, use as seguintes ferramentas:
- Protocolo de Contexto de Modelo (MCP). Um protocolo padronizado e aberto para vincular agentes a recursos externos. É possível configurar os agentes para se conectarem ao catálogo usando o servidor MCP remoto ou a caixa de ferramentas MCP local. Para mais informações, consulte Sobre o Protocolo de Contexto de Modelo (MCP) no Knowledge Catalog.
- Kit de Desenvolvimento de Agente (ADK). Um framework do Google que simplifica a criação, a execução e o teste de agentes de IA generativa, oferecendo vinculações integradas à API Catalog Service. Para mais informações, consulte a página inicial do ADK.
- API LookupContext. Um endpoint de API REST e gRPC que extrai um payload de contexto unificado em YAML ou JSON para recursos de dados, pronto para ser injetado diretamente em comandos de LLM. Para mais informações, consulte Recuperar contexto usando a API LookupContext.
Contexto de acesso com o MCP
O Protocolo de Contexto de Modelo (MCP) é uma ponte padronizada que permite que agentes e ferramentas de IA se conectem facilmente a fontes de dados, como o Knowledge Catalog. Use a tabela de comparação a seguir para determinar a melhor opção para sua integração:
| Implementação | Ideal para | Detalhes importantes | Endpoint ou configuração |
|---|---|---|---|
| Servidor MCP remoto | Implantações com priorização da nuvem, ambientes sem servidor como o Cloud Run e serviços externos gerenciados. | Endpoint hospedado pelo Google que não exige gerenciamento de servidor local. | Endpoint: https://dataplex.googleapis.com/mcpPara configurar, consulte Usar um servidor MCP remoto. |
| Caixa de ferramentas do MCP local | Desenvolvimento de agentes locais, prototipagem rápida e integrações de IDEs de computador, como VS Code ou Cursor. | Ferramenta de linha de comando que atua como um proxy local entre seu ambiente de trabalho e o Knowledge Catalog. | Requer instalação binária e configurações do .mcp.json.Para configurar, consulte Usar um servidor MCP local. |
Práticas recomendadas para contexto de dados com agentes
Para criar experiências de agente confiáveis, siga estas práticas recomendadas ao organizar e consultar metadados no Knowledge Catalog:
- Adicionar aspectos. Os agentes de IA não conseguem distinguir entre tabelas de produção oficiais e simulações temporárias de sandbox apenas pelo nome. Defina e aplique um aspecto de indicador de confiança personalizado para certificar produtos de dados confiáveis, o que ajuda a garantir que os agentes priorizem ou restrinjam consultas a esses recursos.
- Otimize as pesquisas usando orçamentos de contexto. Ao chamar a API
LookupContext, especifique o parâmetrocontext_budget. A API otimiza e ajusta primeiro os metadados mais importantes, como linhagem e descrições principais, dentro das restrições de token especificadas. - Forneça recursos relacionados para expor caminhos de junção. Nas suas consultas de contexto, liste até 10 tabelas ou recursos relacionados. Ao fornecer um grupo de recursos, o mecanismo de contexto preenche automaticamente caminhos e relações de junção, o que ajuda o agente a entender como as tabelas interagem.
- Estruturar glossários semânticos. Padronizar termos e abreviações em glossários empresariais. Essa padronização ajuda as ferramentas de conversa a resolver sinônimos e métricas específicos da empresa com precisão.
- Publicar consultas de ouro. Anexe consultas verificadas em linguagem natural e os equivalentes corretos em SQL diretamente às entradas do Knowledge Catalog. Ao fundamentar o raciocínio nesses modelos verificados, você evita erros de conversão de SQL em agentes de texto para SQL.
Fazer a transição do Dataplex Universal Catalog para o Knowledge Catalog
O Dataplex Universal Catalog evoluiu para o Knowledge Catalog. Para mais informações sobre essa transição, consulte Transição do Dataplex Universal Catalog para o Knowledge Catalog.
Limitações
Ao planejar a implantação, considere as seguintes limitações:
Integrações aceitas. Embora o Knowledge Catalog seja compatível com os principais sistemas de terceiros, algumas extrações semânticas automatizadas podem ser limitadas aos serviços integrados do Google Cloud .
Limites de cota. As cotas padrão da API Google Cloud se aplicam às operações de recuperação de contexto e extração de metadados.
A seguir
Sobre o contexto de dados
Entenda como o contexto ativo transforma metadados passivos para fundamentar agentes de IA e evitar alucinações.
Estabelecer um contexto de dados fundamental
Crie um glossário empresarial, defina tipos de aspectos personalizados e enriqueça os recursos no BigQuery.
Estruture os agentes com o MCP
Conecte agentes de IA e ferramentas de desenvolvedor ao Knowledge Catalog usando o Protocolo de Contexto de Modelo.
Pesquisar recursos
Encontre e explore recursos de catálogo no Google Cloud e em sistemas de terceiros usando linguagem natural.
Automatizar verificações de qualidade de dados
Defina regras de validação e monitore a limpeza dos dados em tabelas com verificações de qualidade automatizadas.
Conheça casos de uso interativos
Confira soluções reais para enriquecimento de contexto, linhagem de dados e fluxos de trabalho de agentes.