


分散ストリーミング パイプラインでは、集計指標だけを使用して、レイテンシの急増の原因となった特定のステージ、外部サービス呼び出し、ワーカー シャッフルを特定することは困難です。Dataflow で OpenTelemetry 分散トレースを使用すると、パイプライン変換、ネットワーク境界、統合サービス全体で個々の要素を 1 つのトレース ID でエンドツーエンドで追跡できます。この可視性により、パフォーマンスのボトルネックを特定し、パイプラインの実行コストを最適化し、複雑なストリーミング ワークロードのトラブルシューティングを行うことができます。
次の情報を使用して、Apache Beam パイプラインで OpenTelemetry 分散トレースを有効にして構成し、使用します。
ユースケース
Dataflow の分散トレースは、次のシナリオで特に役立ちます。
- ストリーミング ワークロード: 要素ごとの処理時間を追跡し、遅延やレイテンシの急増を引き起こすステージを特定します。
- ユーザーコードでの外部サービス呼び出しのトレース: パイプラインがユーザーコード(
DoFnなど)内の外部データベース、マイクロサービス、生成 AI API を呼び出すときの実行時間を測定します。たとえば、外部データベース(Spanner や Bigtable など)、マイクロサービス(HTTP または gRPC を使用)、生成 AI API(Gemini など)への呼び出し時間を測定できます。詳細については、DoFn でカスタム トレースを書き込むとクライアント ライブラリと統合するをご覧ください。 - 費用とパフォーマンスの最適化: 実際の負荷の下で
PTransformインスタンスの特定のオペレーションの所要時間を公開し、非効率的なシリアル化、遅いクエリ、ワーカー スレッドの競合を特定します。 - 複雑なエージェント パイプラインとワークフロー パイプライン: 複数のブランチ、反復エージェント ループ、結合を含むパイプラインの可視性を高めて、どの変換またはブランチに最も時間がかかるかを特定します。
制限事項
Dataflow の分散トレースには次の制限があります。
- この機能は、ストリーミング パイプライン専用に設計され、検証されています。
- この機能を使用するには、Beam SDK for Java(バージョン 2.76.0 以降)を使用する必要があります。
- ステージ間のコンテキスト伝播には、Streaming Java Runner(以前は Runner v1 と呼ばれていました)が必要です。ポータブル ランナー(以前は Runner v2 と呼ばれていました)は、シャッフル境界でトレース コンテキストをリセットします。
- Beam I/O コネクタの組み込み OpenTelemetry トレースは、Pub/Sub、Apache Kafka、Spanner 変更ストリームのコネクタでのみサポートされています。Apache Kafka の場合、トレースは
KafkaIOコネクタを直接使用する場合にのみサポートされます。Kafka 向けマネージド I/O を使用する場合はサポートされません。他の I/O コネクタ(BigtableIOなど)には、コネクタ トレースが組み込まれていません。これらのサービスでオペレーションをトレースするには、ユーザーコード内(DoFnなど)で呼び出しをインストルメントします。 - 複数の要素を 1 つに結合するオペレーションは、単一のトレース コンテキストを伝播しません。これには、
GroupByKey、CoGroupByKey、Combineなどのオペレーションが含まれます。 - タイマーの設定(
Timer.set())と@OnTimerコールバック メソッドの実行の間でコンテキストが伝播されません。
前提条件
Dataflow で分散トレースを使用するには、環境が次の要件を満たしていることを確認してください。
- ジョブは次の要件を満たしている必要があります。
- ストリーミング パイプラインである
- Streaming Java Runner(以前は Runner v1 と呼ばれていました)を使用します。
- Apache Beam Java SDK バージョン 2.76.0 以降を使用する
トレースを Cloud Trace にエクスポートする場合は、 Google Cloud プロジェクトで Telemetry API(
telemetry.googleapis.com)を有効にします。API を有効にするために必要なロール
API を有効にするには、
serviceusage.services.enable権限が必要です。プロジェクトを作成した場合は、オーナーロール(roles/owner)を通じてこの権限がすでに付与されている可能性があります。それ以外の場合は、Service Usage 管理者ロール(roles/serviceusage.serviceUsageAdmin)を通じてこの権限を取得できます。ロールを付与する方法を確認する。ワーカー サービス アカウントには、
cloudtrace.traces.patch権限を含む Cloud Trace エージェント(roles/cloudtrace.agent)ロールが必要です。
基本コンセプト
分散トレースは、次の OpenTelemetry のコンセプトに基づいています。
- トレース
- 分散システムを流れる完全なトランザクションまたはワークフローの表現。トレースは、1 つ以上のスパンで構成されます。
- スパン
- トレースの基本的な構成要素で、単一の作業単位を表します。たとえば、変換の実行、メソッド呼び出し、RPC リクエストなどです。
- コンテキスト
- スレッドと API の境界を越えて伝播される状態。これには、トレース ID とスパン ID が含まれます。
- 伝播器
- ネットワーク境界を越えてコンテキスト表現を挿入および抽出するために使用されるメカニズム。たとえば、W3C トレース コンテキストなどです。
- エクスポータ
- 収集されたスパンデータを、Cloud Trace やセルフホストの OpenTelemetry Collector などのトレース バックエンドに送信するコンポーネント。
- サンプラー
- どのトレースを記録してエクスポートするかを決定することで、トレースの量を制御するメカニズム。たとえば、1% のサンプリング レートなどです。
OpenTelemetry のトレースを有効にする
デフォルト設定で OpenTelemetry トレースを有効にするには、ジョブを送信するときに必要なパイプライン オプションと試験運用を構成します。デフォルト設定では、1% のサンプリングで Cloud Trace にエクスポートされます。
デフォルト値を変更するには、トレース プロパティを設定して変更するをご覧ください。
ジョブの実行時に、パイプライン オプションとテストを構成します。
非 Flex テンプレート ジョブ
ジョブを送信するときに、次のテストフラグを渡します。
--experiments=enable_otel_defaults,element_metadata_supported,disable_portable_worker
Flex テンプレート ジョブ
gcloudコマンドで--additional-experimentsフラグを使用して、テストを渡します。gcloud dataflow flex-template run JOB_NAME \ --template-file-gcs-location=gs://BUCKET_NAME/templates/TEMPLATE_NAME.json \ --additional-experiments="enable_otel_defaults,element_metadata_supported,disable_portable_worker" \ --region=REGION次のように置き換えます。
- JOB_NAME: Dataflow ジョブの名前。
- BUCKET_NAME: テンプレートを含む Cloud Storage バケット。
- TEMPLATE_NAME: Flex テンプレート ファイルの名前。
- REGION: ジョブを実行する Google Cloud リージョン。
これらのテストでは、次の動作を構成します。
enable_otel_defaults: Cloud Trace エクスポーターや 1% のサンプリングなど、標準の OpenTelemetry のデフォルトを構成します。element_metadata_supported: パイプライン ステージ間でメタデータ(トレース コンテキストなど)のシリアル化と伝播を有効にします。disable_portable_worker: Dataflow Streaming Java Runner(以前は Runner v1 と呼ばれていました)の使用を強制します。
Beam SDK for Java バージョン 2.76.0 または 2.77.0 を使用する場合は、必要な OpenTelemetry 依存関係をビルド構成に追加します。
バージョン 2.76.0 と 2.77.0 の問題により、トレースをエクスポートするには、次の依存関係を
pom.xmlファイルに追加する必要があります。詳細については、パイプラインの依存関係を管理するをご覧ください。<dependency> <groupId>io.opentelemetry</groupId> <artifactId>opentelemetry-sdk-extension-autoconfigure</artifactId> <scope>compile</scope> </dependency> <dependency> <groupId>io.opentelemetry</groupId> <artifactId>opentelemetry-exporter-otlp</artifactId> <version>1.62.0</version> <scope>compile</scope> </dependency> <dependency> <groupId>org.apache.beam</groupId> <artifactId>beam-sdks-java-extensions-opentelemetry-gcp-auth-extension</artifactId> <scope>compile</scope> </dependency>パイプライン コードで、サポートされている I/O コネクタで OpenTelemetry トレースを明示的に有効にします。
Pub/Sub
Pub/Sub からの読み取りまたは Pub/Sub への書き込み時にトレースを有効にするには:
// Reading from Pub/Sub
pipeline.apply("ReadFromPubSub",
    PubsubIO.readMessages()
        .withEnableOpenTelemetryTracing()
        .fromSubscription("projects/PROJECT_ID/subscriptions/SUBSCRIPTION_ID"));

// Writing to Pub/Sub
pipeline.apply("WriteToPubSub",
    PubsubIO.writeStrings()
        .withEnableOpenTelemetryTracing()
        .to("projects/PROJECT_ID/topics/TOPIC_ID"));
次のように置き換えます。
- PROJECT_ID: 実際の Google Cloud プロジェクト ID。
- SUBSCRIPTION_ID: Pub/Sub サブスクリプションの名前。
- TOPIC_ID: Pub/Sub トピックの名前。
コンテキスト伝播の詳細:
- アップストリーム パブリッシャー: 外部アプリケーションからメッセージをパブリッシュするときに、W3C トレース コンテキストを Pub/Sub メッセージ属性に挿入します。詳細については、Pub/Sub OpenTelemetry トレースをご覧ください。
- 属性: Beam は次の属性を想定し、入力します。
googclient_traceparent: W3Ctraceparentヘッダーを伝送します。googclient_tracestate: W3Ctracestateヘッダーを伝送します。
- ヘッダーの形式については、W3C トレース コンテキスト仕様をご覧ください。
Apache Kafka
Apache Kafka からの読み取りまたは Apache Kafka への書き込み時にトレースを有効にするには:
// Reading from Kafka
pipeline.apply("ReadFromKafka",
    KafkaIO.<String, String>read()
        .withEnableOpenTelemetryTracing()
        // ... additional configuration
        );

// Writing to Kafka
pipeline.apply("WriteToKafka",
    KafkaIO.<String, String>write()
        .withEnableOpenTelemetryTracing()
        // ... additional configuration
        );
コンテキスト伝播の詳細:
KafkaIOは、標準の Kafka レコード ヘッダーを使用してコンテキストを伝播します。- W3C トレース コンテキスト仕様に準拠したヘッダーを想定して挿入します。
traceparent: 受信トレース コンテキストを識別します。tracestate: ベンダー固有の追加のルーティングとフィルタリングのメタデータを提供します。
Spanner
Spanner 変更ストリームから読み取る際にトレースを有効にするには:
pipeline.apply("ReadChangeStream",
    SpannerIO.readChangeStream()
        .withSpannerConfig(spannerConfig)
        .withEnableOpenTelemetryTracing(true)
        .withChangeStreamName("CHANGE_STREAM_NAME"));
次のように置き換えます。
- CHANGE_STREAM_NAME: Spanner 変更ストリームの名前。
スパン作成の詳細:
- トレースを有効にすると、変更データ キャプチャ(CDC)リーダーによって読み取られたデータベース変更レコードごとに、新しいトレースとスパンが開始されます。
- 新しいレコードを返さない Spanner リーダーのポーリング サイクルでも、Cloud Trace UI でフィルタリングできるトレーススパンが生成されることがあります。
トレース プロパティを設定して変更する
enable_otel_defaults を指定すると、Dataflow は次のデフォルト プロパティを適用します。
| プロパティ | デフォルト値 | 説明 |
|---|---|---|
otel.traces.exporter |
otlp |
OpenTelemetry Protocol(OTLP)を使用してトレースをエクスポートします。 |
otel.exporter.otlp.endpoint |
https://telemetry.googleapis.com |
Cloud Trace OTLP レシーバーをターゲットにします。 |
google.cloud.project |
プロジェクト ID | トレースが保存されている Google Cloud プロジェクト。 |
otel.traces.sampler.arg |
0.01(1%) |
100 個のトレースごとに 1 個のトレースを記録します。 |
otel.service.name |
options.getAppName() |
スパンに関連付けられたサービス名。パイプラインの appName オプションから派生します。 |
OpenTelemetry 構成をカスタマイズするには、プロパティのセミコロン区切りリストを --openTelemetryProperties パイプライン オプションに渡します。
次の例では、すべてのデフォルト プロパティを明示的に構成しています。
--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=https://telemetry.googleapis.com;google.cloud.project=PROJECT_ID;otel.traces.sampler.arg=0.01;otel.service.name=CUSTOM_SERVICE_NAME;otel.java.global-autoconfigure.enabled=true"
カスタム サービス名を設定する
デフォルトでは、トレース サービス名はパイプラインの appName オプション(--appName=YourPipelineName)から派生します。この値をオーバーライドするには、otel.service.name プロパティを設定します。
--openTelemetryProperties="otel.service.name=CUSTOM_SERVICE_NAME"
サンプリング レートとプロパティを変更する
サンプリング レートを高く設定すると、より堅牢なトレース情報が得られます。ただし、高いサンプルレート(1.0 や always_on など)を使用すると、Cloud Trace に送信されるトレースデータの量が増加し、 Google Cloud の費用が増加する可能性があります。高いサンプルレートは短期間のデバッグにのみ使用し、本番環境のワークロードでは減らしてください。
次の例では、サンプリング レートを明示的に構成しています。この場合、引数の完全なリストを指定する必要があります。
--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=https://telemetry.googleapis.com;google.cloud.project=PROJECT_ID;otel.traces.sampler.arg=0.02;otel.service.name=CUSTOM_SERVICE_NAME;otel.java.global-autoconfigure.enabled=true"
サードパーティのバックエンドにエクスポートする
Cloud Trace ではなく、外部のマネージド トレース バックエンドまたはセルフホストの OpenTelemetry Collector にトレースを送信するには:
- 次のテストは省略します:
--experiments=enable_otel_defaults。 --openTelemetryPropertiesを使用してエクスポータのプロパティを手動で構成します。--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=http://COLLECTOR_HOST:4317;otel.traces.sampler=parentbased_always_on"
Google Cloud 認証拡張機能
Beam ランタイムには、telemetry.googleapis.com などの Google API に送信された OpenTelemetry Protocol(OTLP)リクエストを自動的に認証する Google Cloud 認証拡張機能が含まれています。
- デフォルトを使用する場合: Google Cloud 認証が自動的に有効になります。
- Google 以外のエンドポイントにエクスポートする場合:
enable_otel_defaultsが省略されている場合、Beam はシステム プロパティgoogle.otel.auth.target.signals=noneを設定して Google Cloud 認証拡張機能を無効にします。 - 手動構成:
google.otel.auth.target.signalsシステム プロパティをnone(無効)またはtrace(トレースのみ有効)に設定できます。
DoFn でカスタム トレースを書き込む
DoFn 内など、ユーザーコード内にカスタム スパンを作成して、特定のオペレーションを測定できます。これには、外部 API への呼び出しやコンピューティング負荷の高いロジックが含まれます。
DoFn 実装の例
import io.opentelemetry.api.trace.Span;
import io.opentelemetry.api.trace.StatusCode;
import io.opentelemetry.api.trace.Tracer;
import io.opentelemetry.context.Scope;
import org.apache.beam.sdk.options.PipelineOptions;
import org.apache.beam.sdk.options.SdkHarnessOptions;
import org.apache.beam.sdk.transforms.DoFn;

public class InvestigateTransactionDoFn extends DoFn<Transaction, RiskAssessment> {
  private transient Tracer tracer;

  @Setup
  public void setup(PipelineOptions options) {
    // Obtain the Tracer instance from SdkHarnessOptions
    this.tracer = options
        .as(SdkHarnessOptions.class)
        .getOpenTelemetry()
        .getTracer("org.apache.beam.examples.adk.aml");
  }

  @ProcessElement
  public void processElement(@Element Transaction tx, OutputReceiver<RiskAssessment> out) {
    // Create and start a custom span as a child of the active context
    Span span = tracer.spanBuilder("InvestigateTransactionDoFn:Analyze")
        .setAttribute("transaction.id", tx.getId())
        .setAttribute("transaction.amount", tx.getAmount())
        .startSpan();

    // Make the span current in the execution thread
    try (Scope scope = span.makeCurrent()) {
      // Perform your logic (such as calling an external service)
      RiskAssessment assessment = analyzeTransactionWithLLM(tx);
      out.output(assessment);
    } catch (Exception e) {
      // Record exception details and set error status on the span
      span.recordException(e);
      span.setStatus(StatusCode.ERROR, e.getMessage());
      throw e;
    } finally {
      // Always end the span
      span.end();
    }
  }

  private RiskAssessment analyzeTransactionWithLLM(Transaction tx) {
    // Application analysis logic
    return new RiskAssessment();
  }
}
クライアント ライブラリと統合する
DoFn が OpenTelemetry もサポートする外部ライブラリ( Google Cloud クライアント ライブラリなど)を呼び出す場合は、子スパンがパイプライン トレースに直接リンクするように、パイプラインの OpenTelemetry インスタンスを使用するようにクライアントを構成します。
Spanner Java クライアントの例
DoFn 内で手動の Spanner クエリを実行し、それらのスパンをアクティブなパイプライン トレースにリンクするには、パイプラインの OpenTelemetry インスタンスを使用して SpannerOptions を初期化します。
import com.google.cloud.spanner.DatabaseClient;
import com.google.cloud.spanner.DatabaseId;
import com.google.cloud.spanner.ResultSet;
import com.google.cloud.spanner.Spanner;
import com.google.cloud.spanner.SpannerOptions;
import com.google.cloud.spanner.Statement;
import org.apache.beam.sdk.options.PipelineOptions;
import org.apache.beam.sdk.options.SdkHarnessOptions;
import org.apache.beam.sdk.transforms.DoFn;

public class SpannerEnrichmentDoFn extends DoFn<String, String> {
  private transient Spanner spanner;
  private transient DatabaseClient dbClient;
  private final String instanceId;
  private final String databaseId;

  public SpannerEnrichmentDoFn(String instanceId, String databaseId) {
    this.instanceId = instanceId;
    this.databaseId = databaseId;
  }

  @Setup
  public void setup(PipelineOptions pipelineOptions) {
    // Build SpannerOptions leveraging the pipeline's active OpenTelemetry instance
    SpannerOptions options =
        SpannerOptions.newBuilder()
            .setOpenTelemetry(pipelineOptions
                .as(SdkHarnessOptions.class)
                .getOpenTelemetry())
            .setEnableEndToEndTracing(true)
            .setEnableExtendedTracing(true)
            .build();

    this.spanner = options.getService();
    DatabaseId db = DatabaseId.of(options.getProjectId(), instanceId, databaseId);
    this.dbClient = spanner.getDatabaseClient(db);
  }

  @ProcessElement
  public void processElement(@Element String inputId, OutputReceiver<String> out) {
    Statement statement = Statement.newBuilder(
        "SELECT Details FROM AccountTable WHERE AccountId = @id")
        .bind("id").to(inputId)
        .build();

    // Spanner queries automatically generate child spans linked to the active trace
    try (ResultSet rs = dbClient.singleUse().executeQuery(statement)) {
      while (rs.next()) {
        out.output(rs.getString("Details"));
      }
    }
  }

  @Teardown
  public void tearDown() {
    if (spanner != null) {
      spanner.close();
    }
  }
}
ステージ間のコンテキスト伝播
分散データ パイプラインでは、エンドツーエンドの可視性を確保するために、ワーカーの境界とシャッフル オペレーション全体でトレース コンテキストを伝播することが不可欠です。
Redistribute.arbitrarily() をパイプラインに挿入すると、アクティブなトレース コンテキストが要素メタデータにシリアル化され、ネットワーク経由で送信され、受信側のワーカー VM で逆シリアル化されます。これにより、ステージ間でトレースの継続性が確保されます。
次の例は、トレース コンテキストがパイプライン ステージ間で伝播される方法を示しています。
- コンテキストを抽出する:
KafkaIO.read()は受信レコードを読み取り、メッセージ ヘッダーからトレース コンテキストを抽出します。 - スパンを処理して作成する:
DoFn Aは、アクティブなトレース スパン内の要素を処理します。 - ワーカー間で伝播する:
Redistribute.arbitrarily()は、アクティブなトレース コンテキストを要素メタデータにシリアル化し、ネットワーク全体で要素をシャッフルします。 - トレースを続行する:
DoFn Bはワーカー VM で要素を受け取り、トレース コンテキストを逆シリアル化して、同じトレース ID で処理を続行します。
Cloud Trace でトレースを表示する
トレースを有効にしたら、 Google Cloud コンソールでパイプラインのトレースを表示します。
Google Cloud コンソールで、[Trace エクスプローラ] ページに移動します。
フィルタ ボックスで、
Service: SERVICE_NAMEでフィルタします。この SERVICE_NAME は、パイプラインのappNameまたは構成されたotel.service.nameと一致します。または、特定のトレース ID を検索します。
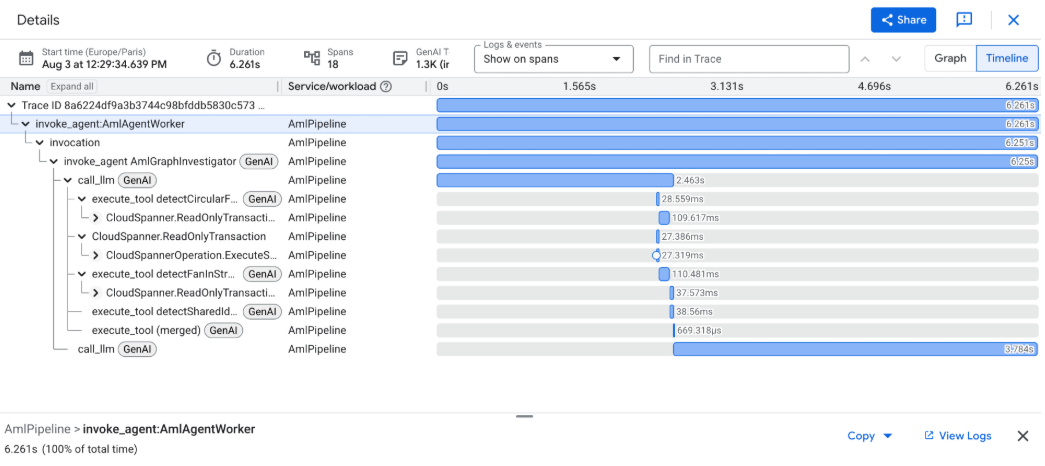
結果リストからトレースを選択すると、詳細なタイムラインが表示されます。
タイムライン グラフには次の内容が表示されます。
- ランナー スパン: Beam ランタイムによって生成されたスパン。たとえば、
PubSubIO.ReadやProcessElementです。 - カスタム スパン:
DoFn実装内で作成されたスパン。例:InvestigateTransactionDoFn:Analyze。 クライアント ライブラリのスパン: 統合されたクライアント ライブラリによって生成された子スパン。たとえば、Spanner RPC クエリなどです。
- ランナー スパン: Beam ランタイムによって生成されたスパン。たとえば、
次のステップ
- 分散トレースの調査と分析の詳細については、Cloud Trace のドキュメントをご覧ください。
- Pub/Sub OpenTelemetry トレースを使用して、取り込みから処理までのメッセージをトレースします。
- Dataflow モニタリング インターフェースを使用して、パイプラインのスループット、CPU 使用率、実行の詳細をモニタリングします。
- Dataflow パイプライン ログを使用して、オペレーション ログを表示し、エラーを診断します。
- 遅いジョブや停止したジョブのトラブルシューティングとパイプラインのボトルネックを検出して解決するで、パフォーマンスの問題を調査して解決します。