


読み取り / 書き込みの一貫性を損なうことなく、またアプリケーション接続エンドポイントを変更することなく、プライマリ インスタンスから読み取りトラフィックをオフロードするには、AlloyDB for PostgreSQL インスタンスで透過的なクエリ転送を有効にして構成し、モニタリングします。透過的なクエリ転送は、プライマリ ノードで読み取り専用クエリをインターセプトし、使用率の低い読み取りプール インスタンスに選択的にルーティングして、プライマリ ノードの実行と一致する結果を返します。
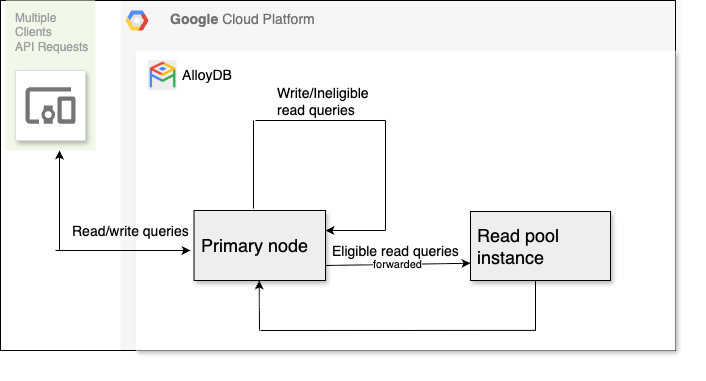
透過的なクエリ転送は、次のシナリオに最適です。
- ハイブリッド ワークロード(HTAP): トランザクションを処理する同じデータベースで、read-your-writes の整合性を備えたレポートクエリまたは分析クエリを実行し、高コストの読み取りが書き込みレイテンシに影響しないようにします。
- モノリシック アプリケーション: 読み取りプールの容量を使用したいが、アプリケーションをリファクタリングして個別のリーダー エンドポイントとライター エンドポイントを使用することは避けたい。ただし、厳密な書き込み後読み取りの整合性は必要。
- 動的な負荷管理: 読み取りトラフィックの予測できない急増が発生し、プライマリ ノードの負荷が高いときに、データベースが読み取りプールノードにワークロードを自動的にオフロードして、読み取り整合性を確保したい。
始める前に
AlloyDB クラスタが PostgreSQL 17 または 18 と互換性があることを確認します。
AlloyDB クラスタに、少なくとも 1 つのアクティブな読み取りプール インスタンスが構成されている必要があります。読み取りプール インスタンスの作成または確認については、クラスタに読み取りプール インスタンスを作成するとインスタンスの詳細を表示するをご覧ください。
必要なロール
postgresなどの組み込みデータベース ユーザーを使用して接続していることを確認します。IAM ベースの認証はサポートされていません。
透過的なクエリ転送を有効にする
透過的なクエリ転送はデフォルトで無効になっています。データベースを再起動することなく、セッション レベルまたはデータベース レベルで動的に有効にできます。
セッション レベルで有効にする
現在のセッションで透過的なクエリ転送を有効にするには、次の SQL コマンドを実行します。
SET alloydb.enable_query_forwarding = TRUE;
データベース レベルで有効にする
特定のデータベースで透過的なクエリ転送を有効にするには、次の SQL コマンドを実行します。
ALTER DATABASE DATABASE_NAME SET alloydb.enable_query_forwarding = ON;
DATABASE_NAME は、実際のデータベースの名前に置き換えます。
クエリの適格条件
- 透過的なクエリ転送は、読み取り専用の
SELECTステートメントにのみ適用されます。 - クエリは、
SELECT ... FOR UPDATEで使用されるような行レベルのロックを取得してはなりません。 - 透過的なクエリ転送では、マルチステートメント トランザクション内の
SELECTステートメントのサポートが制限されています。 - クエリで一時テーブル、ログに記録されていないテーブル、カタログ テーブルを参照することはできません。
- クエリは、次の関数制約に準拠している必要があります。
- クエリに揮発性関数やユーザー定義関数(UDF)を含めることはできません。
- クエリに
CURRENT_DATE、LOCALTIME、USER、CURRENT_SCHEMAなどの SQL 値関数を含めることはできません。 - クエリに
NEXTVAL()式を含めることはできません。 - クエリに SQL プロシージャや SQL 関数を含めることはできません。
- すべての結果列で、バイナリの送受信関数を実装するデータ型を使用する必要があります。
- クエリのオーバーヘッド コストがクエリの合計コストと比較して最小限である場合にのみ、クエリは転送の対象となります。つまり、インデックス スキャンを使用するクエリは、通常、オーバーヘッドがクエリ自体の費用を上回るため、除外されます。
- AlloyDB ホット スタンバイ ノードへの転送はサポートされていません。AlloyDB ホット スタンバイ ノードは、高可用性(HA)プライマリ インスタンス専用のセカンダリ ノードです。
- クエリでは、シンプルなクエリ プロトコルを使用する必要があります。拡張クエリ プロトコルはサポートされていません。
EXPLAIN を使用してクエリの適格性を確認する
次の例では、large_table は多数の行を含むデータベース内のテーブルです。現在の構成で特定のクエリが転送の対象となるかどうかを確認するには、EXPLAIN コマンドを実行します。
EXPLAIN SELECT count(*) FROM large_table t1, large_table t2;
クエリが対象となる場合、出力には、標準の Postgres 実行プランの後にクエリ転送ステータス ステートメントが含まれます。このステートメントがない場合、クエリはクエリ転送の対象にならず、プライマリでローカルに実行されます。
Aggregate  (cost=25000.00..25000.01 rows=1 width=8)
  ->  Nested Loop  (cost=0.00..20000.00 rows=1000000 width=0)
        ... [Standard Postgres Plan Steps] ...
Query Forwarding: Eligible. (overhead=1250.02)
出力レスポンスの Eligible は、クエリが標準の読み取り専用 SQL の条件を満たしており、費用対効果分析で読み取りプール インスタンスへのルーティングが推奨されていることを示します。overhead パラメータは、クエリを読み取りプール インスタンスに転送する際の計算されたプランナー コストを示します。これには、接続の確立とレプリカでのスナップショットの復元のオーバーヘッドが含まれます。
クエリ転送指標をモニタリングする
透過的なクエリ転送がワークロード全体で機能していることを確認するには、Cloud Monitoring で次の指標を追跡します。
| 指標 | 説明 | 詳細 |
|---|---|---|
alloydb.googleapis.com/internal/database/postgresql/workload/distributed/tqf_query_count |
透過的なクエリ転送によって処理されたクエリの累積数。 | 表示名: TQF クエリ数 指標の種類: CUMULATIVE 値のタイプ: INT64 ラベル: status: 透過的なクエリ転送が有効になっている場合のクエリ処理。このラベルには、次のいずれかの値が記録されます。
|