


運用アプリケーションに分析データへの低レイテンシのトランザクション アクセスを提供するには、BigQuery から AlloyDB for PostgreSQL インスタンスにテーブルを同期します。BigQuery のデータをクエリする外部データ ラッパー(FDW)とは異なり、同期機能はデータを AlloyDB ストレージにコピーします。これにより、クエリはローカル テーブルから読み取り、パフォーマンスを向上させます。
AlloyDB には、BigQuery データをインスタンスに移動する方法がいくつかあります。
1 回限りの同期: BigQuery テーブルの書き込み可能な独立したコピーを作成します。
定期的な同期またはミラーリング: スケジュール(6 時間ごと、毎日など)に従って自動的に更新される読み取り専用のローカル テーブルを作成します。
パフォーマンスと運用に関する考慮事項
BigQuery 同期テーブルを使用する場合は、次の点を考慮してください。
- リソース使用量: データの移動により、CPU とメモリが消費されます。非常に大きなテーブルの場合は、プライマリ トランザクション ワークロードに影響しないように、ピーク時間外に同期をスケジュールすることを検討してください。
- データの可視性: 置換オペレーション中に、既存のターゲット テーブルが削除され、事前に再作成されます。インポート中のクエリでは、最初は空のテーブルが表示され、バッチ トランザクションが commit されると、新しくインポートされたデータが段階的に表示されます。
始める前に
- AlloyDB インスタンスに
alloydb_sync.enabled=onデータベース フラグを設定します。詳細については、インスタンスのデータベース フラグを構成するをご覧ください。 alloydb_sync拡張機能はbigquery_fdwを使用して BigQuery に接続するため、bigquery_fdwが BigQuery のデータ型と列のマッピングを処理する方法を理解しておいてください。- Google Cloud アカウントにログインします。 Google Cloudを初めて使用する場合は、 アカウントを作成して、実際のシナリオで Google プロダクトのパフォーマンスを評価してください。新規のお客様には、ワークロードの実行、テスト、デプロイができる無料クレジット $300 分を差し上げます。
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
-
AlloyDB の作成と接続に必要な Cloud APIs を有効にします。
-
変更するプロジェクトの名前を確認するには、[プロジェクトを確認] の手順で [次へ] をクリックします。
-
[API を有効にする] の手順で、[有効にする] をクリックして、次の機能を有効にします。
- AlloyDB API
- Compute Engine API
- Cloud Resource Manager API
- Service Networking API
- BigQuery Storage API
AlloyDB と同じ Google Cloud プロジェクトにある VPC ネットワークを使用して AlloyDB へのネットワーク接続を構成する場合は、Service Networking API が必要です。
別の Google Cloud プロジェクトに存在する VPC ネットワークを使用して AlloyDB へのネットワーク接続を構成する場合は、Compute Engine API と Cloud Resource Manager API が必要です。
-
- データの同期元となる既存の BigQuery テーブルがあることを確認します。詳細については、BigQuery テーブルの作成と使用をご覧ください。
必要なロール
AlloyDB クラスタのサービス アカウントに BigQuery データセットへのアクセス権を付与するには、次の権限が必要です。
- BigQuery データ閲覧者(
roles/bigquery.dataViewer)、またはbigquery.tables.get権限とbigquery.tables.getData権限を含むカスタムロール。このロールをサービス アカウントに付与すると、テーブルまたはビューからデータとメタデータを読み取る権限が付与されます。 - BigQuery 読み取りセッション ユーザー(
roles/bigquery.readSessionUser)、またはbigquery.readsessions.create権限とbigquery.readsessions.getData権限を含むカスタムロール。読み取りセッションを作成および使用する権限が付与されます。 - BigQuery ジョブユーザー(
roles/bigquery.jobUser)、またはbigquery.jobs.create権限を含むカスタムロール。クエリジョブを含むジョブを作成して実行する機能を提供します。別のランタイム プロジェクトを指定すると、ジョブはデータ プロジェクトではなく、そのプロジェクトで実行されます。つまり、ランタイム プロジェクトにジョブユーザーのロールを付与する必要があります。
拡張機能の設定
BigQuery からテーブルを同期する前に、必要な拡張機能を有効にして、BigQuery への接続を構成します。 Google Cloud コンソールを使用する場合、AlloyDB はこれらの手順を自動的に実行します。
拡張機能を作成します。
- psql クライアントをインスタンスに接続するの手順に沿って、psql クライアントを使用して AlloyDB インスタンスに接続します。
次のコマンドを実行します。
CREATE EXTENSION IF NOT EXISTS alloydb_sync;
AlloyDB が BigQuery で認証できるようにするには、外部サーバーとユーザー マッピングを作成します。
CREATE EXTENSION IF NOT EXISTS bigquery_fdw; CREATE SERVER IF NOT EXISTS bigquery_server FOREIGN DATA WRAPPER bigquery_fdw OPTIONS (runtime_project 'RUNTIME_PROJECT_ID'); CREATE USER MAPPING IF NOT EXISTS FOR USER SERVER bigquery_server;次のように置き換えます。
RUNTIME_PROJECT_ID: 省略可。クエリを処理してコンピューティング費用が発生するGoogle Cloud プロジェクトの ID。省略すると、クエリはデータを保存するプロジェクトに課金されます。USER: BigQuery テーブルにアクセスするデータベース ユーザー名または IAM ユーザー。
1 回限りのエクスポート用に BigQuery テーブルを同期する
Google Cloud コンソールまたは psql を使用して、1 回限りのエクスポート用に BigQuery テーブルを同期できます。
Google Cloud コンソールを使用する
Google Cloud コンソールを使用して BigQuery テーブルを AlloyDB に同期するには、次の操作を行います。
Google Cloud コンソールで [BigQuery] ページを開きます。
左側のペインで、 エクスプローラをクリックします。
左側のペインが表示されていない場合は、 左ペインを開くをクリックしてペインを開きます。
[エクスプローラ] ペインでプロジェクトを開き、[データセット] をクリックして、データセットをクリックします。
[概要] > [テーブル] をクリックし、テーブルを選択します。
詳細ウィンドウで、[その他] > [AlloyDB へのエクスポートまたは同期] をクリックします。
[プロジェクトを選択] で、AlloyDB クラスタのプロジェクトを選択します。必要な権限がある場合は、現在の BigQuery プロジェクト以外のプロジェクトを選択できます。
[ターゲット クラスタを選択] で、次のいずれかのオプションを選択します。
[既存のクラスタを使用する] を選択して、BigQuery テーブルを既存の AlloyDB クラスタにエクスポートします。次に、以下の操作を行います。
プライマリ AlloyDB クラスタを選択します。
移行先の AlloyDB データベースを選択します。
宛先の AlloyDB テーブルのスキーマを選択します。
宛先の AlloyDB テーブルの名前を指定します。
[同期頻度] で [1 回限り] を選択して、BigQuery テーブルのコピーを作成します。
[エクスポートを設定] をクリックします。
同期の設定が完了したら、提供された SQL ステートメントを使用して、インポート ジョブを追跡し、インポートされたテーブルをクエリできます。[クエリ] をクリックして、AlloyDB Studio でインポートされたテーブルに移動します。
[新しいクラスタを作成する] を選択して、BigQuery テーブルを新しい AlloyDB クラスタにエクスポートします。次に、以下の操作を行います。
[エクスポートを設定] をクリックします。
[AlloyDB へのリダイレクト] ダイアログで、[リダイレクト] を選択します。
クラスタタイプ([無料トライアル クラスタ] または [プロビジョニング済みのクラスタ])を選択します。
[続行] をクリックします。
[同期構成] で、デフォルトの
postgres宛先 AlloyDB データベース、宛先 AlloyDB テーブルのデフォルトのpublicスキーマを選択し、宛先 AlloyDB テーブルの名前を指定します。[同期頻度] で [1 回限り] を選択して、BigQuery テーブルのコピーを作成します。
[続行] をクリックします。
クラスタを構成します。各フィールドの詳細については、新しいクラスタとプライマリ インスタンスを作成するをご覧ください。
[クラスタを作成] をクリックします。
同期の設定が完了したら、AlloyDB Studio に移動して、インポートしたテーブルをクエリします。
psql を使用して BigQuery テーブルを 1 回同期する
BigQuery データの編集可能なコピーを作成するには、psql を使用して alloydb_sync.import_bq_table 関数を実行します。
SELECT alloydb_sync.import_bq_table(
  'PROJECT_ID.DATASET_ID.TABLE_ID',
  'ALLOYDB_DESTINATION_TABLE_NAME',
  'ON_EXISTS',
  ARRAY['PRIMARY_KEY_COLUMN']
);
次のように置き換えます。
PROJECT_ID: BigQuery データセットがあるプロジェクトの ID。DATASET_ID: テーブルの BigQuery データセットの名前。4 つの部分からなる名前を持つ Iceberg テーブルの場合、これはCatalog.Namespaceです。TABLE_ID: BigQuery テーブルまたはビューの名前。ALLOYDB_DESTINATION_TABLE_NAME: データの作成とインポートを行う AlloyDB データベース内のローカル テーブルの名前。スキーマ名(public.local_salesなど)を含めることができます。ON_EXISTS: 宛先テーブルがすでに存在する場合に使用する戦略。PRIMARY_KEY_COLUMN: 主キーとして使用する列名のリスト(省略可)。
例
次の例は、BigQuery データセットから transactions という名前のテーブルを public.local_sales という名前の新しい AlloyDB テーブルに同期する方法を示しています。
SELECT alloydb_sync.import_bq_table(
    'my-gcp-project.sales_data.transactions',
    'public.local_sales',
    'replace'
);
on_exists パラメータ
on_exists パラメータは、宛先テーブルが AlloyDB にすでに存在する場合に、関数が同期を処理する方法を決定します。
error: デフォルトのオプション。宛先テーブルがすでに存在する場合は、同期を停止します。skip: 宛先テーブルがすでに存在する場合は、同期をスキップします。replace: 既存のローカル テーブルを BigQuery の新しいデータに置き換えます。
主キーのサポート
オプションの primary_key パラメータをテキスト配列として指定すると、AlloyDB は指定された列を主キーとしてテーブルを作成します。
SELECT alloydb_sync.import_bq_table(
    'my-gcp-project.sales_data.transactions',
    'public.local_sales',
    ARRAY['transaction_id']
);
定期的なエクスポートのために BigQuery テーブルを同期する
Google Cloud コンソールまたは psql を使用して、定期的なエクスポート用に BigQuery テーブルを同期できます。
Google Cloud コンソールを使用する
Google Cloud コンソールを使用して BigQuery テーブルを AlloyDB に同期するには、次の操作を行います。
Google Cloud コンソールで [BigQuery] ページを開きます。
左側のペインで、 [エクスプローラ] をクリックします。
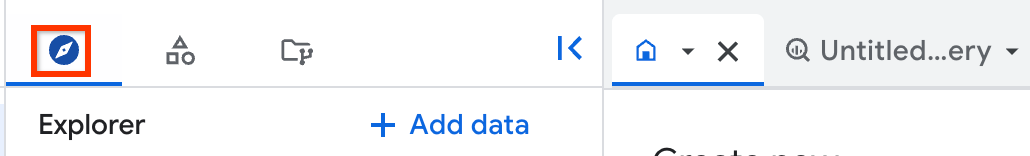
左側のペインが表示されていない場合は、 [左ペインを開く] をクリックしてペインを開きます。
[エクスプローラ] ペインでプロジェクトを開き、[データセット] をクリックして、データセットをクリックします。
[概要] > [テーブル] をクリックし、テーブルを選択します。
詳細ウィンドウで、[その他] > [AlloyDB へのエクスポートまたは同期] をクリックします。
[プロジェクトを選択] で、AlloyDB クラスタのプロジェクトを選択します。必要な権限がある場合は、現在の BigQuery プロジェクト以外のプロジェクトを選択できます。
[ターゲット クラスタを選択] で、次のいずれかのオプションを選択します。
[既存のクラスタを使用する] を選択して、BigQuery テーブルを既存の AlloyDB クラスタにエクスポートします。次に、以下の操作を行います。
プライマリ AlloyDB クラスタを選択します。
移行先の AlloyDB データベースを選択します。
宛先の AlloyDB テーブルのスキーマを選択します。
宛先の AlloyDB テーブルの名前を指定します。
[同期頻度] で、BigQuery テーブルの定期的な同期を作成する期間を選択します(例: [1 時間ごと]、[6 時間ごと])。
[エクスポートを設定] をクリックします。
同期の設定が完了したら、提供された SQL ステートメントを使用して、インポート ジョブを追跡し、インポートされたテーブルをクエリできます。[クエリ] をクリックして、AlloyDB Studio でインポートされたテーブルに移動します。
[新しいクラスタを作成する] を選択して、BigQuery テーブルを新しい AlloyDB クラスタにエクスポートします。次に、以下の操作を行います。
[エクスポートを設定] をクリックします。
[AlloyDB へのリダイレクト] ダイアログで、[リダイレクト] を選択します。
クラスタタイプ([無料トライアル クラスタ] または [プロビジョニング済みのクラスタ])を選択します。
[続行] をクリックします。
[同期構成] で、デフォルトの
postgres宛先 AlloyDB データベース、宛先 AlloyDB テーブルのデフォルトのpublicスキーマを選択し、宛先 AlloyDB テーブルの名前を指定します。[同期頻度] で [1 回限り] を選択して、BigQuery テーブルのコピーを作成します。
[続行] をクリックします。
クラスタを構成します。各フィールドの詳細については、新しいクラスタとプライマリ インスタンスを作成するをご覧ください。
[クラスタを作成] をクリックします。
同期の設定が完了したら、AlloyDB Studio に移動して、インポートしたテーブルをクエリします。
定期的な同期を作成する
BigQuery データと同期された読み取り専用テーブルを維持するには、psql を使用して alloydb_sync.create_bq_sync_table 関数を実行します。
SELECT alloydb_sync.create_bq_sync_table(
    'PROJECT_ID.DATASET_ID.TABLE_ID',
    'ALLOYDB_DESTINATION_TABLE_NAME',
    'REFRESH_INTERVAL',
    'ON_EXISTS',
    ARRAY['PRIMARY_KEY_COLUMN']
);
次のように置き換えます。
PROJECT_ID.DATASET_ID.TABLE_ID: BigQuery テーブルまたはビューの完全修飾名。プロジェクト ID、データセット ID、テーブル ID が含まれ、ピリオドで区切られます。4 つの部分からなる名前を持つ Iceberg テーブルの場合、DATASET_IDはCatalog.Namespaceとして表されます。例:my-gcp-project.sales_data.transactionsALLOYDB_DESTINATION_TABLE_NAME: データを作成して同期する AlloyDB データベース内のローカル テーブルの名前。REFRESH_INTERVAL: AlloyDB が BigQuery からデータを定期的に更新する間隔(例:12 hours)。ON_EXISTS: 宛先テーブルがすでに存在する場合に使用する戦略。PRIMARY_KEY_COLUMN: 主キーとして使用する列名のリスト(省略可)。
例
次の例は、12 時間ごとに更新される顧客プロファイル ミラーを作成する方法を示しています。
SELECT alloydb_sync.create_bq_sync_table(
    'my-gcp-project.crm_data.profiles',
    'public.customer_mirror',
    '12 hours',
    'replace'
);
ジョブをモニタリングして管理する
同期を開始したら、進行状況をモニタリングしてジョブを管理できます。
ジョブ ステータスの確認
大規模な同期には時間がかかることがあります。処理されたレコードや推定完了時間などの進行状況をモニタリングするには、job_status ビューに対してクエリを実行します。
SELECT
    import_id,
    status,
    records_processed,
    total_records,
    error_message
FROM alloydb_sync.job_status;
たとえば、ジョブをキャンセルするには、次のコマンドを実行します。
SELECT alloydb_sync.cancel_import_job('85bb5dfa-dfb9-4017-9153-738f55abe4b1');
同期ジョブを停止して削除する
BigQuery テーブルのミラーリングを停止してローカル テーブルを削除するには、alloydb_sync.delete_bq_sync_table 関数を使用します。
SELECT alloydb_sync.delete_bq_sync_table('public.customer_mirror');
データ型マッピング
alloydb_sync 拡張機能を使用して BigQuery から AlloyDB にデータを同期またはインポートすると、AlloyDB は BigQuery のデータ型をターゲット テーブルの対応する PostgreSQL のデータ型にマッピングします。
ソース BigQuery テーブルの列で、次の表に示すサポートされているデータ型が使用されていることを確認します。
| BigQuery テーブルのデータ型 | PostgreSQL のデータ型 |
|---|---|
BOOLEAN |
BOOLEAN |
INTEGER (INT64) |
BIGINT |
FLOAT (FLOAT64) |
DOUBLE PRECISION |
STRING |
TEXT |
NUMERIC |
NUMERIC |
BIGNUMERIC |
NUMERIC |
DATE |
DATE |
TIMESTAMP |
TIMESTAMPTZ |
TIME |
TIME |
DATETIME |
TIMESTAMP |
JSON |
JSONB |
BYTES |
BYTEA |
制限事項
BigQuery からテーブルを同期する場合は、次の制限が適用されます。
- この機能は、PostgreSQL バージョン 18 でのみサポートされています。
- この機能を使用するには、インスタンスに
alloydb_sync.enabled=onデータベース フラグが必要です。 - データベースで
bigquery_fdw外部サーバーとユーザー マッピングを構成する場合は、外部サーバーにbigquery_serverという名前を付ける必要があります。 ARRAY、STRUCT、VECTOR、GEOGRAPHY、RANGE、INTERVALなどの複雑な BigQuery データ型は、同期でサポートされていません。STRING(L)、BYTES(L)、NUMERIC(P, S)、BIGNUMERIC(P, S)などのパラメータ化された BigQuery データ型はTEXTにマッピングされます。詳細については、サポートされている BigQuery のデータ型と列のマッピングをご覧ください。primary_keyパラメータを指定する場合、主キー列名のカンマ区切りのリストは 1,023 バイト以下にする必要があります。また、行の JSON シリアル化された主キー列の名前と値は 255 バイト以下にする必要があります。alloydb_sync.create_bq_sync_table関数で作成された定期同期テーブルの場合、refresh_intervalパラメータは月または年をサポートしていません。間隔は、日数、24 未満の時間、60 未満の分、60 未満の秒の整数で指定します。1 hour 30 minutesや90 minutesなどの混合単位の間隔は、1 hourなどの最大時間単位の整数に切り捨てられます。同期ジョブを開始したデータベース ユーザー、または定期的な同期テーブルを作成したデータベース ユーザーのみが、次の操作を行うことができます。
alloydb_sync.job_statusビューでジョブを表示するalloydb_sync.cancel_import_job関数を使用してジョブをキャンセルするalloydb_sync.delete_bq_sync_table関数を使用して同期テーブルを削除する
同期ジョブは、単一のトランザクションではなく、バッチでデータを段階的に commit します。
replaceオペレーション中、宛先テーブルはデータの読み込み前に削除されて再作成されるため、ジョブが完了するまで、同時実行クエリには空のテーブルまたは部分的に入力されたテーブルが表示されます。インポート ジョブが失敗した場合、または完了前にキャンセルされた場合、部分的にインポートされた行と内部外部テーブル定義がデータベースに残ります。復元するには、on_existsパラメータをreplaceに設定してインポートを再実行します。新しく登録された定期同期テーブルの最初のバックグラウンド インポート中に中断が発生した場合、テーブルは次のスケジュールされた更新間隔まで不完全なままになります。
バックグラウンド ジョブ トラッカー ワーカーが、定期的な同期テーブルまたは過去 10 秒以内の同期アクティビティを含むデータベースに接続されている間、標準の
DROP DATABASEコマンドは失敗します。alloydb_sync.create_bq_sync_table関数を使用して構成された定期同期テーブルがないデータベースでは、バックグラウンド ジョブ トラッカー ワーカーは 10 秒間のアイドル時間の後にシャットダウンします。ワーカーは、次のalloydb_sync.import_bq_table関数呼び出し時、またはalloydb_sync拡張機能が削除されて再作成されたときに、新しい動的共有メモリ セグメントを割り当てます。アクティブな定期同期テーブルがない状態で、アイドル期間を挟んで多数の分離された 1 回限りのインポートを実行すると、共有メモリ スロットが枯渇し、インスタンスの再起動が必要になることがあります。
ベスト プラクティス
BigQuery からのテーブル同期を構成して管理する場合は、次のベスト プラクティスに従ってください。
- 同期関数を呼び出す前に、独自の commit 済みトランザクションで
CREATE EXTENSION IF NOT EXISTS alloydb_sync CASCADE;ステートメントを実行します。 - インポート中にソース BigQuery テーブルを変更しないでください。ソーステーブルが同時に更新されると、同期ジョブによって更新されたデータがインポートされることがあります。
alloydb_sync.import_bq_table、alloydb_sync.create_bq_sync_table、alloydb_sync.delete_bq_sync_table関数を呼び出す場合は、public.my_tableなどの一貫したスキーマ修飾の宛先テーブル名を指定します。同じ宛先テーブルに対して複数の同期ジョブを同時に開始しないでください。同じクラスタ上の複数のデータベースでテーブルを同期する場合は、データベース間で異なるスキーマ名またはテーブル名を使用します。alloydb_sync.create_bq_sync_table関数を使用して定期的な同期テーブルを作成する場合は、on_existsパラメータをreplaceに設定して、スケジュールされた更新で宛先テーブルが更新されるようにします。refresh_intervalパラメータは、1 日、24 時間未満、60 分未満、60 秒未満のいずれかの単位で指定します。- 非常に大きな BigQuery テーブルをインポートする場合は、インポートが一時ファイルサイズの上限を超えないように、インスタンスの
temp_file_limitデータベース フラグの値と、必要に応じてwork_memフラグの値を増やします。インポート中、受信行はwork_memの上限までメモリにバッファリングされ、バッチ commit が完了する前にローカルの PostgreSQL 一時ファイルにステージングされます。 - レプリケートされた同期テーブルまたはインポートがアクティブなテーブルで
DROP TABLEステートメントを手動で実行しないでください。進行中のインポートを停止するには、まず、ジョブを開始したデータベース ユーザーとしてalloydb_sync.cancel_import_job関数を実行します。定期的な同期テーブルとそのスケジュールを削除するには、alloydb_sync.delete_bq_sync_table関数を使用し、同期テーブルの作成時に使用した正確な宛先テーブル名を渡します。 - 1 回限りのインポートが失敗した場合、または完了前にキャンセルされた場合は、
on_existsパラメータをreplaceに設定してalloydb_sync.import_bq_table関数を再実行します。新しく登録された定期同期テーブルの最初のバックグラウンド インポートが中断され、次のスケジュールされた更新を待たずにすぐに解決する場合は、alloydb_sync.delete_bq_sync_table関数を使用して同期テーブルを削除し、再作成します。 ジョブの開始時に
max_worker_processesのバックグラウンド ワーカー スロットが枯渇した場合、またはインポートがキューに格納されているか実行中にデータベースがクラッシュした場合、ジョブ メタデータがQUEUED状態またはRUNNING状態のままになり、そのテーブルへの今後のインポートがブロックされる可能性があります。テーブルのブロックを解除するには、次のコマンドを実行して、ジョブを開始したデータベース ユーザーとしてジョブのステータスを更新します。UPDATE alloydb_sync.import_job_status SET status = 'FAILED' WHERE status IN ('QUEUED', 'RUNNING');定期的な同期テーブルまたは最近の同期アクティビティがあるデータベースを削除するには、
DROP DATABASE DATABASE_NAME WITH (FORCE)を実行するか、まずすべての同期テーブルを削除して、バックグラウンド トラッカー ワーカーが終了するまで 10 秒以上待ちます。ワーカーがデータベースに接続されているかどうかを確認するには、pg_stat_activityビューに対してクエリを実行します。SELECT pid, datname, backend_type FROM pg_stat_activity WHERE datname = 'DATABASE_NAME' AND backend_type = 'job_tracker';DATABASE_NAMEは、実際のデータベースの名前に置き換えます。
料金
BigQuery から AlloyDB にデータを同期すると、BigQuery ストリーミング読み取り(Storage Read API)の料金が適用されます。
データのエクスポート後、AlloyDB にデータを保存すると料金が発生します。詳細については、AlloyDB for PostgreSQL の料金をご覧ください。
次のステップ
- AlloyDB にデータをエクスポートする(リバース ETL)の詳細を確認する。
- 詳しくは、FDW を使用して BigQuery データをインプレースでクエリするをご覧ください。