


AlloyDB for PostgreSQL の最適化された関数を使用すると、より小さく高速なプロキシモデルを使用して、AI 関数を使用するほとんどの SQL クエリを処理できます。必要な場合にのみ、より大きな大規模言語モデル(LLM)にフォールバックします。このアプローチにより、行ごとの分類タスクやフィルタリング タスクのリモート LLM 呼び出しが最小限に抑えられ、運用コストが削減され、クエリの応答性が向上します。
ai.if() などの AlloyDB AI 関数は、大規模言語モデル(LLM)へのリモート呼び出しにより、レイテンシが高くなることがあります。最適化された関数は、ローカルでトレーニングされた小さなプロキシモデルを使用してクエリを処理することで、このレイテンシの問題に対処します。これらのモデルは、LLM の出力を信頼できる情報源として使用し、データのサンプルでトレーニングされます。
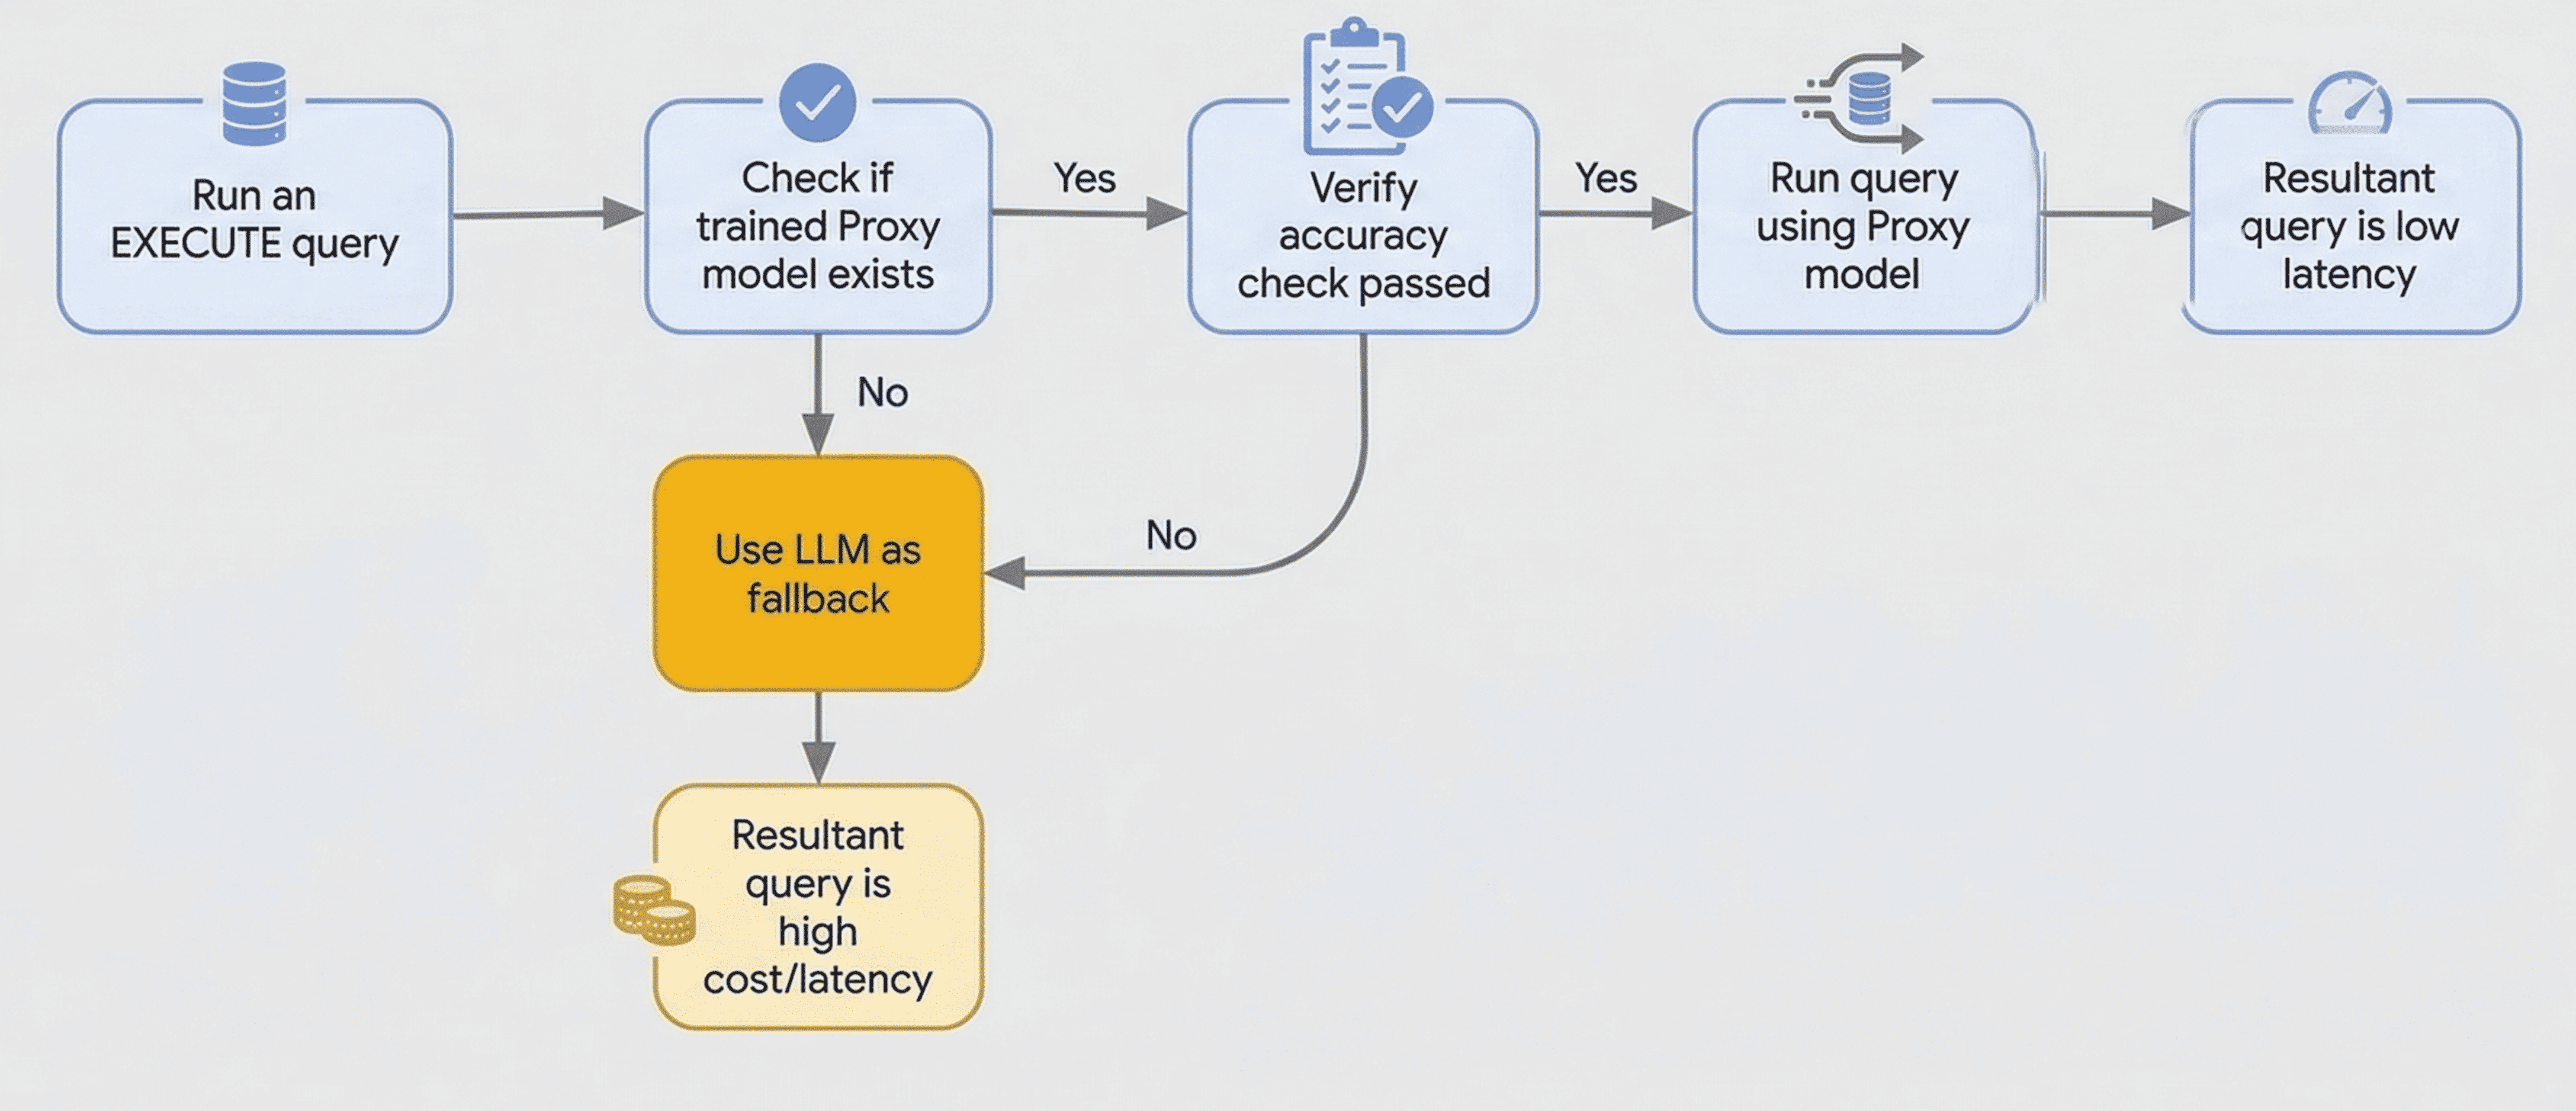
精度チェックは、LLM を使用して行のサンプルに対して実行時に行われます。このチェックを行うために、AlloyDB は LLM を使用してサンプル行のラベルを生成し、プロキシモデルの予測と比較して精度を検証します。精度チェックに失敗すると、クエリは LLM の使用にフォールバックします。
最適化された関数を使用すると、AlloyDB は次の処理を行います。
- プロキシモデルをトレーニングする: AlloyDB は、データのサンプルに基づいて軽量なプロキシモデルをトレーニングします。これは、最適化されたクエリのモデルをトレーニングするために、
ai.if()関数でPREPAREステートメントを使用すると、バックグラウンドで行われます。 - クエリを実行する:
EXECUTEステートメントを使用すると、AlloyDB はトレーニング済みのプロキシモデルを使用してクエリをローカルで処理します。 - LLM にフォールバックする: モデルの精度が低い場合や、モデルが見つからない場合、AlloyDB は自動的に LLM の使用にフォールバックします。
始める前に
最適化された関数を使用する前に、次の操作を行います。
- psql または AlloyDB Studio を使用して、
postgresユーザーとして、またはデータが存在するテーブルにアクセスできるユーザーとしてデータベースに接続します。 google_ml_integration拡張機能がインストールされ、バージョン 1.5.8 以降で使用可能であることを確認します。SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration'; extversion ------------ 1.5.8 (1 row)Gemini Enterprise Agent Platform で動作するように AlloyDB を構成します。詳細については、データベースを Agent Platform と統合するをご覧ください。
次のデータベース フラグが有効になっていることを確認します。詳細については、インスタンスのデータベース フラグを構成するをご覧ください。
google_ml_integration.enable_model_supportgoogle_ml_integration.enable_ai_query_enginegoogle_ml_integration.enable_cost_optimized_ai_functions
クエリを実行するテーブルのエンベディングを生成します。詳細については、テーブルの自動エンベディングを生成して管理するをご覧ください。
次の点を考慮してください。
- ソースデータ列は
TEXT型またはVARCHAR型である必要があります。 - 最適化された AI 関数に入力を提供するエンベディング列は、
REAL[]型またはVECTOR型である必要があります。 - 最適化された関数は、Agent Platform の生成モデルが利用可能なリージョンでのみ使用できます。使用可能なリージョンの一覧については、デプロイとエンドポイントをご覧ください。
- ソースデータ列は
最適化された関数を使用する
最適化された関数を使用するには、ai.if() 関数で PREPARE ステートメントと EXECUTE ステートメントを使用します。最適化された関数の使用方法の例を次に示します。
restaurant_reviewsテーブルを作成します。ソースデータを保持するreview列はTEXT型で、クエリに使用されるreview_embedding列はVECTOR(768)型です。CREATE TABLE restaurant_reviews ( id SERIAL, name VARCHAR(64), city VARCHAR(64), review TEXT, review_embedding VECTOR(768) );ai.if()関数を含むPREPAREステートメントを使用して、クエリで最適化された関数を使用する必要があることを示します。このステートメントにより、バックグラウンドでモデルの非同期トレーニングがトリガーされます。モデルは、次の条件でのみトレーニングされます。
- クエリに
ai.if()関数が 1 つだけあります。 ai.if()がサブクエリ内にありません。
PREPARE positive_reviews_query AS SELECT r.name, r.city FROM restaurant_reviews r WHERE ai.if('Is the following a positive review? Review: ' || r.review, r.review_embedding) GROUP BY r.name, r.city HAVING COUNT(*) > 500;- クエリに
EXECUTEステートメントを使用してクエリを実行します。PREPAREステートメントは現在のセッションに固有であるため、同じ接続でEXECUTEステートメントを実行する必要があります。EXECUTE positive_reviews_query;conn2=> SELECT r.name, r.city FROM restaurant_reviews r WHERE ai.if('Is the following a positive review? Review: ' || r.review, r.review_embedding) GROUP BY r.name, r.city HAVING COUNT(*) > 500;次のいずれかの条件が満たされている場合、トレーニング済みのプロキシモデルは使用されません。
ai.if()で参照されているコンテンツ列またはエンベディング列が変更された。両方の列が同じテーブルに属している必要があります。- コンテンツ列に指定されたプロンプトが変更される。
- クエリの構造が変更され、
query_idが異なります。 - クエリの開始時に、クエリが精度チェックのしきい値を満たしていない。
このような場合、クエリは LLM の使用にフォールバックし、AlloyDB は警告を返します。
省略可。データベース環境全体で精度検証チェックを無効にするには、次のコマンドを実行します。精度チェックはモデルのトレーニング中にも実行されるため、この操作が必要です。
ALTER DATABASE DATABASE_NAME SET google_ml_integration.proxy_models_enable_accuracy_check = off;DATABASE_NAMEは、実際のデータベースの名前に置き換えます。
プロキシモデルを再トレーニングする
基盤となるテーブルデータが大幅に変更された場合は、PREPARE ステートメントを再度実行して、プロキシモデルを再トレーニングできます。クエリを再準備すると、新しいトレーニング リクエストが開始され、既存のプロキシモデルが置き換えられます。
制限事項
ソース コンテンツ列、エンベディング列、または ai.if() 関数に指定されたプロンプトを変更する場合は、新しい PREPARE ステートメントを発行する必要があります。AlloyDB は、プロンプトと入力データの独自の組み合わせの動作を近似するように最適化された関数をトレーニングします。